


在Google Colab上免费运行Mixtral 8x7b
内容提要
本文介绍了如何在Google Colab上使用LLaMA C++库运行Mixtral 8x7b模型,以最大化计算要求下的质量输出。Mixtral 8x7b是由Mistral AI创建的高质量稀疏专家混合(SMoE)模型,具有开放权重,超越了大多数基准测试中的Llama 2 70B,并且推理速度快6倍。Mixtral在大多数标准基准测试中与GPT3.5相媲美,是成本/性能方面最佳的开放权重模型。Mixtral 8x7B模型在处理32k个标记的广泛上下文方面表现出色,并支持多种语言。LLaMA.cpp是一个C/C++库,提供了基于Facebook的LLM架构的高性能接口,可用于文本生成、翻译和问答等任务。LLaMA.cpp支持多种LLM,包括LLaMA、LLaMA 2、Falcon、Alpaca、Mistral 7B、Mixtral 8x7B和GPT4ALL。它与所有操作系统兼容,并且可以在CPU和GPU上运行。
延伸解读
稀疏专家混合架构的效率优势
Mixtral 8x7b采用稀疏专家混合(SMoE)架构,总参数达46.7B,但每个token只激活部分参数,因此实际计算效率相当于12.9B模型。这种设计在提升参数规模的同时控制了成本和延迟,使其在有限算力下仍能提供高质量输出。理解这一点有助于读者明白为何该模型能在Colab等资源受限环境中运行。
量化模型文件的选择与权衡
教程中使用的是Q2_K量化版本的GGUF模型文件,这种低精度量化能显著减少内存占用,使模型能在Colab的有限资源下加载。但量化会损失一定的模型精度,可能影响生成质量。读者需注意,若追求更高输出质量,可尝试更高精度的量化版本,但需确保硬件资源足够。
Colab环境下的网络配置要点
在Colab中运行LLaMA C++服务器时,直接生成的localhost地址无法从外部访问,必须通过Colab的kernel proxy端口获取全局链接。教程中特别强调代理端口号(6589)需与服务器启动端口一致,这是成功访问Web应用的关键。这一步骤容易出错,读者应仔细核对端口设置。
适用场景与性能边界
Mixtral 8x7b在多数基准测试中超越Llama 2 70B,推理速度快6倍,并支持32k上下文和多语言。但教程中的配置(如-ngl 27、-c 2048)限制了GPU卸载层数和上下文长度,实际性能可能低于模型理论值。该方案适合资源有限的用户进行实验和轻量级交互,而非高负载生产环境。
Q&A
Mixtral 8x7b 是什么模型?它有什么特点?
Mixtral 8x7b 是由 Mistral AI 创建的高质量稀疏专家混合(SMoE)模型,具有开放权重,采用 Apache 2.0 许可证。它在大多数基准测试中超越 Llama 2 70B,推理速度快 6 倍,并且与 GPT3.5 相媲美,是成本/性能最佳的开放权重模型。它支持 32k 标记的上下文和多语言(英语、法语、意大利语、德语、西班牙语),在代码生成方面表现强劲,并可微调为指令遵循模型。
如何在 Google Colab 上使用 LLaMA C++ 运行 Mixtral 8x7b?
步骤:1. 克隆 llama.cpp 仓库:!git clone --depth 1 https://github.com/ggerganov/llama.cpp.git;2. 进入目录并安装:%cd llama.cpp !make LLAMA_CUBLAS=1;3. 从 Hugging Face 下载模型文件(如 mixtral-8x7b-instruct-v0.1.Q2_K.gguf);4. 获取 Colab 代理端口链接:from google.colab.output import eval_js print(eval_js("google.colab.kernel.proxyPort(6589)"));5. 运行服务器:!./server -m mixtral-8x7b-instruct-v0.1.Q2_K.gguf -ngl 27 -c 2048 --port 6589;6. 通过代理链接访问聊天 web 应用。
LLaMA.cpp 是什么?它支持哪些模型和平台?
LLaMA.cpp 是一个基于 Facebook LLM 架构的高性能 C/C++ 库,轻量高效,可用于文本生成、翻译和问答等任务。它支持多种 LLM,包括 LLaMA、LLaMA 2、Falcon、Alpaca、Mistral 7B、Mixtral 8x7B 和 GPT4ALL。它与所有操作系统兼容,并可在 CPU 和 GPU 上运行。
Mixtral 8x7b 的稀疏专家混合(SMoE)架构是如何工作的?
Mixtral 8x7B 使用仅解码器的稀疏专家混合网络。它包含一个前馈块,从 8 组参数中选择,通过路由器网络为每个标记选择两组参数,并将它们的输出相加。这种方法增加了模型参数量,同时管理了成本和延迟,使其效率相当于 12.9B 模型,尽管总参数量为 46.7B。
运行 Mixtral 8x7b 需要多少计算资源?可以在普通电脑上运行吗?
Mixtral 8x7b 设计为在有限计算资源下高效运行。通过 LLaMA.cpp 库,它可以在 CPU 和 GPU 上运行,并且可以在 Google Colab 的免费云 compute 或笔记本电脑上运行。模型文件有不同量化版本(如 Q2_K),可进一步降低内存需求。因此,即使没有大量计算资源,也可以实验大型语言模型。
如何自定义 LLaMA C++ 的聊天 web 应用?
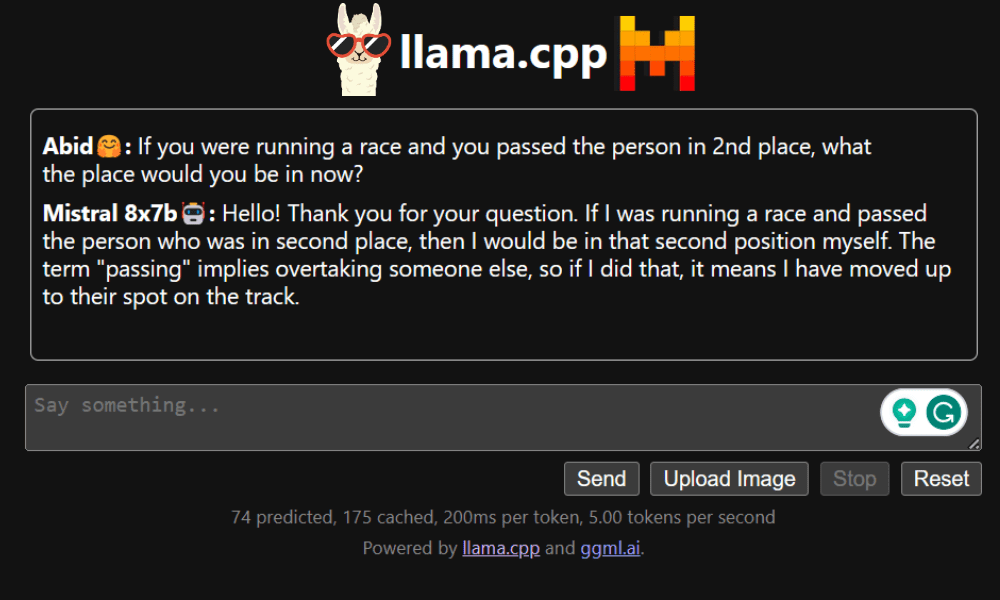
在运行服务器后,通过代理链接访问聊天 web 应用。在开始聊天前,需要自定义:在提示部分将 "LLaMA" 替换为你的模型名称,并修改用户名和机器人名称以区分生成的回复。然后滚动到聊天区域输入内容即可开始对话。
