
用多模态技术在多媒体系统中实现场景分类
内容提要
本文研究了多模态算法在多媒体系统中进行视频场景分类的应用,通过识别单帧图像特征进行分类。clip和blip是两种经典的多模态算法,能够处理图像和文本数据,并在多种任务上展现出卓越性能。实验结果表明,基于clip的方案在准确率和性能上优于传统算法。未来,多媒体实验室将继续探索引入更多大模型和多模态技术,提高整个系统的性能。
延伸解读
多模态方案在业务中的落地价值
文章指出,视频场景分类可作为内容自适应转码、画质智能修复和视频质量评估等业务的前置算法。通过识别单帧图像特征,系统能针对不同场景自适应选择处理策略,从而提升效果。例如在画质修复中,不同场景画质差异大,统一处理并非最优,分类后能实现更精细的增强。这体现了多模态技术在实际业务中的实用价值。
CLIP方案相比传统方法的效率优势
实验对比显示,基于CLIP结合全连接层的方案在准确率、精确率、召回率和F1分数上均优于ResNet 50和CLIP零样本方案。训练效率上,ResNet 50训练300个epoch约需180分钟,而CLIP方案训练600个epoch仅需约125秒即可收敛。这表明CLIP预训练特征提取器能大幅减少训练时间和数据标注需求,适合业务快速迭代。
零样本方案的适用场景与局限
文章提到,CLIP的零样本方案无需训练数据即可对图像进行分类,但准确率有限,且依赖人工设计prompt,可能不符合业务需求。因此,它适用于对准确率要求不高且缺乏训练数据的场景。若追求更高精度,仍需结合少量标注数据对CLIP特征进行微调,并通过数据清洗迭代优化,以平衡成本与效果。
未来方向:大模型与多模态融合
文章最后指出,多媒体实验室将继续探索引入更多大模型和多模态技术,以提升系统性能。当前方案已结合场景切分与图像分类,未来可进一步利用多模态算法处理更复杂的业务需求,如更精准的画质和码率控制。这反映了多模态技术在多媒体系统中持续演进和应用的潜力。
Q&A
多模态技术在视频场景分类中有什么应用?
多模态技术结合图像、文本和音频等多种数据类型,提高了视频场景分类的准确性和效率。
clip和blip算法有什么区别?
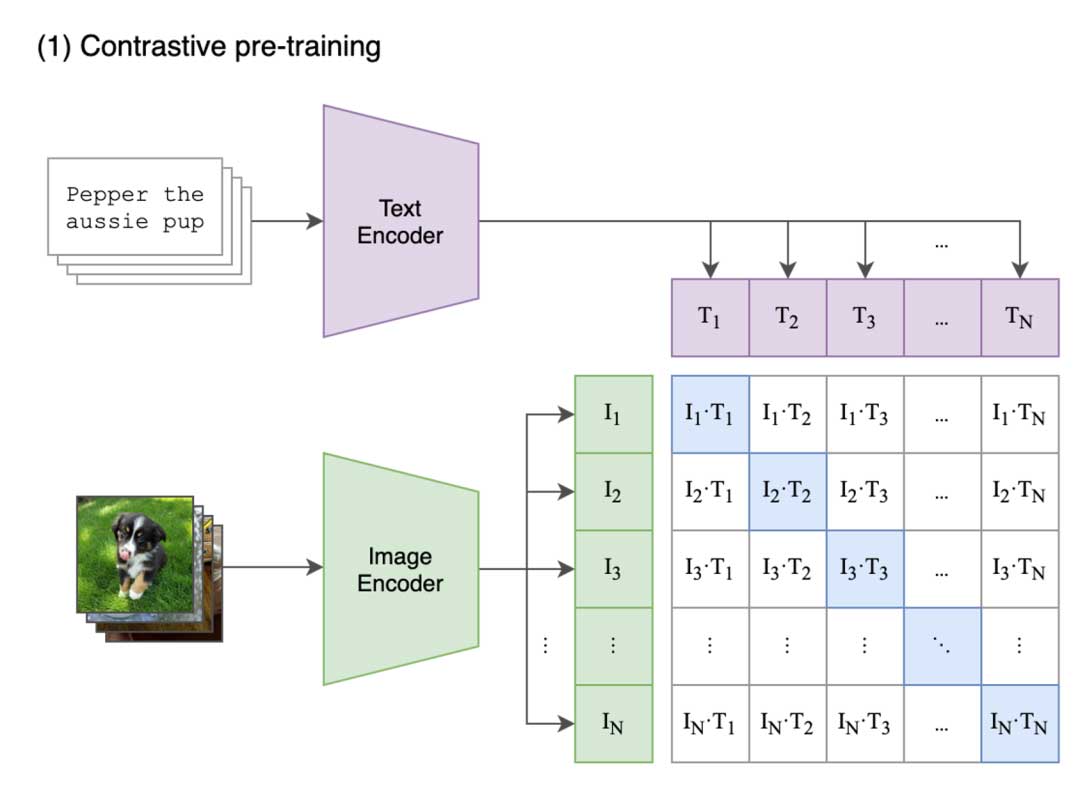
clip通过对比学习将图像和文本映射到共享的多模态向量空间,而blip则是一个统一视觉语言理解生成的预训练框架,适应更广泛的下游任务。
传统图像分类方法的局限性是什么?
传统方法通常需要大量手工调整和参数优化,且在处理大规模数据集时性能有限。
如何提高视频分类系统的效率?
通过结合场景切分技术和图像分类技术,可以高效地对视频内容进行分类,满足多样化的应用场景。
clip算法在分类任务中的优势是什么?
clip算法具备强大的跨模态理解能力,能够在零样本任务中表现出色,并且通过设置提示词实现灵活的分类标签。
未来多媒体实验室的研究方向是什么?
未来多媒体实验室将继续探索引入更多大模型和多模态技术,以提升整个系统的性能。
