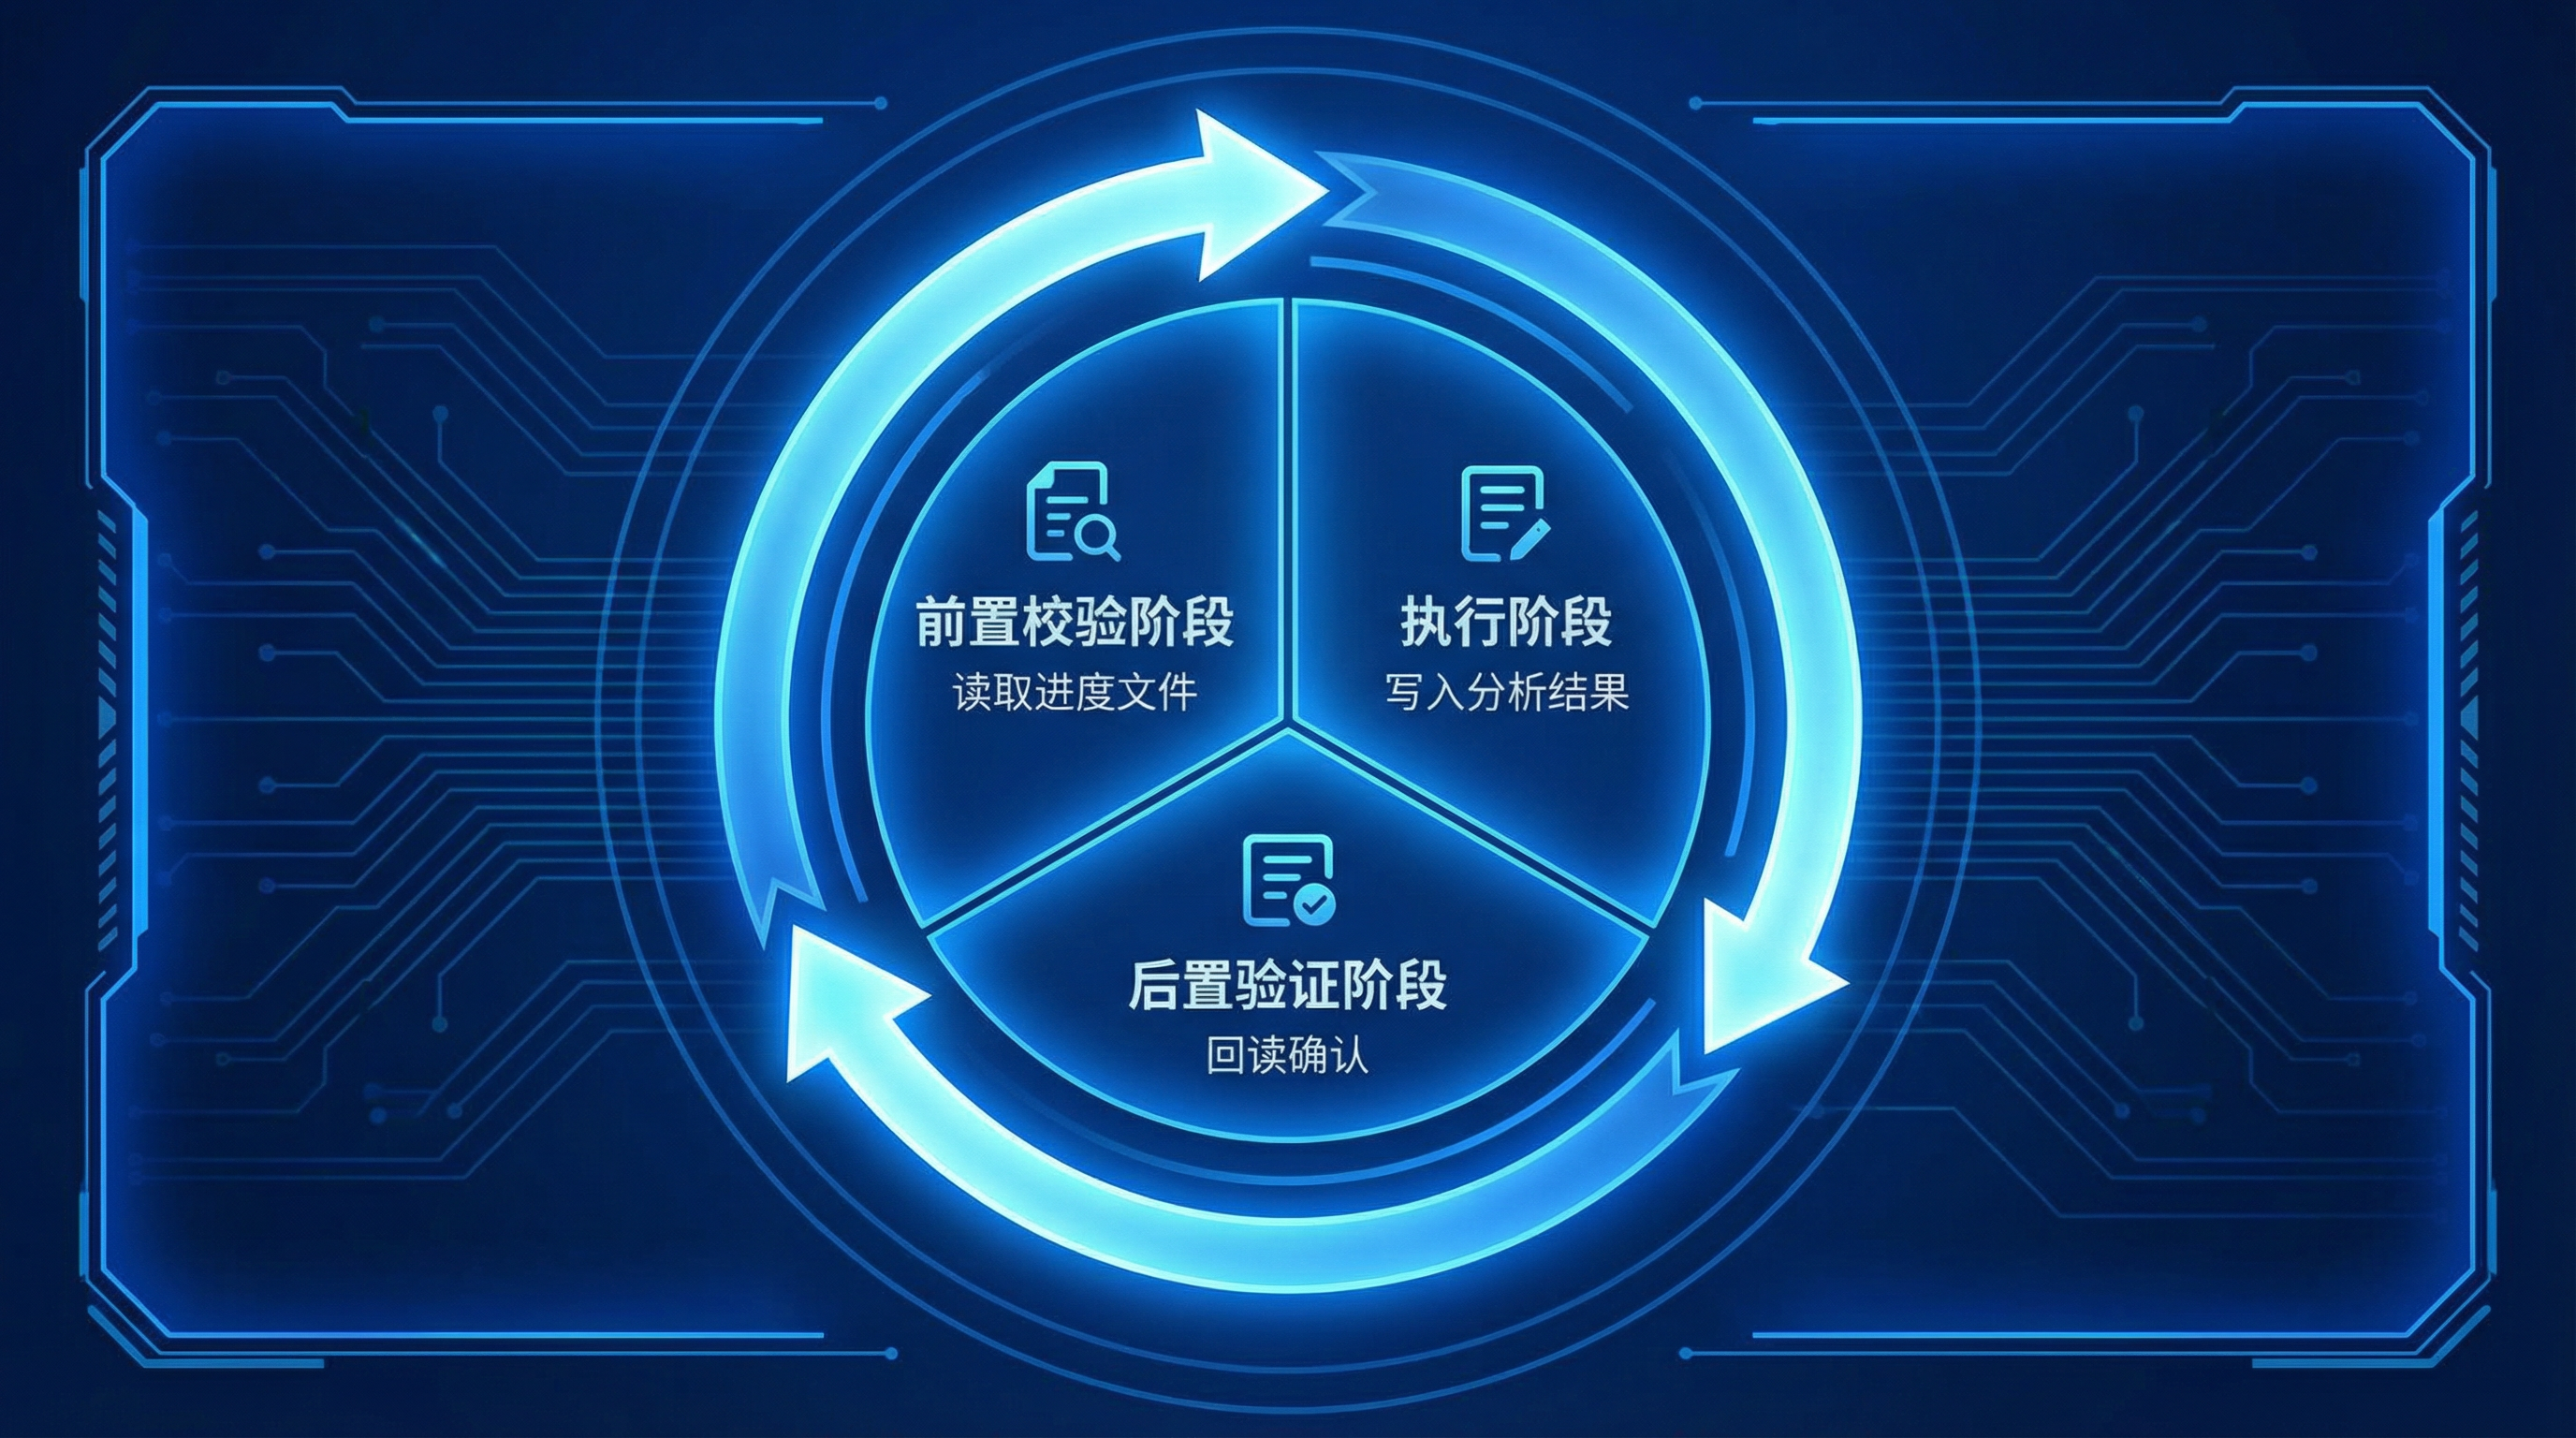
本文讨论如何系统提升 ai_extract 文档抽取准确率。核心观点:单字段修补可能引发其他字段回归,需建立可重复评估流程。建议用 schema 描述约束字段规则、全局提示处理文档级逻辑,复杂表格用 precision mode,引用定位错误来源。用 MLflow Prompt Registry 版本化提示与 schema,固定测试集评估准确率、覆盖率与波动,人工把关上线。Genie Code 可自动化评估与迭代循环。
OpenAI称新模型GPT-6.1 Sol在COBOL迁移测试中准确率显著提升,低推理强度下达86.6%,高推理强度下达97.9%,且成本更低,但测试细节未公开,无法独立验证。另一基准MultiLangBench用20种语言构建SQLite兼容数据库,GPT-6 Astra平均通过率87.4%。OpenAI承认迁移到生产环境仍需专家审查。
谷歌DeepMind与谷歌研究院联合世界资源研究所等机构发布“森林类型图”(ForTy 2020),以10米分辨率将全球土地分为六类森林与土地利用类型,并推出2017至2025年时间序列,首次显示森林消失后被什么取代(如种植园或农场)。模型经9000多个随机样点验证,森林类型识别准确率约90%,区分森林与非森林达95%。该地图免费开放,可支持欧盟无毁林法规、企业供应链核查和森林保护。
DeepSeek发布V4.1-Flash-1017,主打缩短任务耗时与输出长度,开放权重可自托管。作者将其与Claude Haiku 5.5对比修Bug、数据库查询、工单分类三项测试:DeepSeek在修Bug和分类上略胜,查询打平;Haiku工具类任务更快,DeepSeek长提示更快。成本上DeepSeek约0.07美元,Haiku约0.30美元,差距主要来自长提示触发高价档。作者倾向DeepSeek,但提醒仅单次测试,需按自身负载验证。
蚂蚁数科发布决策模型LingDT-Decision-1.0,提供4B和27B版本,专为产业AI高频决策任务设计,直接限定选项判断而非生成文本。相比大模型,Token消耗降低超90%,响应快10倍。首创原生多选与按序决策能力,适配复杂业务流程。在23项基准评测中综合评分领先,27B版本同参数准确率最高,已在客服、风控、金融等场景测试。
谷歌Gemini 4 Argon在18项基准测试中14项领先Claude Opus 5.5,且限时半价。作者实测三项任务:代码审查两者持平,Argon更便宜;规格测试因一行代码错误失败;长上下文测试中Argon推理错误严重、回答草率。结论:Argon虽便宜,但可靠性不足,不建议使用。
OpenAI发布GPT-6.1 Sol,宣称以Astra五分之一的价格提供接近其智能水平。作者通过三项测试对比,发现GPT-6.1 Sol准确率与Astra持平,速度更快,总成本仅为Astra的18%,验证了OpenAI的定价与性能主张。
开源项目 jeff 使用 4 亿参数 GLiFormer 模型在本地 GPU 进行文本分类,完整复刻 TypeSafe 的 jev API 协议,仅需修改 TYPESAFE_BASE_URL 环境变量即可零代码迁移,成本从每百万次 15.6 美元降至 2.6 美元。简单情感和情绪分类准确率几乎追平 jev,但 AG News 主题分类和反讽检测落后约 15 个百分点。推荐使用 Modal 平台的 L4 GPU 部署,每秒约处理 50 次请求。
TypeSafe推出判断模型Jev,专用于分类判断而非文本生成,可核查事实、校验引用、重排搜索结果、归类笔记、诊断智能体失败原因。其响应仅0.35至0.52秒,比Gemini 3.5 Flash快三到八倍,准确率多数持平或略逊。Jev让智能体实时自检成为可能,但准确率约79%,复杂长轨迹表现仍待验证。
2026年9月,前OpenAI研究员阿尔梅达发布决策模型Jev。在1565封商务邮件分类测试中,Jev准确率为96.4%,略低于Gemini的98.5%,但响应仅需70至500毫秒,成本极低。Jev采用并行采样与校准置信度,输出结构化判断,适合生产环境。文章指出,错误分布和可预测性比整体准确率更重要,Jev在速度、成本与工程可控性上占优。
Speechmatics 的 Linden 模型现可通过 LiveKit Inference 平台使用,开发者无需额外申请密钥即可快速切换。Linden 支持 55 种以上语言,擅长处理浓重口音、嘈杂环境和字母数字识别,提升语音智能体在真实场景中的转写准确性。boost.ai 已将其投入生产,LiveKit 提供统一 API 和计费,简化开发流程。
谷歌发布Gemini 3.5 Transcribe语音转文本模型,提升实时转写准确率、降低延迟,支持85种语言,自动去除口头语并修正表达,可区分说话者。流式转写延迟低于1秒,错误率低至2.6%。已通过Gemini API公开预览,未来支持Chrome浏览器。
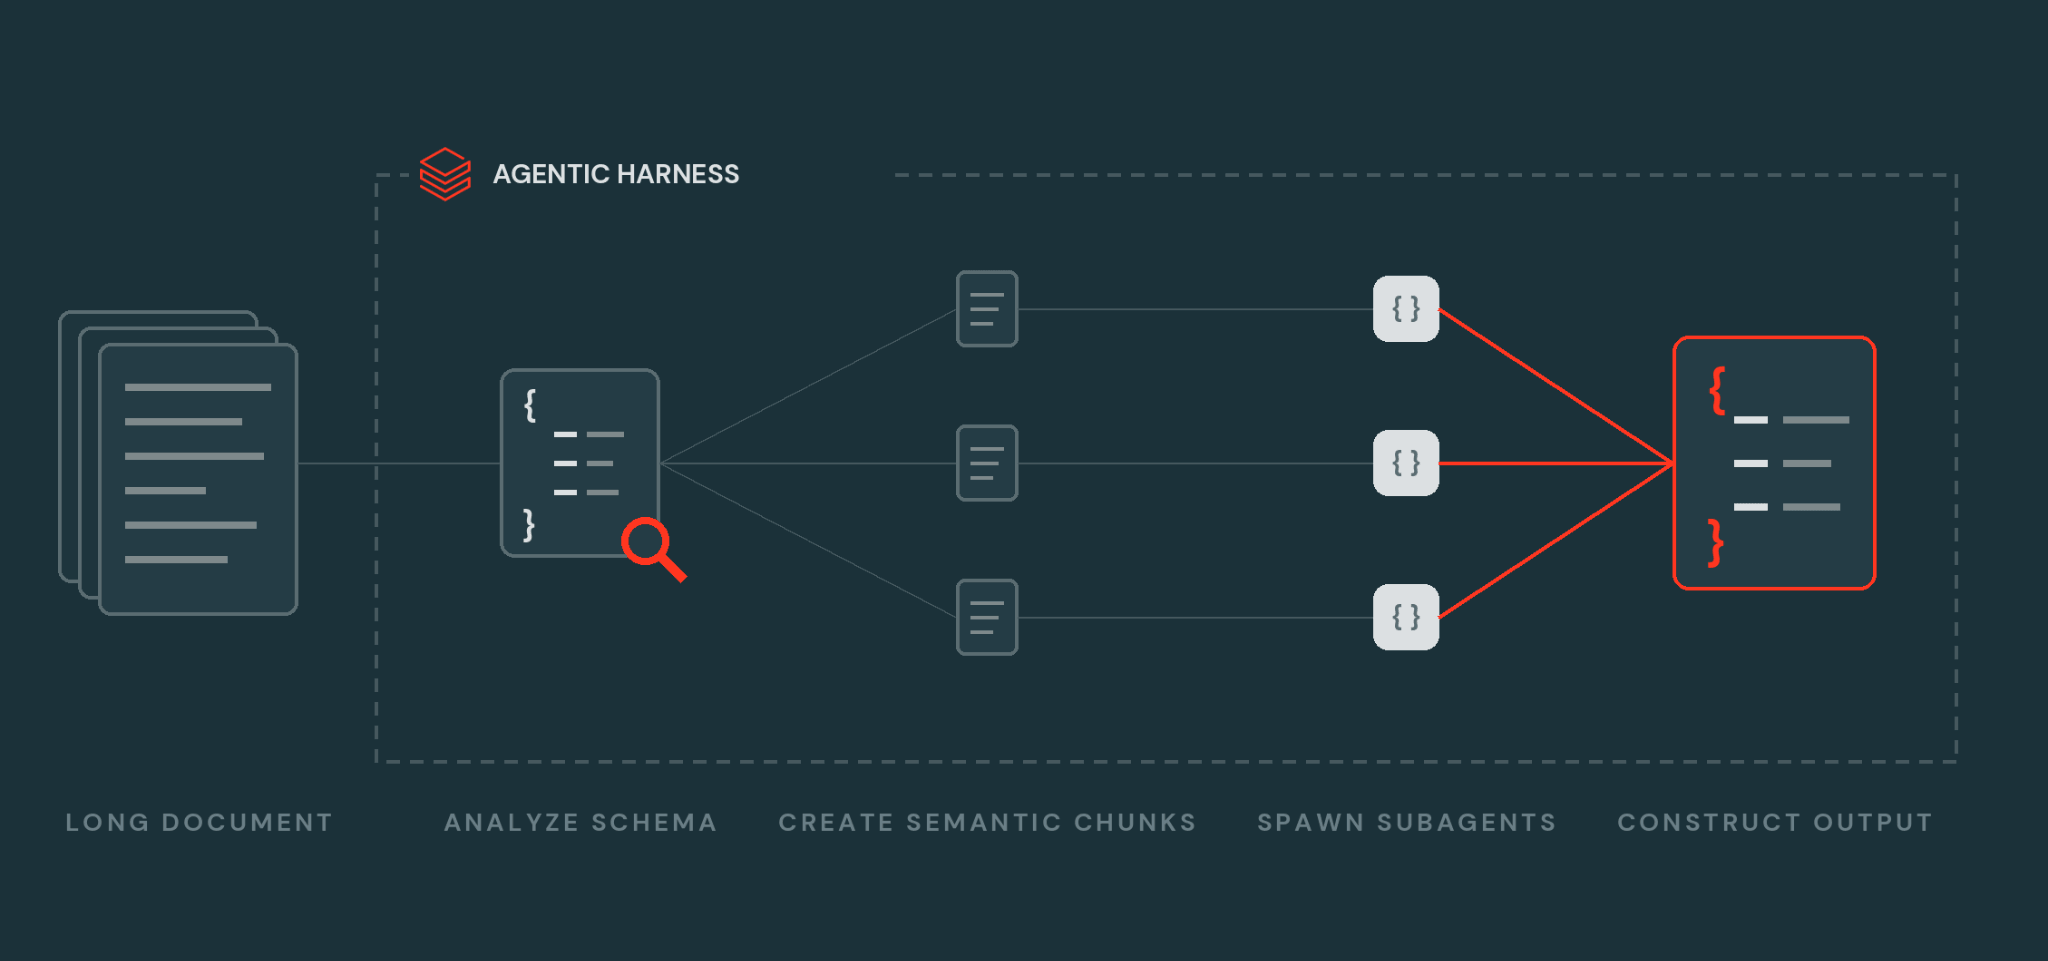
Databricks推出AI Extract的Precision Mode,结合定制模型与智能代理,解决长文档、复杂模式提取难题。在约9000份文档测试中,准确率达94.7%,超越GPT-5.6 Sol等前沿模型7个百分点,适用于金融、医疗等领域,现已开放使用。
本文介绍RAG流水线中的重排序(reranking)层,旨在解决检索结果中相关文档排名靠后的问题。文章比较了交叉编码器、双编码器和LLM重排序器三种模型类型,强调选择需权衡延迟、成本和语言覆盖。生产实践中,建议采用混合检索提升召回率,并注意校准阈值、控制成本,Redis Iris可集成这些功能以优化性能。
Databricks团队在401个真实任务上评估了Genie Code与三款主流编码代理,结果显示Genie Code准确率最高(76.6%),成本最低(每任务0.55美元),约为竞争对手一半。其优势在于通过语义搜索和持久记忆高效定位数据,平均仅需8.3次工具调用,避免了低效探索。研究挑战了“更高成本带来更高准确性”的传统观念,强调数据代理需适应动态环境。
2026年,开源小模型通过平衡强化学习(RL)与监督微调(SFT),可超越闭源大模型。SFT提供战略方向,RL负责战术创新,两者失衡会导致模型僵化或混乱。GRPO、RULER、ART等工具优化平衡,使3B模型准确率从62%升至89%,突破纯SFT的72%上限,实现高效进化。
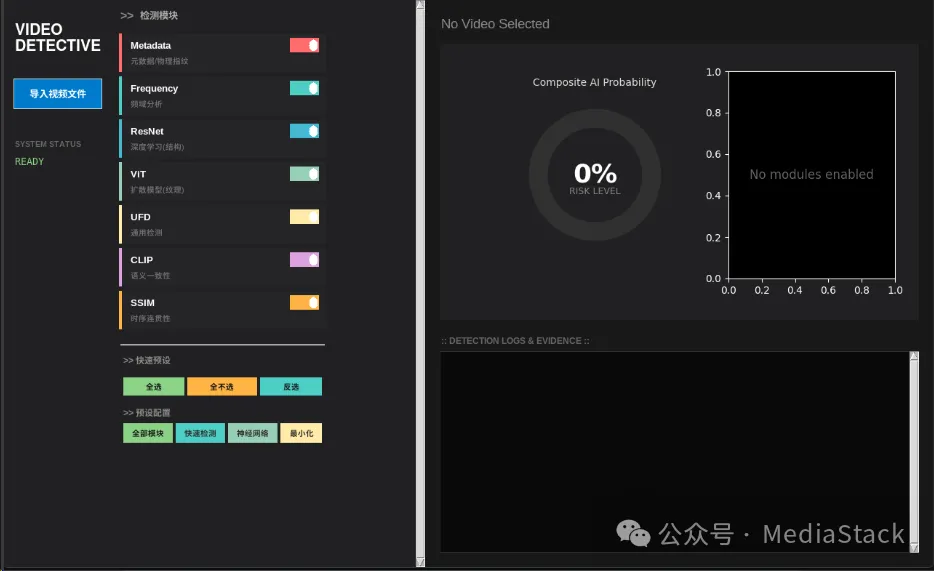
英伟达推出合成视频检测器NIM,宣称可逐帧检测AI生成视频,准确率最高92%。但实际应用中面临平台压缩、局部修改、转场剪辑及不同生成模型等挑战,检测准确率可能受影响。作者认为该工具是网络防御的重要进展,但需实际验证,建议将其作为人工核验的辅助信号,而非直接判定依据。
大模型Skill开发中,核心术语选择影响巨大:用“漏洞”准确率89.3%,用“风险”仅62.1%。原因是“风险”语义宽泛,触发模型发散性输出,突破约束。构建高质量Skill需结构化工作流、校验循环、定义文件和定制工具。应选窄边界词,用否定清单、硬输出格式锚定边界,并可用语义陷阱检测器自动化排查。
上海科技大学的论文《Safety Sentry》提出了一种新的安全审查方法,将二元分类改为三向路由决策(执行、请求确认、拒绝)。该方法通过轻量级guard model实现上下文感知的细粒度审查,能够更好地区分低、中、高风险操作,提高安全性与效率。实验结果表明,该方法在准确率和召回率上优于传统方法,且具有较强的部署灵活性,适应不同风险容忍度需求。
阿里研究团队在ACL 2026会议上获得最佳资源论文奖,研究揭示了Agent在复杂规则推理中的缺陷,并提出了HSCodeComp基准。测试结果显示,现有Agent的准确率仅为45%,远低于人类专家的95%。研究指出,推理链过长和领域知识不足是主要问题,旨在提升Agent的能力。基于此成果设计的Agent在HSCodeComp测试中的准确率达65%。
完成下面两步后,将自动完成登录并继续当前操作。