

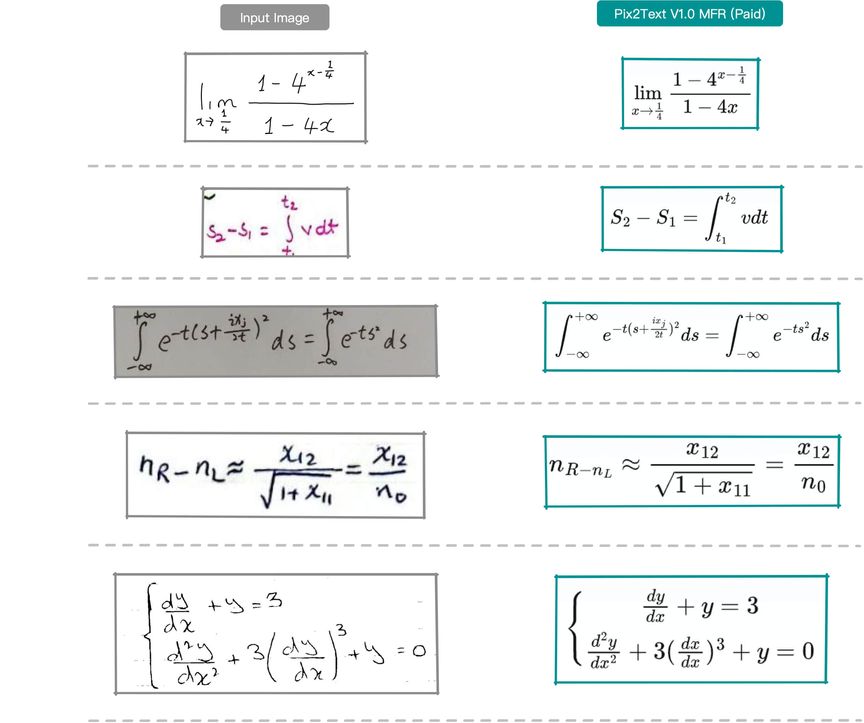

Pix2Text V1.0 新版发布,带来了最好的开源数学公式识别模型
内容提要
Pix2Text (P2T) V1.0 发布,新增的数学公式识别模型(MFR)显著提升了识别精度,成为开源领域的领先工具。该工具支持识别图片中的文字和数学公式,并输出 LaTeX 表达式。P2T 采用小模型和开源策略,适合在普通 CPU 上运行。新版本移除了对旧项目的依赖,使用微软的 TrOCR 架构,识别效果优于之前的模型。用户可免费使用网页版,每天识别 10000 个字符。
延伸解读
小模型路线与CPU部署优势
Pix2Text坚持小模型和开源策略,模型大小控制在普通CPU上可运行,这与Nougat、Texify等大模型形成鲜明对比。大模型通常需要GPU才能批量运行,且模型文件约1G,而P2T更适合资源有限的环境。对于需要本地部署或硬件条件一般的用户,P2T提供了更实用的选择。
精度对比与测试方法
P2T V1.0的MFR模型在485张真实用户图片测试集上,CER显著优于Latex-OCR、Texify及之前版本。测试数据来自用户上传,经MFD检测和人工标注,涵盖单字母到矩阵等多样公式。标准化处理避免了空格等因素干扰。结果显示,开源免费版已大幅超越旧付费模型,付费版精度进一步提升。
付费模型授权与使用限制
P2T提供个人版和企业版付费模型。个人版仅限个人使用,不可商用,且只含ONNX版本。企业Pro版一次性购买,允许内部使用或对外免费服务,但不允许付费服务;企业Plus版一年内可获取新模型,提供PyTorch版本,允许对外付费服务。购买前需确保开源模型能跑通,否则付费模型也无法使用。
网页版免费额度与使用建议
P2T网页版每人每天可免费识别10000个字符,适合日常使用,但禁止批量调用以免影响他人。网页版目前仅支持简体中文和英文,其他语言需使用Hugging Face在线Demo,但Demo硬件配置较低,速度较慢。对于中英文图片,建议优先使用网页版以获得更好体验。
Q&A
Pix2Text V1.0 的主要功能是什么?
Pix2Text V1.0 主要用于识别图片中的文字和数学公式,并输出 LaTeX 表达式。
Pix2Text V1.0 的数学公式识别模型有什么优势?
Pix2Text V1.0 的数学公式识别模型(MFR)显著提升了识别精度,优于之前的模型。
如何使用 Pix2Text 的网页版?
用户可以免费使用 Pix2Text 的网页版,每天识别 10000 个字符,适合普通 CPU 运行。
Pix2Text V1.0 采用了什么技术架构?
Pix2Text V1.0 采用了微软的 TrOCR 架构,移除了对旧项目的依赖。
Pix2Text V1.0 的付费模型与免费模型有什么区别?
付费模型在识别精度上优于免费模型,提供更高的识别效果。
Pix2Text V1.0 支持哪些语言的识别?
Pix2Text V1.0 的文字识别引擎支持 80 多种语言,包括简体中文和英文。
