


Liquid AI 发布 LFM3:6 个开放权重、2B 级多模态模型
内容提要
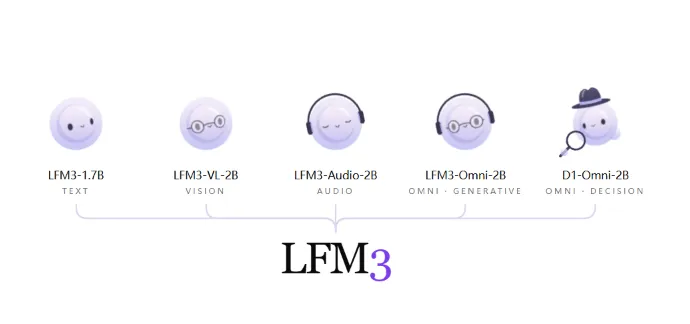
Liquid AI 发布 LFM3 系列,包含 6 个开放权重的 2B 级模型,共享卷积、滑动窗口注意力与全局注意力组成的三混合骨干网络,覆盖文本、视觉、音频、全模态及决策任务。其中 LFM3-1.7B 支持 256K 上下文,4-bit 量化约需 1GB 内存,可在手机和笔记本上运行。该模型在 BFCL V4、WebArena-Verified 等智能体基准上超过 Qwen3.5-9B,但知识与编程能力仍是短板。年营收 1000 万美元以内可免费商用。
延伸解读
端侧部署的取舍:内存与上下文
LFM3-1.7B 在 4-bit 量化下约需 1GB 内存,适合手机和笔记本运行,但这是以短上下文为代价的。文章实测显示,完整 128K 上下文需要 1.6GB 的 KV cache,远高于模型权重本身。因此,若要在端侧使用长上下文,需预留额外内存;否则应限制上下文长度,或选择 32K 等更实际的配置。
基准优势集中在智能体任务
LFM3-1.7B 在 BFCL V4、WebArena-Verified 和 AutomationBench 上超过 Qwen3.5-9B,说明其针对智能体场景的后训练和架构优化有效。但文章也指出,知识与编程仍是短板:GPQA Diamond 和 SWE-bench Verified 均落后于更大模型。接入检索后知识差距会缩小,但编程能力仍需依赖更大模型或专门微调。
许可门槛与竞品对比
LFM3 采用 LFM Open License v1.0,年营收 1000 万美元以内可免费商用,超过则需另行授权。与 Apache 2.0 的 MiniCPM5-2B、Qwen3.5-4B 和 Gemma 4 E4B 相比,这一门槛需纳入商业评估。此外,文章中的对比数据多来自 Liquid 自家评测,跨厂商基准可能存在差异,读者应结合自身任务验证。
Q&A
Liquid AI 发布的 LFM3 系列包含哪些模型?
LFM3 系列包含 6 个开放权重的 2B 级模型:LFM3-1.7B(文本)、LFM3-VL-2B(视觉)、LFM3-Audio-2B(音频)、LFM3-Omni-2B(全模态)、d1-2B 和 d1-Omni-2B(决策模型)。
LFM3 的三混合架构具体由哪些组件构成?
三混合骨干网络在 24 层中混合了 3 种算子:13 层门控短卷积、5 层滑动窗口注意力(窗口 256 token)和 6 层全局注意力。卷积核从 3 扩大到 7,并引入逐头 sigmoid 门控、部分 RoPE 和 sandwich norm。
LFM3-1.7B 在智能体任务上的表现如何?
在智能体基准上,LFM3-1.7B 超过 Qwen3.5-9B:WebArena-Verified 得 38.42(Qwen3.5-9B 为 28.94),BFCL V4 得 71.39(Qwen3.5-9B 为 62.83),AutomationBench 得 41.29(Qwen3.5-9B 为 15.10)。
LFM3-1.7B 有哪些明显的性能短板?
知识与编程能力是短板:GPQA Diamond 得 63.37(Qwen3.5-9B 为 80.40),SWE-bench Verified 得 43.40(Qwen3.5-9B 为 51.20),Humanity’s Last Exam 无工具仅 7.17。接入检索后 HLE 可提升至 13.90。
LFM3 模型可以在手机或笔记本上运行吗?需要多少内存?
可以。LFM3-1.7B 在 4-bit 量化下约需 1 GB 内存,能在手机和笔记本上运行。提供 GGUF、MLX、ONNX、FP8 和 NVFP4 格式权重,支持 llama.cpp、MLX、Ollama 等运行时。
LFM3 的商用许可条件是什么?
LFM3 采用 LFM Open License v1.0,年营收 1000 万美元以内的企业可免费商用。
