

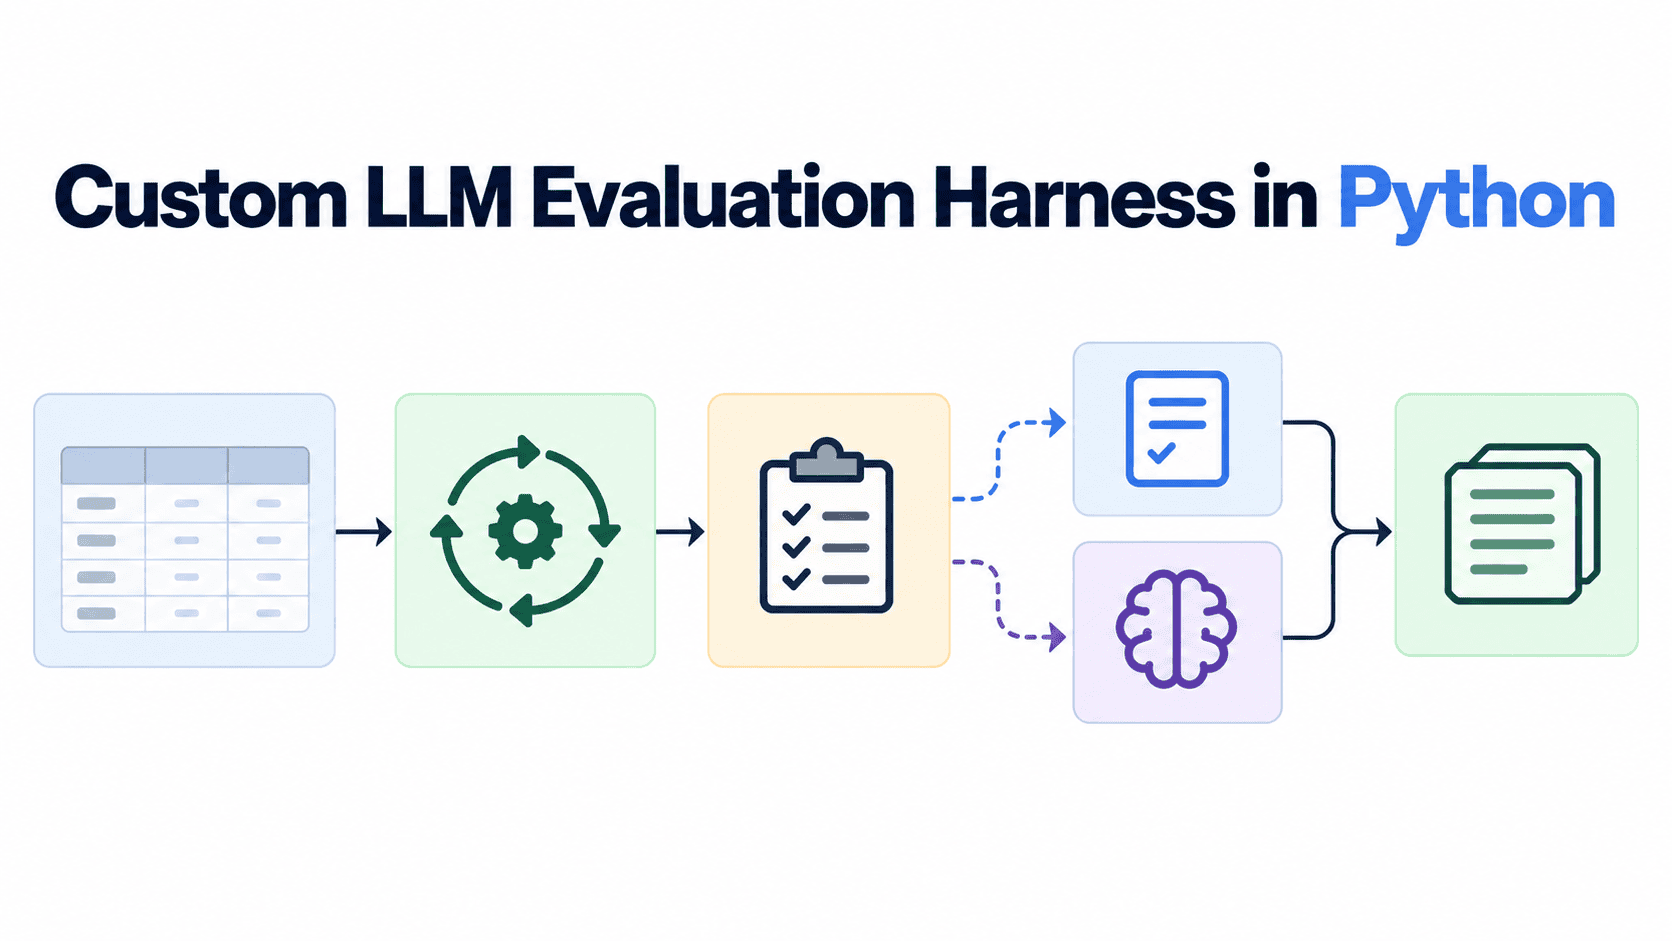

用 Python 从零构建自定义 LLM 评估工具
内容提要
本文介绍如何用 Python 从零构建自定义 LLM 评估工具,包含四个模块:黄金数据集(基于真实用户输入和已知失败案例)、异步推理运行器(用 LiteLLM 调用模型)、评判层(确定性匹配或 LLM 评判,用 Pydantic 约束输出)、日志记录(追加写入 JSONL,崩溃安全)。推理与评分分离,便于重新评分而无需重跑 API。还给出温度设 0、并发限制、先确定性后 LLM 评判等排错建议。
延伸解读
为什么需要自定义评估工具
公开基准如 MMLU 或 GSM8K 衡量的是通用能力,无法判断你的客服代理是否遵循拒绝策略,或 RAG 管道是否拉取正确上下文。自定义评估工具围绕你的测试用例和评分标准构建,能针对特定领域和业务逻辑进行测试,这是通用基准无法替代的。
推理与评分分离的实用价值
将推理运行器与评判层分离,意味着原始输出被独立记录。当后续调整评判标准或评分规则时,可以直接对已保存的原始输出重新评分,无需再次调用模型 API。对于使用付费 API 的大规模数据集,这能显著节省时间和成本。
评判策略的选择与成本控制
确定性评判快速、廉价且一致,适合检查特定字符串或格式;LLM 评判能处理语义正确性,但更慢且增加 API 成本。建议先运行确定性评分,仅将失败案例路由给 LLM 评判,这样大多数简单案例无需额外 API 调用,从而控制成本。
排错与稳定性建议
LLM 评判默认非确定性,设置 temperature=0 可减少分数波动。遇到速率限制时,用 asyncio.Semaphore 限制并发请求数。对于确定性评判,需检查 expected_concept 字符串是否包含可能误匹配的模糊子串,以确保评分准确。
Q&A
为什么需要自己构建 LLM 评估工具,而不是直接用 MMLU 或 GSM8K 这类公开基准?
公开基准如 MMLU 或 GSM8K 衡量的是通用能力,无法告诉你客服代理是否遵守拒绝策略,或 RAG 管道是否针对特定领域拉取了正确上下文。因此需要基于自己的测试用例和评分标准构建可重复的评估管道。
构建自定义 LLM 评估工具需要哪些 Python 依赖?
需要 Python 3.10 或更高版本(主要为了原生 asyncio 支持),以及两个第三方库:LiteLLM 和 Pydantic。LiteLLM 提供统一接口调用 OpenAI、Anthropic、Google 等模型后端;Pydantic 用于强制评判层返回结构化输出。标准库使用 asyncio 处理并发,json 用于日志记录。
如何构建黄金数据集?应该包含多少测试用例?
黄金数据集是结构化测试用例列表,每个用例包含唯一 id、输入提示和预期概念(expected_concept)。建议从真实用户日志或已知失败模式中提取 20 到 50 个用例,而不是自己编造。合成用例往往集中在正常路径,真实用户输入更杂乱,正是评估工具需要捕捉的。expected_concept 应简短明确,避免模糊期望导致评分不可靠。
推理运行器如何实现并发调用?有哪些可靠性设置?
推理运行器使用 LiteLLM 的异步 acompletion 方法,通过 asyncio.gather 并发运行所有用例。可靠性设置包括 num_retries=3 和 timeout=30,这是生产评估运行的最低可行设置。运行器只返回原始输出,不附加评分逻辑,这种分离是故意的。
确定性评判和 LLM 评判分别适用于什么场景?如何用 Pydantic 约束 LLM 评判输出?
确定性评判快速、便宜、一致,适用于检查特定字符串、格式或模式。LLM 评判较慢且增加 API 成本,但能处理语义正确性比精确匹配更重要的场景,例如拒绝检查中响应说“此操作将永久删除数据”即使不含“拒绝”一词也应通过。使用 Pydantic 定义 JudgeScore 模型(包含 passed 布尔值和 reason 字符串),并通过 response_format 参数强制 LLM 返回结构化 JSON,避免解析失败。
为什么要把推理和评分分离?日志记录如何实现崩溃安全?
分离推理和评分后,当日志中同时记录 raw_output 和评分时,如果以后改进评判标准,可以重新评分相同的原始输出而无需再次运行推理,节省时间和金钱。日志记录使用追加写入的 JSONL 格式,每行一条 JSON 记录,这种格式是崩溃安全的:如果运行器中途停止,已写入的结果都会保留。
评估过程中遇到评分不一致、速率限制或评判成本过高怎么办?
评分不一致:LLM 评判默认非确定性,设置 temperature=0 减少方差;确定性评判需检查 expected_concept 字符串是否包含可能匹配意外输出的模糊子串。速率限制:LiteLLM 的 num_retries 处理瞬时故障,持续限制需用 asyncio.Semaphore(10) 限制并发请求。评判成本:先运行确定性评分,仅将失败案例路由到 LLM 评判,大多数简单案例无需 API 调用。
