构建全新的 GitHub Copilot 内联建议模型:第二部分
内容提要
GitHub Copilot 将补全、就近编辑和远距离编辑统一为单一三合一模型,减少调用并提升体验。训练中平衡数据分布,优化客户端行为(如推测解码、渐进显示和缓存延迟)。最终模型使忽略率下降10.1%,表明端到端系统协同设计比单独模型更重要。
延伸解读
统一模型如何减少调用并提升体验
文章指出,此前补全、就近编辑和远距离编辑由独立模型处理,一次编辑机会可能触发多次请求。三合一模型将三者统一,单次请求即可考虑全范围编辑行为并决定最佳响应,或串联多个编辑。这大幅减少了模型调用和服务复杂度,但最大收益在于模型能根据上下文选择最合适的编辑,而非受限于系统架构造成的人为边界。
训练数据平衡与客户端行为的关键作用
为训练三合一模型,团队通过蒸馏和LLM过滤收集幽灵文本补全数据,并重新平衡多编辑数据分布。他们发现,幽灵文本过少或模型急于跳离光标会导致更高忽略率,因此专门加入以光标处补全为首个补丁的数据子集。在强化学习中,评分器鼓励编辑序列从最直接的续写开始,再向外扩展,使编辑更少侵入并保持逻辑连贯。
客户端优化:从推测解码到缓存延迟
文章强调,客户端行为与模型同等重要。团队评估了五项客户端优化:推测解码选择在当前行补全以降低延迟;幽灵文本渐进显示先展示相关部分;基于差异的编辑渲染将原始补丁解析为更合适的交互;缓存延迟和防抖设置匹配开发者打字节奏;跨模式忽略建议抑制防止被忽略的幽灵文本在光标移动后重新出现。这些优化共同提升了端到端体验。
忽略率下降10.1%背后的系统协同设计
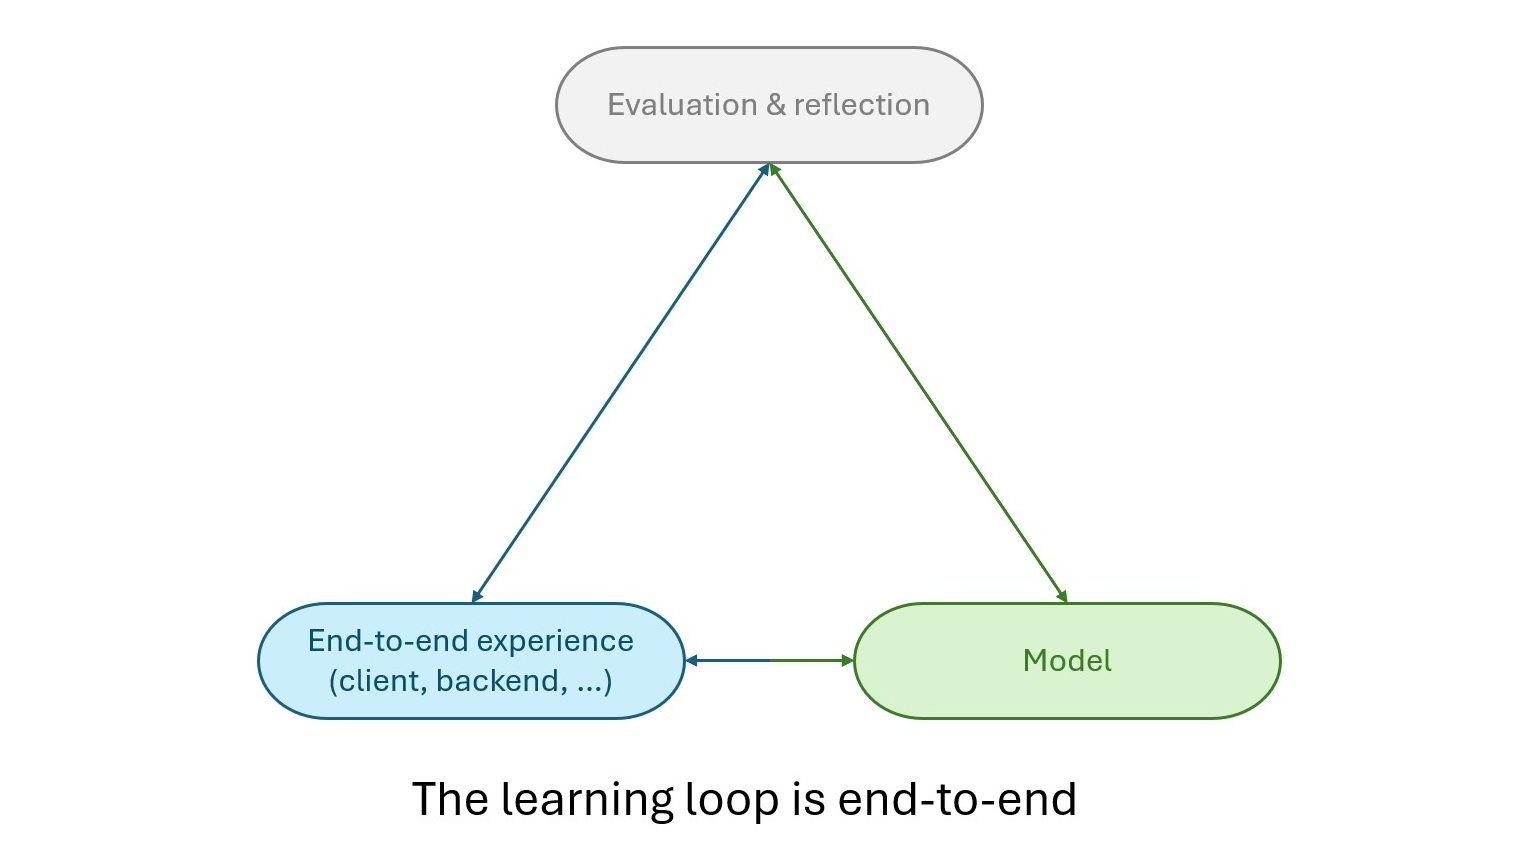
最终三合一模型相比生产基线使忽略率下降10.1%,且关键指标无显著回归。值得注意的是,光标处幽灵文本比例下降了13%,这与之前“更多幽灵文本降低忽略率”的认知不同,说明统一模型能更有效地选择最佳编辑。文章总结,端到端体验才是产品,模型只是复杂系统中的一个组件,训练、评估和编辑器设计需协同演进。
Q&A
GitHub Copilot 的 3-in-1 统一模型是什么?它和之前的模型有什么区别?
3-in-1 统一模型将补全(completion)、就近编辑(NES)和远距离编辑(long-distance NES)三种行为整合到一个模型中。之前这些功能由独立模型处理,现在一个请求就能考虑所有编辑行为并决定最佳响应,减少了模型调用和服务复杂度。
训练 3-in-1 模型时,数据分布是如何调整的?
为了加入补全行为,团队通过蒸馏原始补全模型并用 LLM 评判过滤来收集 ghost text 数据,同时重新平衡从 2-in-1 继承的多编辑数据。他们特别增加了以光标处 ghost text 补全为首个补丁的多编辑数据子集,并在 RL 中保持评分器设计,鼓励编辑序列从最直接的续写开始,再向外扩展。
在客户端优化方面,团队做了哪些关键改进来提升用户体验?
团队评估了五项客户端优化:推测解码(选择在当前行推测补全以降低延迟)、ghost text 渐进显示、基于 diff 的编辑渲染(解析补丁后以合适视图呈现)、缓存延迟和防抖设置调整,以及跨模式忽略建议抑制(防止被忽略的 ghost text 在光标移动后重新出现)。这些优化共同提升了端到端体验。
什么是 nesMimicGhostTextBehavior?它解决了什么问题?
nesMimicGhostTextBehavior 是一个客户端设置,用于控制 NES 模型是否模仿 ghost text 的持久化行为。之前,被忽略的 ghost text 在光标移动后会作为 NES 编辑重新显示,这导致 3-in-1 模型的忽略率虚高。通过禁用此行为,忽略率从增加 15.9% 变为减少 10.1%,差异达 26%。
3-in-1 模型最终在用户指标上取得了什么成果?
与生产环境的 2-in-1 模型加补全模型相比,3-in-1 模型使忽略率下降了 10.1%,且关键指标(如累积保留字符数)没有统计显著的回退。值得注意的是,光标处 ghost text 的比例减少了 13%,但用户满意度反而提升,表明统一模型能更有效地选择最佳编辑。
从 2-in-1 到 3-in-1 的开发过程中,团队学到了哪些关于端到端系统设计的经验?
团队认识到,优秀的模型只是复杂系统的一部分,用户体验、客户端逻辑、网络和服务端逻辑都必须精心设计和优化。客户端行为与模型同样重要,新模型可能需要对客户端设置进行重新评估。端到端体验才是产品,模型和周边体验应共同演进。
