
日均超一万亿 Token:Mooncake 如何驱动 Approaching.AI 的 Token 工厂
内容提要
Approaching.AI 利用 Mooncake 构建大规模 LLM 推理基础设施,日均产出超一万亿 token。通过 SGLang HiCache 与 Mooncake Store,将 KV 缓存从单节点资源变为集群共享池,缓存命中率提升至 90% 以上,并解除缓存对调度的限制。自 2026 年 2 月以来,单节点效率提升三倍,总产能增长三十倍。文章还介绍了架构部署、性能优化、稳定性保障及未来方向。
延伸解读
KV 缓存:从本地优化到关键基础设施
在万亿 token 规模的推理工厂中,KV 缓存不再是可选的局部优化,而是影响整体产能与成本的关键基础设施。文章指出,缓存未命中会导致数百亿 token 的重复计算,浪费算力并推高延迟。Approaching.AI 通过将 KV 缓存从单节点资源转变为集群共享池,使缓存命中率稳定在 90% 以上,从而在固定硬件成本下大幅提升 token 产出。
解耦缓存与调度:提升集群灵活性与韧性
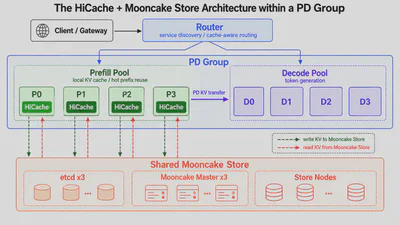
当 KV 缓存私有于节点时,缓存复用与集群调度相互耦合:为提高命中率而将相同前缀请求路由到少数节点,易引发热点和 TTFT 违规;而迁移请求又会导致大量重计算。Mooncake Store 将缓存池化后,调度器可以基于实时负载、节点健康和请求特征做决策,不再受缓存位置束缚,从而增强峰值吞吐、故障韧性和 SLO 保障能力。
性能与稳定的平衡:隐藏远程读取与隔离故障
Mooncake 通过异步预取和 RDMA 并行读取,将远程 KV 缓存读取隐藏在 GPU 计算之后,生产环境平均读取延迟低于 50 毫秒。同时,系统采用组内独立缓存集群、专用网卡、超时熔断和本地优先分配策略,确保缓存故障不会波及推理服务。这些措施在快速扩张期有效控制了故障爆炸半径,为万亿 token 生产提供了稳定基础。
未来方向:SSD 分层、跨组共享与异构支持
文章展望了三个优化方向:引入 SSD 作为第三级缓存,以低成本扩展冷数据容量;通过联邦 Mooncake 实现跨组 KV 缓存复用,提升全局命中率与调度灵活性;支持异构推理集群,让不同加速器分别处理 prefill 和 decode。这些方向旨在进一步解耦计算、传输与缓存,但跨组共享也带来更复杂的元数据管理和故障传播风险,需同步增强隔离与容错。
Q&A
Approaching.AI 如何利用 Mooncake 实现日均超一万亿 Token 的推理?
Approaching.AI 通过 SGLang HiCache 与 Mooncake Store 将 KV 缓存从单节点资源变为集群共享池,缓存命中率提升至 90% 以上,并解除缓存对调度的限制,从而支撑日均超一万亿 Token 的产出。
Mooncake Store 在 Approaching.AI 的推理系统中具体是如何部署的?
Mooncake Store 作为独立 Store Service 运行在所有 prefill 和 decode 节点上。在 decode 节点,主机内存主要供 Mooncake Store 使用;在 prefill 节点,内存由 HiCache 和 Mooncake Store 共享。每个 NUMA 节点固定一个 Store Service,Mooncake Master 配置三个副本(一主两备)部署在三个 GPU 节点上,etcd 也使用三个副本运行在专用 CPU 节点。
引入 Mooncake Store 后,KV 缓存命中率和节点效率提升了多少?
KV 缓存命中率显著提升,持续保持在 90% 以上。自 2026 年 2 月以来,单节点平均 Token 生产效率提升超过三倍,总产能增长超过三十倍。
Mooncake 如何保证在超大规模推理集群中的稳定性?
Mooncake 通过集群隔离(每个组独立部署 Store 集群)、网络隔离(为 Store 分配专用 NIC 和独立 Transfer Engine)、超时与熔断机制(HiCache 读超时后使用已获取数据并重算,Store 集群级熔断可回退到本地缓存),以及优化数据分配策略(优先本地写入,确定性顺序选择节点)来限制故障影响范围,确保缓存服务故障不扩散到推理服务。
Mooncake 在扩展集群规模时遇到了哪些性能瓶颈,如何解决的?
主要瓶颈包括:Master 服务性能问题(通过优化驱逐效率、减少锁竞争、将锁粒度从分片细化到对象解决);Store 节点上下线耗时(优化内存初始化和 RDMA 注册,支持大页,Master 节点移除采用“同步失效、异步清理”两阶段);网络问题(RoCE 网络微突发等,但确认不影响推理指标,更多关注网络稳定性而非性能)。
Mooncake 未来的优化方向有哪些?
未来方向包括:引入 SSD 作为第三级缓存层,异步将冷 KV 缓存从 DRAM 迁移到 SSD;实现联邦 Mooncake,支持跨组 KV 缓存复用;支持异构推理集群,例如 prefill 和 decode 使用不同加速器,进一步解耦计算、传输和缓存。
