


EP229:基于RAG的智能体的8种分块策略
内容提要
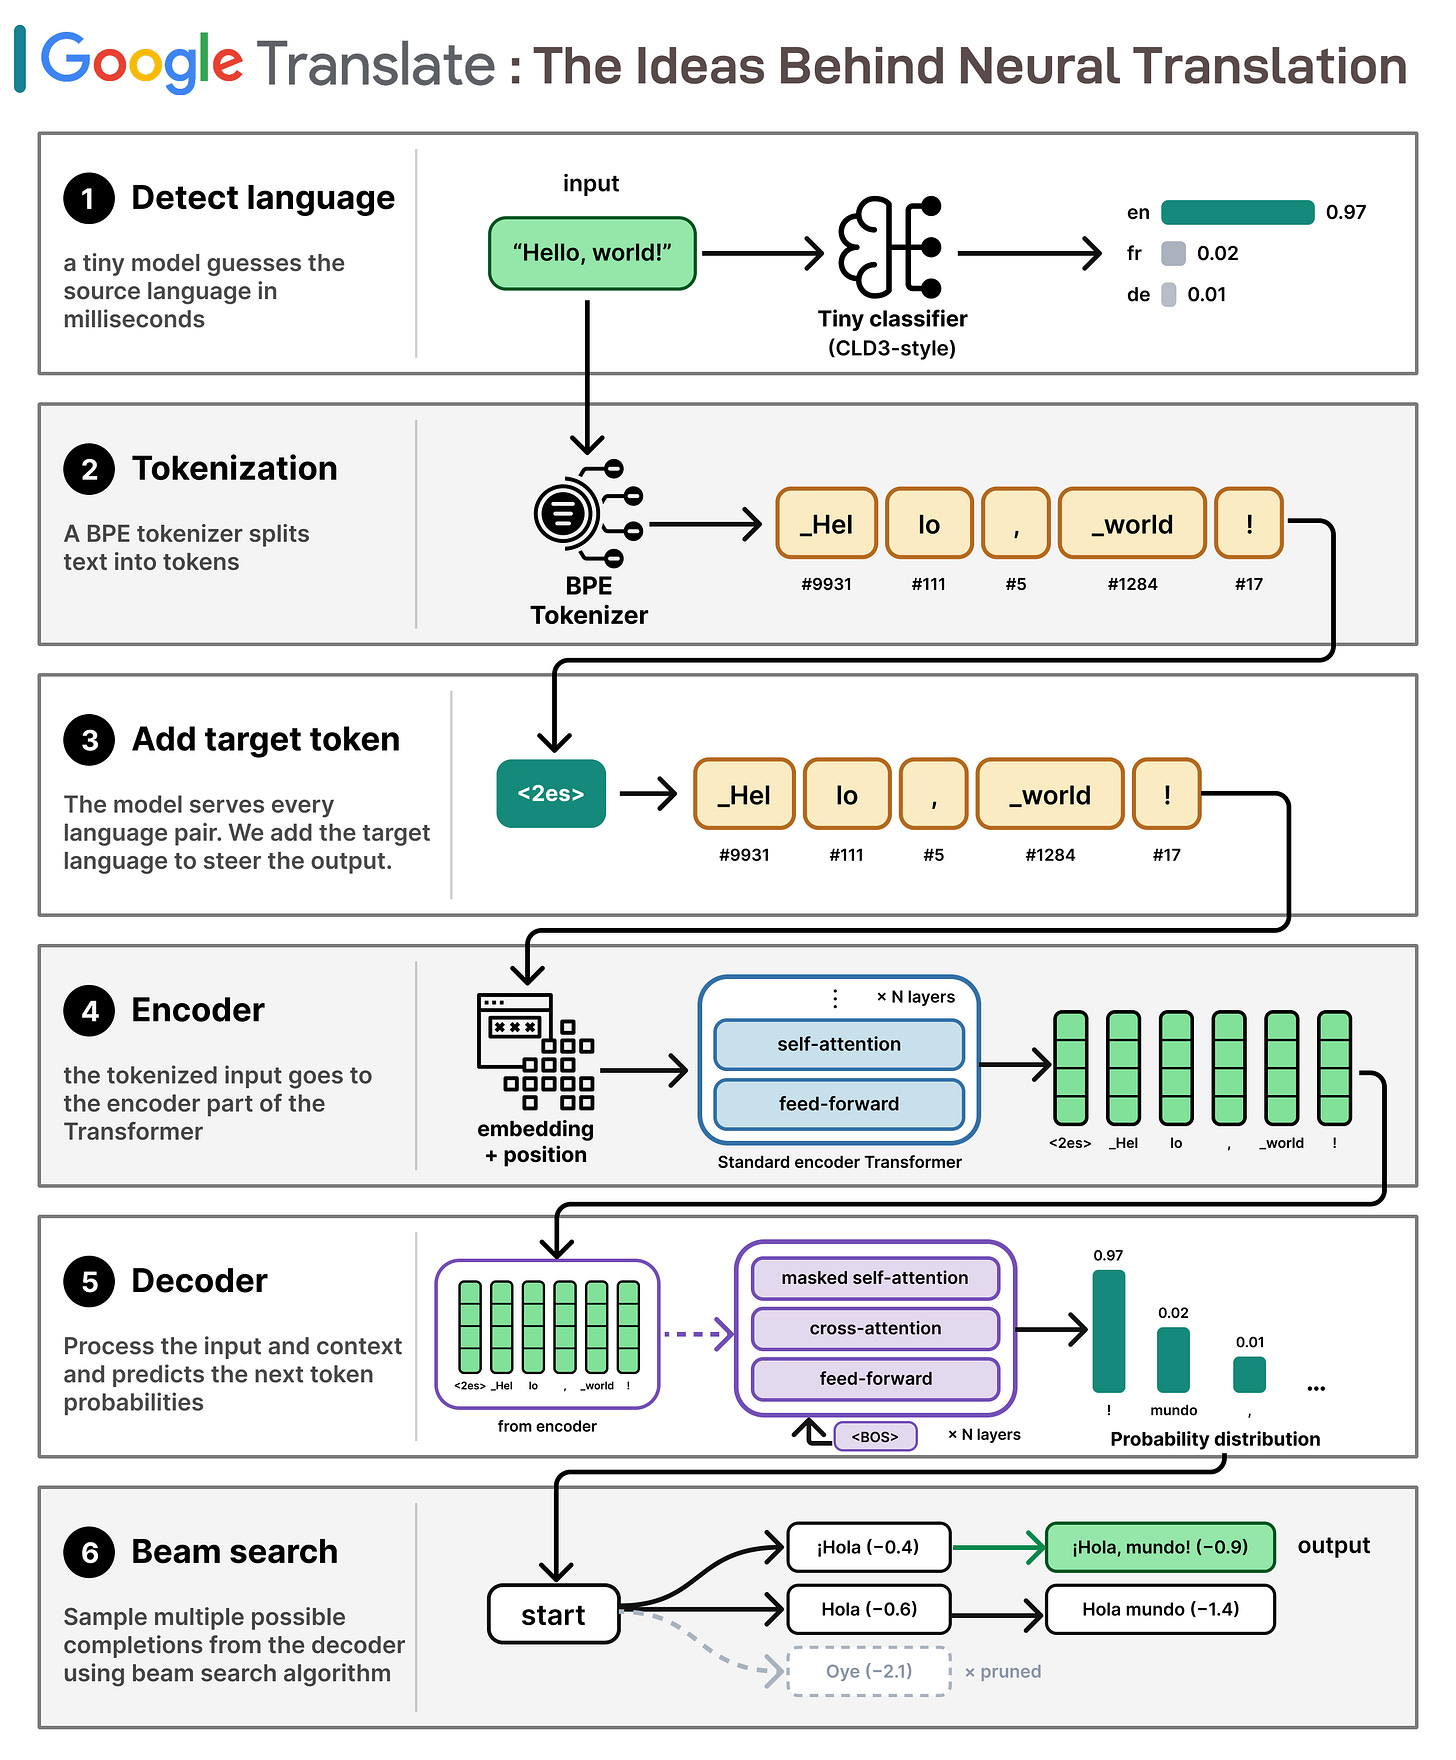
本文介绍RAG智能体的8种分块策略:固定大小、递归、基于文档结构、语义、基于LLM、智能体、延迟分块和分层分块;简述谷歌翻译神经机器翻译流程:语言检测、BPE分词、目标语言标记、编码器、解码器和束搜索;并介绍智能体技能按需加载机制及PostgreSQL进程架构与MySQL线程架构的差异。
延伸解读
分块策略的选择取决于文档类型与成本
文章列举的八种分块策略各有适用场景:固定大小简单但可能切断语义;递归和基于文档结构的方法能利用原有格式;语义分块通过嵌入相似度检测主题变化;基于LLM和智能体分块质量高但成本大;延迟分块和分层分块则提供更精细的嵌入或层次结构。实际选择需权衡文档特性、质量要求和计算开销。
智能体技能按需加载可缓解长提示词问题
文章指出长提示词会损害智能体性能,因此采用技能目录机制:运行时将用户查询与技能元数据结合,由LLM推理选择所需技能,再动态加载对应技能文件到上下文。这样既能保持上下文精简,又能让智能体行为一致。该机制适用于需要多种可复用操作指南的场景。
PostgreSQL与MySQL的架构差异影响使用方式
PostgreSQL基于进程架构,每个连接对应独立进程,由Postmaster协调,共享内存池,后台工作进程分别处理写入、清理和日志等任务。MySQL采用线程架构,单个服务器通过线程处理多连接,并支持可插拔存储引擎(如InnoDB、MyISAM)。两者设计哲学不同,可能影响并发模型和扩展性。
Q&A
RAG智能体常用的分块策略有哪些?
文章介绍了8种分块策略:固定大小、递归、基于文档结构、语义、基于LLM、智能体、延迟分块和分层分块。
语义分块是如何工作的?
语义分块会嵌入每个句子,检查它与前一句的相似度,当相似度下降时就开始新的分块。这样能发现真正的主题转变,而不是靠长度猜测。
基于LLM的分块有什么优缺点?
基于LLM的分块让LLM将文本重写为独立命题,每行一个想法,然后每个命题成为一个分块。质量高,但在大型语料库上成本昂贵。
智能体分块和传统分块方法有什么不同?
智能体分块由AI智能体阅读每个文档,判断其类型(代码、合同、表格等),并为该文件选择分块方法,而不是对所有文件使用统一规则。
谷歌翻译的神经机器翻译流程包括哪些步骤?
流程包括:语言检测、BPE分词、添加目标语言标记、编码器、解码器和束搜索。
Agent Skills是如何按需加载的?
Agent Skills的工作流程是:用户查询后,智能体运行时将查询与技能元数据(轻量级技能列表及简短描述)结合构建提示;LLM推理并选择技能;运行时加载SKILL.md到活动上下文;LLM遵循SKILL.md执行脚本并生成最终输出。这样动态加载技能,保持上下文小且行为一致。
PostgreSQL和MySQL在架构上有什么主要区别?
PostgreSQL使用基于进程的架构,由Postmaster协调专用工作进程,每个连接有自己的进程并共享内存池;MySQL使用基于线程的架构,采用分层设计,一个服务器通过线程处理多个连接,并使用可插拔存储引擎(如InnoDB、MyISAM)。
