


元学习:学会快速学习
内容提要
元学习旨在让模型像人一样,仅凭少量样本快速学会新任务,即“学会学习”。它按任务分布训练,测试时用支持集微调。主要方法分为三类:基于度量(如孪生网络、匹配网络、原型网络)、基于模型(如记忆增强网络、MetaNet)和基于优化(如LSTM元学习器、MAML、Reptile)。
延伸解读
元学习与迁移学习的区别
元学习常被与迁移学习比较。迁移学习通常在一个源任务上预训练模型,然后针对单个下游任务微调;而元学习在大量任务上训练,优化模型使其能快速适应多个新任务。文中指出,元学习不是根据一个下游任务微调,而是优化模型使其擅长许多任务。因此,元学习更强调任务分布上的泛化,而非单一任务的迁移。
三类元学习方法的适用场景
基于度量的方法(如孪生网络、匹配网络、原型网络)通过比较样本相似度进行分类,适合图像分类等任务;基于模型的方法(如MANN、MetaNet)依赖特殊架构或外部记忆实现快速参数更新;基于优化的方法(如LSTM元学习器、MAML、Reptile)调整优化过程,使模型在少量梯度步骤内适应新任务。选择时需权衡任务类型、计算成本和实现复杂度。
MAML与Reptile的优化差异
MAML通过二阶梯度优化初始参数,使模型在少量梯度步骤后能快速适应新任务,但计算成本较高。First-Order MAML省略二阶导数以降低计算量。Reptile则更简单,通过多次采样任务并朝任务优化后的参数移动,无需二阶信息。两者都模型无关,但Reptile实现更简单,适合资源有限场景。
元学习的评估与风险
元学习模型在任务分布上训练,测试时面对未见任务。评估需关注模型在少量样本下的泛化能力,而非单一任务性能。风险包括:任务分布与实际应用不匹配可能导致适应失败;基于度量的方法依赖嵌入质量,若新任务与训练任务差异大,效果可能下降;基于优化的方法可能过拟合元训练任务。实际应用中需谨慎设计任务分布和评估协议。
Q&A
元学习中的‘学会学习’具体指什么?
元学习旨在让模型像人一样,仅凭少量样本快速学会新任务,即‘学会学习’。它按任务分布训练,测试时用支持集微调,使模型能适应训练时未见过的新任务。
元学习主要分为哪几类方法?
元学习主要分为三类:基于度量(如孪生网络、匹配网络、原型网络)、基于模型(如记忆增强网络、MetaNet)和基于优化(如LSTM元学习器、MAML、Reptile)。
基于度量的元学习是如何工作的?
基于度量的元学习通过核函数计算测试样本与支持集样本的相似度,预测概率是支持集标签的加权和。核心是学习一个好的核函数或距离度量,常用模型包括孪生网络、匹配网络和原型网络。
MAML和Reptile有什么区别?
MAML通过元优化寻找初始参数,使模型能通过少量梯度步骤快速适应新任务,依赖二阶导数;Reptile则更简单,通过多次梯度更新后将权重移向新参数,不依赖二阶导数,与FOMAML有联系。
记忆增强神经网络(MANN)如何用于元学习?
MANN使用外部记忆存储,训练时标签延迟一步呈现,迫使网络记住信息直到标签出现。采用纯内容寻址读取和LRUA写入机制,实现快速编码新任务信息并稳定访问。
元学习中的‘快速权重’是什么?
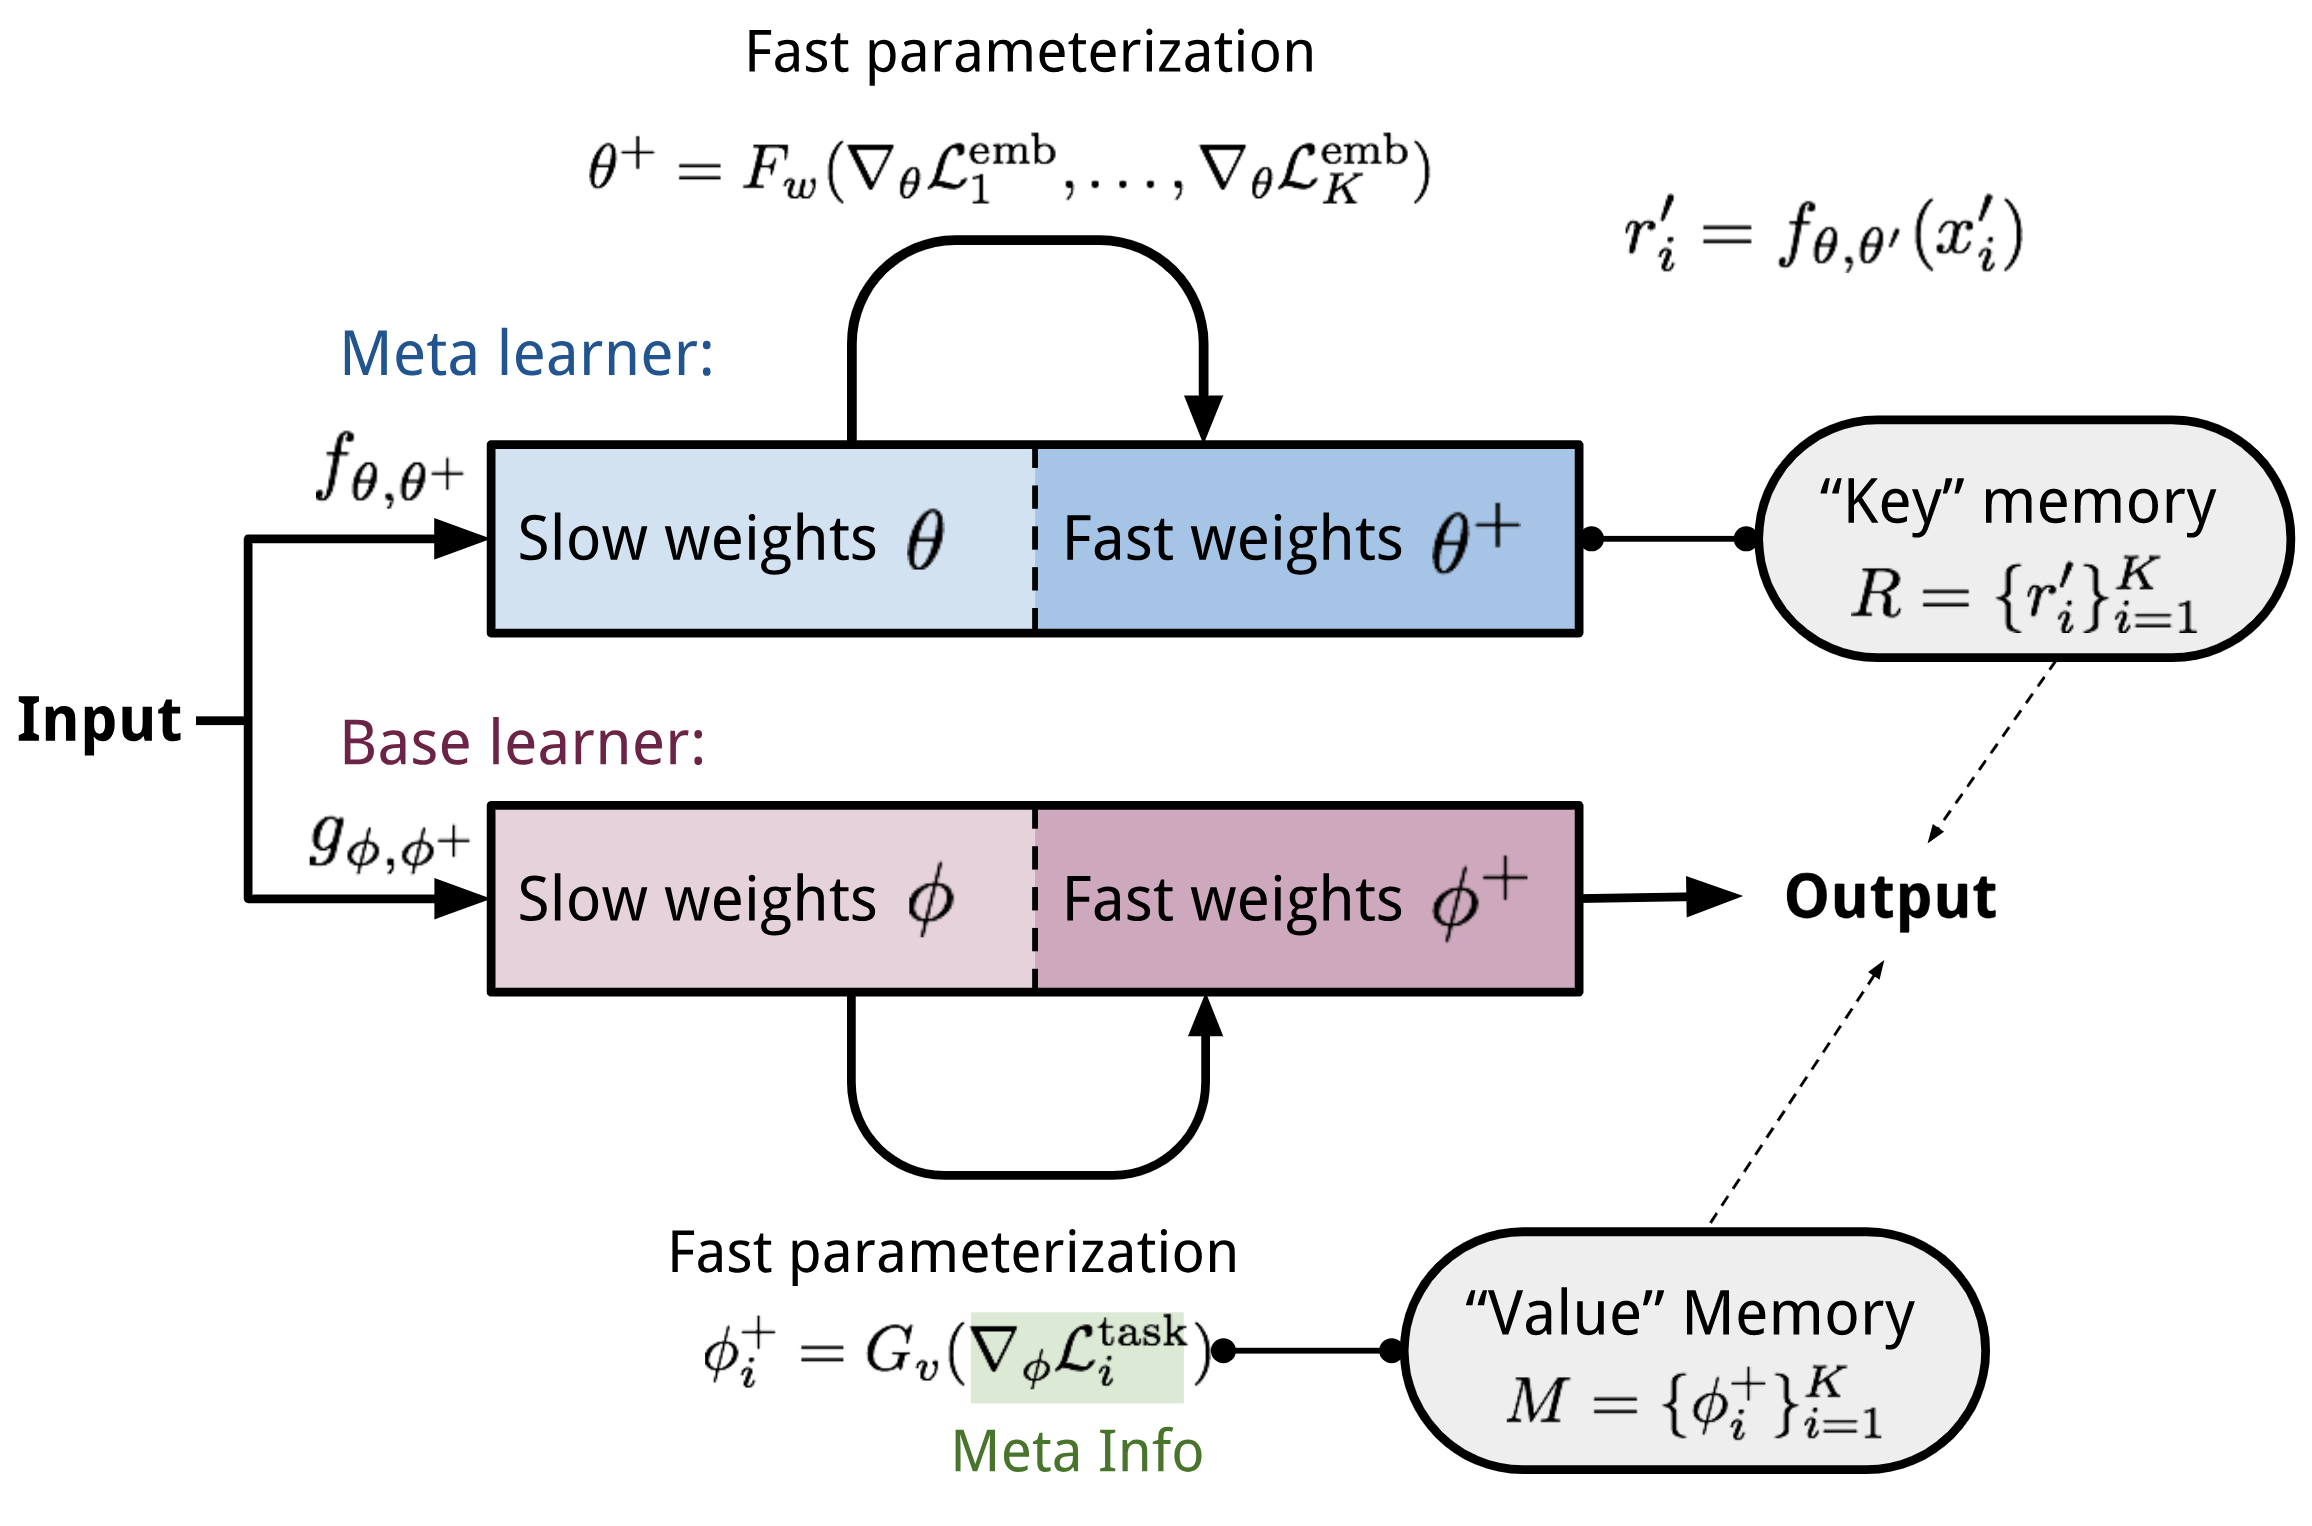
快速权重是由一个神经网络预测另一个神经网络的参数,与通过SGD更新的慢权重相对。在MetaNet中,损失梯度作为元信息生成快速权重,与慢权重结合用于预测,实现快速泛化。
