Manta Marine Technologies 在 AWS 上构建云原生数据基础设施,为每艘船单独训练机器学习模型,并结合天气预报优化航程。系统利用 Apache Airflow、Amazon EC2、ECS、Lambda 等处理海量船舶数据,并随新航次数据持续重训模型。相比按船型平均建模,该方案更贴合单船实际性能,预计每船节省约 2–4% 燃油。
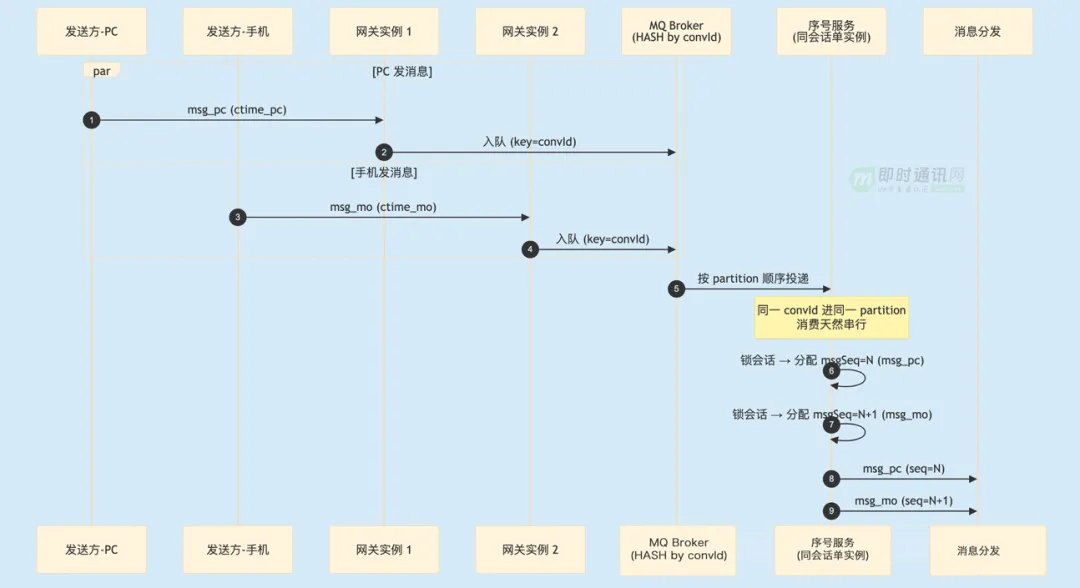
本文分析IM消息乱序问题,指出客户端时间戳不可信、多端并发发送、群消息扇出重试三大陷阱;设计目标为同一会话内强保序、跨会话弱保序、多端最终一致;方案是将时序锚点收敛到服务端会话级单点,用msgSeq保证会话内单调递增,stime用于跨会话排序,并通过会话锁串行分配、MQ哈希分区确保顺序一致。
本文梳理线性注意力的优化路线:Performer用正交随机特征逼近softmax;DeltaNet按当前Key修正旧映射;GLA按Key通道门控衰减并分块并行;Mamba-2/SSD以标量衰减统一递推与矩阵计算;Gated DeltaNet结合整体遗忘与Delta规则,用WY表示和三角求解实现分块;KDA进一步采用逐通道衰减加Delta更新,兼顾表达力与硬件效率,并与MLA混合使用。
文章解释专家缓存不适用于稠密模型:MoE每Token仅激活约3B参数,可缓存热点专家;而Qwen3.8-27B每Token需计算全部27B权重,按Token搬运权重受PCIe带宽限制。作者在16GB显存上实现稠密推理引擎,通过显存预算规划、零拷贝放置、12种GGUF量化块原位GEMV、单流子层融合及分块注意力显著降低延迟,但整网端到端吞吐仍待实测。
Cloudflare优化其AI代码审查代理,将平均审查成本从2.43美元降至0.77美元(降68%),中位耗时从4分09秒缩短至1分32秒。约40%的节省来自代码优化,其余来自模型与推理强度调整。关键措施包括:各仓库共享缓存前缀、减少LLM调用、并行读取文件、跳过无新内容的复审。质量评估显示,高强度下代码质量审查仍能发现相当数量的真实问题,且误报和严重性虚高大幅减少。
本期汇总四条 Rust 动态:Vec/String 枚举可利用 niche 优化,无需额外判别字段;iroh 发布 1.0,稳定线格式与 API,采用 QUIC 和 Ed25519 端点身份;Apalis 1.0 拆分 Backend trait,新增工作流与多种后端;社区讨论线性类型、代数效应等研究能否进入 Rust 后继语言。
微软与英伟达合作推出基于Arm架构的RTX Spark笔记本,Windows针对本地AI模型、游戏和内存管理进行优化。首批支持Hermes等AI代理,可通过应用商店安装。微软使用Prism模拟器运行非原生应用,并优化游戏反作弊支持。Copilot Plus功能推迟至明年。
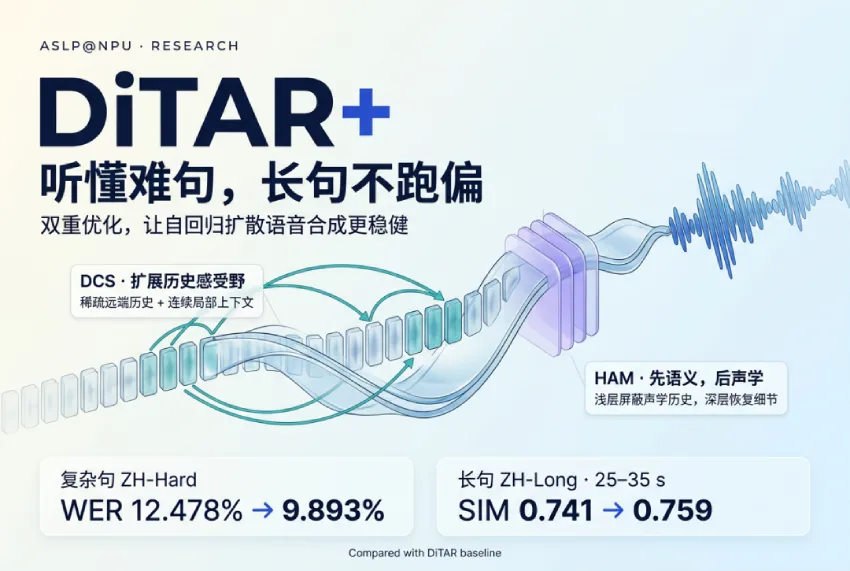
西工大ASLP@NPU提出DiTAR+,针对连续表征自回归扩散语音合成中的长语音说话人漂移和复杂文本语义幻觉问题,设计扩张上下文采样(DCS)与分层声学掩码(HAM)双重优化。DCS扩展历史感受野,HAM先语义后声学。实验显示复杂中文WER从12.478%降至9.893%,长语音WER从2.778%降至2.173%,说话人相似度提升。
文章介绍将 BadgerDB 移植到仓颉时的性能优化与一次误判。作者列举十项优化,包括 CRC32C 全局查找表、用 Condition 替代轮询、将 flush 移出写锁使写吞吐翻倍。随后复盘一起“编译器 bug”乌龙:实为仓颉 Array 切片是共享视图而非拷贝,导致自造错误。结论是怀疑编译器前应先检查自身代码的别名与共享语义。
为 Omarchy 桌面时钟和顶部插件新增最小化功能:点击后插件吸附到屏幕顶部变为小黑条,再次点击可恢复原大小和位置,便于录制新插件视频。
对于无约束的光滑函数来说,求极值的通用方法自然是求导(梯度)并让导数等于零了。那带等式约束的极值问题呢?很多读者应该也不陌生,标准方法是拉格朗日乘子法。然而,拉格朗日乘子总让人觉得是一种纯粹的代...
本文介绍五种降低大模型Token消耗的提示词优化技巧:用结构化约束替代冗长指令;少样本示例控制在三到五个;对长文档动态裁剪上下文,仅保留相关段落;利用提示缓存复用固定前缀;将思维链推理与最终答案分离,丢弃推理过程。这些方法可显著降低成本并提升响应速度。
Lakebase 是基于存算分离架构的托管 Postgres,成本优势显著。数据库分支共享存储,适合短期开发测试;自动扩缩容可按需调整算力,配合缩容至零可进一步降本。读写分离与高可用无需复制存储。同步表应只同步活跃子集,并按需选择快照、触发或连续模式。合理配置计算规格、连接池和恢复窗口,可避免资源浪费。
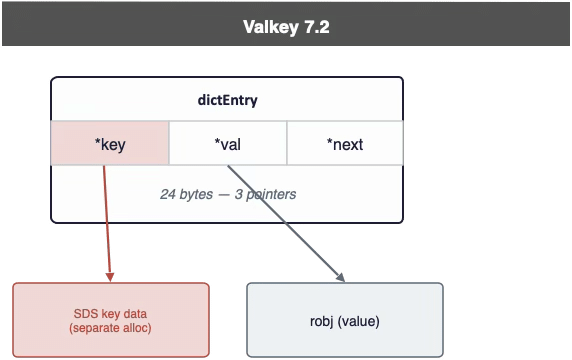
Valkey 7.2至9.1通过三项底层数据结构重构,将字符串密集型场景的每键内存从102.48字节降至64.02字节,减少37.5%。8.0将键内联进dictEntry节省8字节;8.1改用64字节缓存行对齐哈希表,嵌入键值并消除dictEntry,节省20-30字节;9.1将短字符串内联存储,节省最多20%。此外,用Hash存储同一数据比多个String键节省54%内存,但需权衡TTL与集群灵活性。
Numba可将Python数值循环编译为机器码,无需改用C或向量化。同一函数可通过三种方式优化:用@njit编译循环,比纯Python快约80倍;加parallel=True和prange实现多核并行,提速约350倍;再加cache=True缓存编译结果,避免重复编译。核心是让热点代码留在编译边界内、覆盖全部核心,并只付一次编译成本。
小语言模型优化第三法为按长度分桶批处理:逐条推理受内存带宽限制效率低,普通批处理因填充浪费算力;按token长度排序后分批,各批仅填充至局部最大值,可将填充开销降至约8%,吞吐量提升近一倍。需左填充、只取末位logits,并核对结果与逐条推理一致。
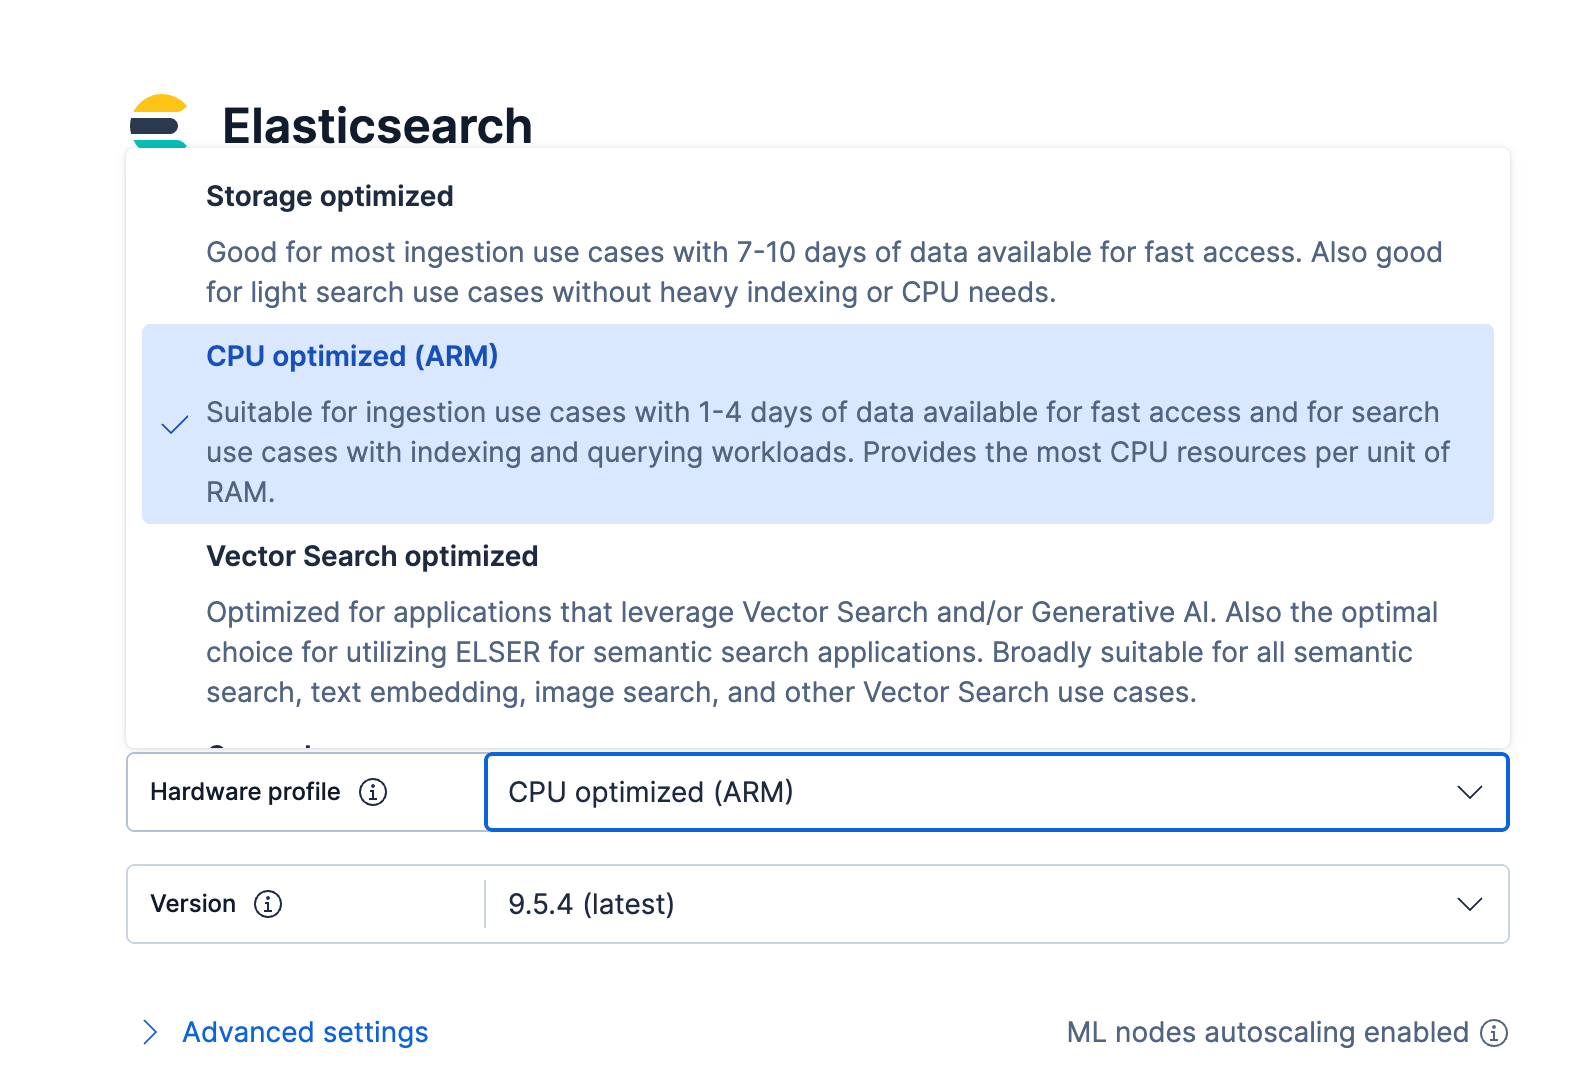
Elastic Cloud on Azure 推出基于微软 Cobalt ARM 处理器的计算优化配置,采用 Dpldsv6 虚拟机与本地 NVMe 存储,随机读取性能更佳。测试显示其性价比比 Fsv2 实例提升高达 44%,适合索引、聚合等 CPU 密集型搜索工作负载。用户可通过 Azure 门户或 Elastic Cloud 控制台创建或逐节点迁移部署,该配置已在多个 Azure 区域上线。
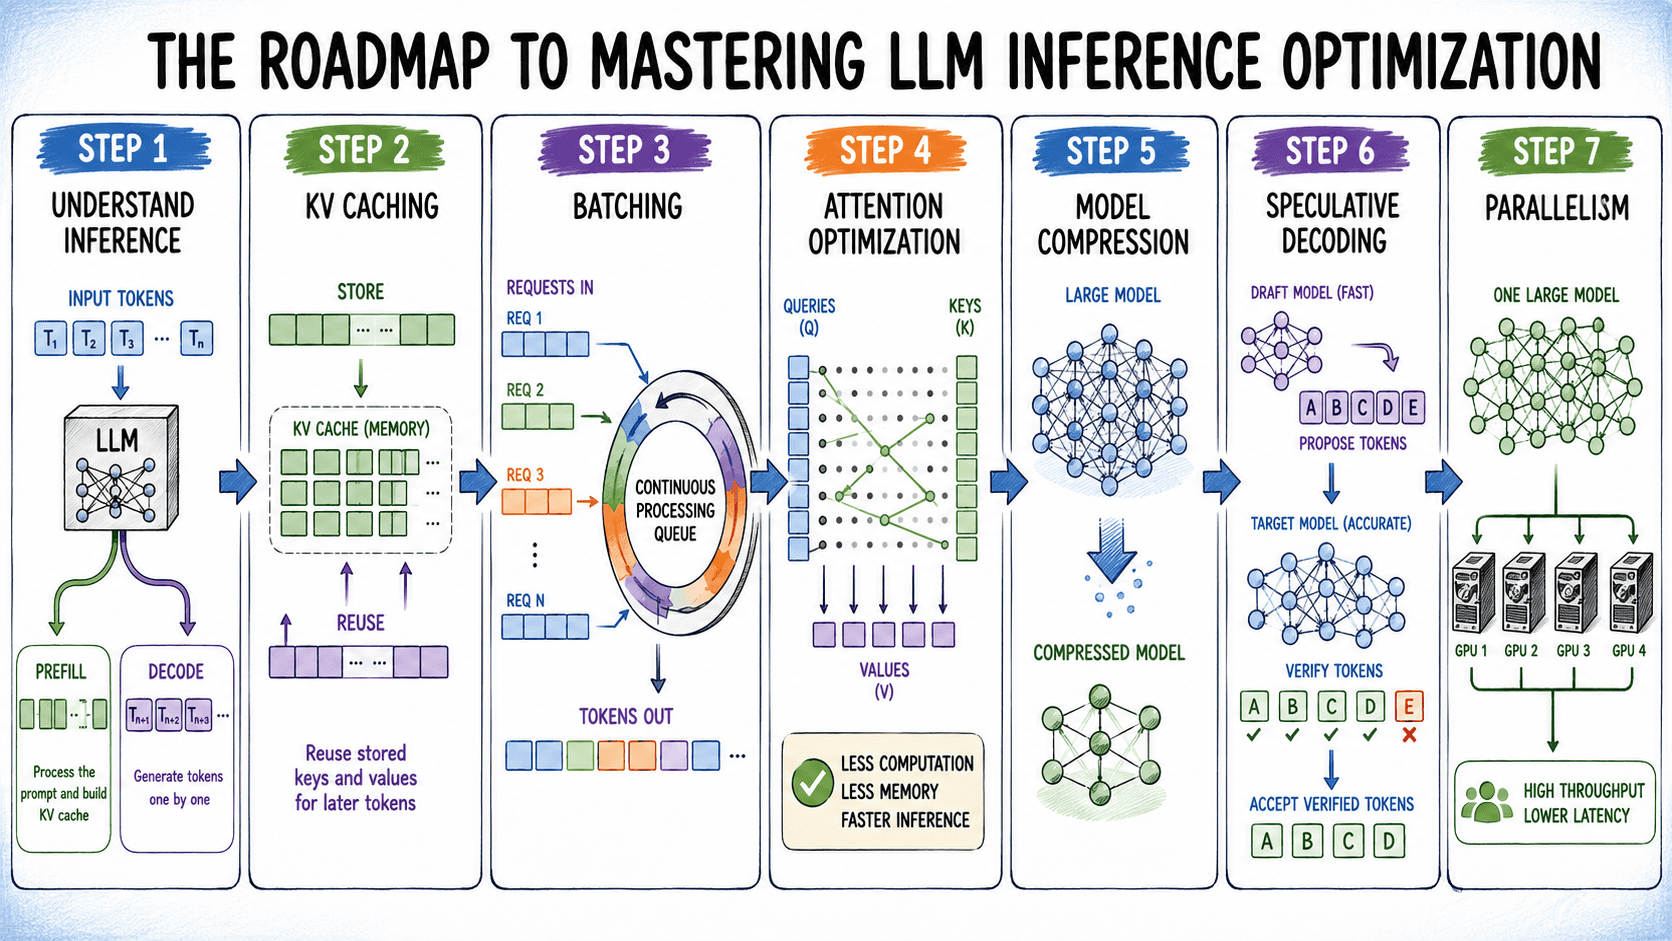
本文介绍大语言模型推理优化路线图。推理分为预填充(计算密集)和解码(显存带宽受限)两阶段。优化手段包括:KV缓存、PagedAttention与前缀缓存管理显存;连续批处理提升GPU利用率;MQA、GQA、FlashAttention优化注意力;量化、稀疏化、知识蒸馏压缩模型;投机解码降低延迟;张量并行、流水线并行及预填充-解码分离实现多GPU扩展。
Niaz Morshed 开源了 JCR,利用 Jev 树状路由在六层能力目录中逐层筛选,将 11360 条 API 命令的检索压缩为少量结果。实测显示,Claude Opus 5 的输入 token 减少 85%、成本降低 67%,但 GPT-5.6-Sol 耗时增加 2.5 倍。JCR 仅返回文档而不执行命令,适用于按 token 计费昂贵且可接受延迟的场景。
Jev Engineering 提出将 Agent 中“做选择”的决策从大模型剥离,交由专门的 Jev 分类模型处理,大模型仅负责推理与生成。Jev 支持 Choice、Score、Noul 三种输出,用于路由、排序和门控,并通过漏斗筛选、批量决策、置信度阈值和上下文打分压缩来降本增效。实测成本约 42 美分对 44 美元,相差百倍,但准确率仍有差距,需按场景验证。
完成下面两步后,将自动完成登录并继续当前操作。