
【调研】从 Generate 到 Decide:Jev、System One Models 与 Agent 决策层
内容提要
TypeSafe AI 发布 Jev,首个 System One Model。它接收状态与预定义问题,直接输出 Choice、Score、Noul 等类型化结果及概率,将高频语义判断从生成式模型拆出,转为软件可调用的 decide()。该模型面向 Agent 路由、结果验收、循环控制等有限候选场景,主打低延迟、低成本与校准概率,但校准与泛化能力仍需独立验证。
延伸解读
Decision Model 的定位:不是替代 LLM,而是补上中间层
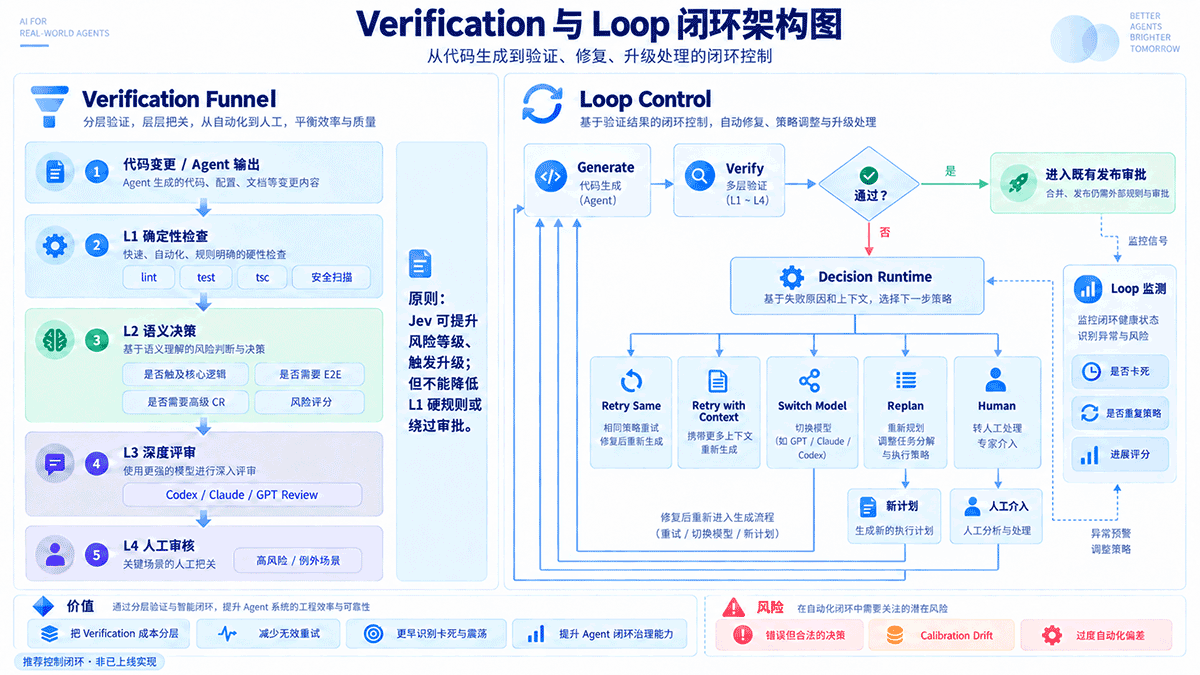
文章将智能判断分为四层:L1 确定性规则、L2 Decision Model、L3 System-2 推理模型、L4 人工审批。Jev 瞄准的是 L2,处理路由、验收、循环控制等高频、有限候选的语义判断。它不能替代 L1 的权限与硬策略,也不应承担 L3 的开放式规划。理解这一分层,有助于判断哪些场景适合引入 Decision Model,哪些必须留给规则或更强模型。
Calibration 是核心卖点,也是最需要独立验证的能力
Jev 主张输出可用于自动化阈值的校准概率,即 confidence=0.9 时实际正确率应约 90%。但文章指出,RLCD 训练细节、模型架构与大规模 OOD 校准基准均未公开,因此 calibration 目前仍是供应商 claim,而非已验证事实。对技术决策者而言,应优先在自有业务数据上检验 ECE、Brier Score 与高置信度错误率,再决定是否用于自动执行。
“Zero Hallucination”不等于零语义错误
Jev 能保证不输出 schema 外字段、不返回未定义枚举、不产生自由文本幻觉,但完全可能给出格式合法却语义错误的判断,例如把 review 错分为 code 且置信度高达 0.97。文章提醒,这种“错误但合法”的结果在生产系统中往往比 malformed JSON 更难发现。因此仍需确定性约束层、复核策略与人工升级机制,不能因输出类型安全就放松语义校验。
落地路径:先 Contract 与离线回放,再影子与受控自动化
文章建议不要直接把 Jev 散落在各业务链路中,而应通过 provider-neutral 的 Decision Runtime 统一管理 Contract、阈值、fallback 与审计。PoC 应先定义 State、候选空间、Criteria 与 ground truth,再用历史事件做离线回放,对比 Rule、Fast LLM、Frontier LLM 与 Jev 的质量、校准、延迟和成本。验证通过后先影子运行,最后只开放低风险、可逆、有 fallback 的自动化动作。
Q&A
Jev 是什么?它和普通大模型有什么不同?
Jev 是 TypeSafe AI 发布的首个 System One Model,输入状态与预定义问题,直接输出 Choice、Score、Noul 等类型化结果及概率。它把高频语义判断从生成式模型的 generate() 中拆出来,变成软件可直接调用的 decide(),主打低延迟、低成本与校准概率,而非通用聊天或推理。
Jev 的三种输出类型 Choice、Score、Noul 分别代表什么?
Choice 是在预定义候选中选择,类似语义枚举;Score 是在定义好的尺度上评分,类似模糊数值函数;Noul 是 0–1 的真值概率,类似概率布尔值。它们都是类型化结果,可直接被程序消费,无需生成自然语言解释。
Jev 和 Structured Output 有什么区别?
Structured Output 是限制模型怎样说,仍属于受约束的生成;Jev 是尽量不让模型说,直接进行决策推理,输出选项概率,不按 token 收费,多个独立问题可并行,延迟远低于完整文本生成。
Jev 的校准(Calibration)为什么重要?
校准指模型给出的 confidence 是否等于实际正确率,例如 confidence=0.9 时应有约 90% 正确。在自动化系统中,校准比单纯准确率更重要,因为阈值决策(如 p>0.99 自动执行)依赖可靠的概率。Jev 的校准能力仍需独立验证。
Jev 适合用在哪些 Agent 场景?
适合高频、答案空间可预定义的有限候选判断,如 Agent/Skill/Model 路由、结果验收与升级、循环停止/重试/重规划、上下文保留/丢弃、Trace 分类等。不建议用于开放式规划、不可逆授权或安全关键的快速控制。
Jev 的“Zero Hallucination”是什么意思?
指 Jev 不会产生 malformed JSON、schema 外字段、未定义 enum 或自由文本幻觉,即零 schema 外生成。但这不等于零语义错误,模型仍可能给出错误但完全合法的结果,例如正确答案是 review 却输出 code 且置信度很高。
Jev 的 193 倍加速和 444 倍成本优势应该怎么理解?
这些数字来自官方 workflow eval,针对的是适合拆成有限候选判断的 System-One-shaped 工作负载,如安全事件、Agent 追踪、发票处理、客服等。不应理解为所有任务都比 GPT 快 193 倍,它们证明的是在特定工作负载上的效率潜力,而非通用 benchmark。
Jev 目前是开源还是闭源?如何收费?
截至 2026-09-21,Jev 模型权重闭源,官方 API 已开放 Early Access,有 Web Console,已接入 OpenRouter 和 Vercel AI Gateway,未公开本地部署。输入价格约 $0.042/1M tokens(即 $42/1B input tokens),输出免费。
为什么需要 Decision Runtime,而不是直接调用 Jev?
直接调用会导致 schema 散落、阈值不一致、provider 锁定、无法 replay、无法 A/B、无统一 fallback、无法做 calibration dashboard。Decision Runtime 作为 provider-neutral 层,统一管理 Contract、Provider、Reliability、Observability 和 Evaluation,Jev 只是其中一个 DecisionProvider。
Jev 面临的最大战略风险是什么?
主要风险有两个:一是 Frontier LLM 的 function calling、structured output 与缓存优化可能把 Jev 的延迟/成本优势压缩到不足以形成独立品类;二是其 confidence 是否在真实业务与分布外输入上仍然校准。此外,开源小模型可能商品化这一层,若校准不成立,Jev 会退化为快速语义分类器。
