


上下文工程存在检索难题:推出 rerank-3 与原生重排功能
内容提要
文章指出,智能体成功的关键在于上下文工程,核心是检索:应从海量数据中选出最相关的少量内容,而非塞入更多信息。MongoDB 将 Voyage AI 的嵌入与重排模型整合进其数据平台,推出 rerank-3 系列及聚合管道中的 $rerank,使检索、重排与业务数据在同一系统内完成,避免多供应商集成与向量不同步问题。rerank-3 准确率优于 Cohere 和 Qwen3,并能显著提升多种首阶段检索效果。
延伸解读
检索质量决定智能体成败
文章强调,智能体成功的关键在于上下文工程,而核心是检索:从海量数据中选出最相关的少量内容,而非塞入更多信息。因为更大的上下文窗口会让智能体更慢、更贵,且无关信息会掩埋有用信号,降低准确性。因此,团队应优先优化检索策略和模型,而不是盲目扩大上下文。
统一平台避免检索栈碎片化
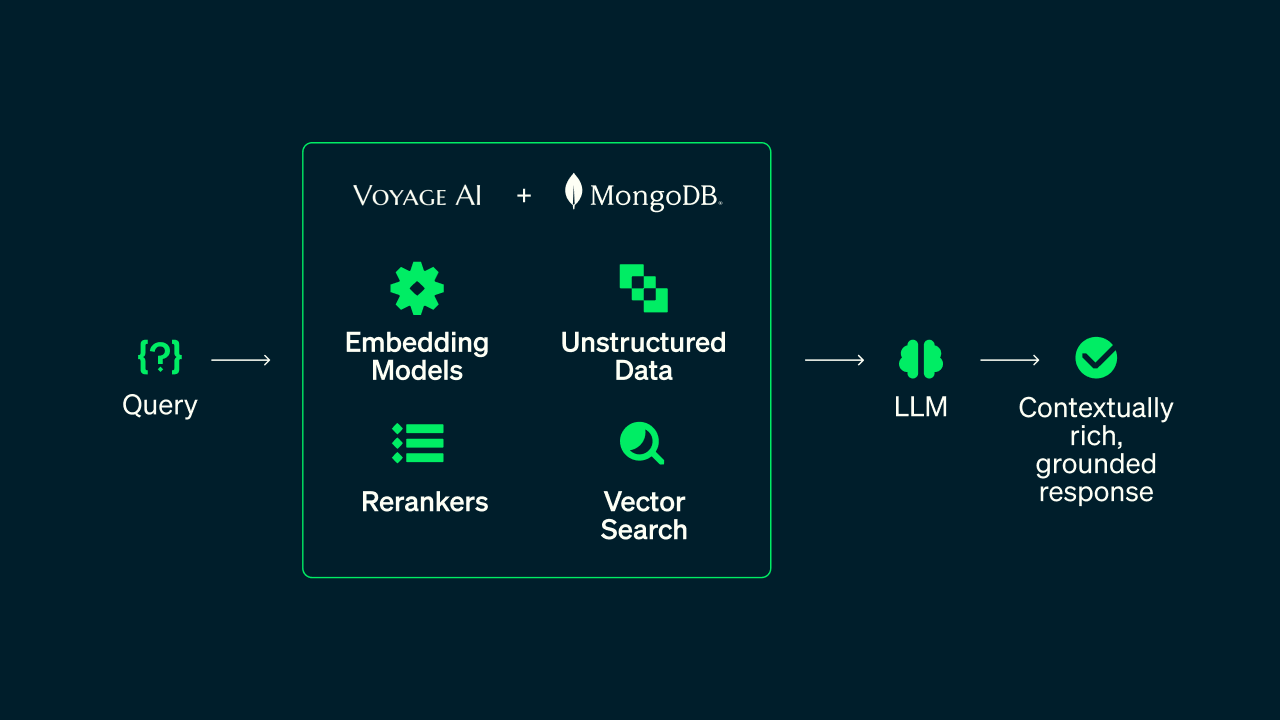
文章指出,分散的检索栈(如嵌入、重排、数据库来自不同供应商)会带来更多集成、同步任务和API调用,还可能产生静默问题:向量索引使用的嵌入模型版本与应用程序不一致,导致相关性下降却不报错。MongoDB将Voyage AI的嵌入与重排模型整合进其数据平台,使检索、重排与业务数据在同一系统内完成,简化了架构并减少同步风险。
rerank-3提升首阶段检索效果
文章介绍,rerank-3系列在长文档和代码任务上准确率提升最大,整体优于Cohere Rerank v4.0 Pro(2.72%)和Qwen3-Reranker-8B(3.02%)。无论首阶段采用BM25、OpenAI v3 large还是voyage-4-large,重排都能带来NDCG@10提升,其中BM25提升达20.56%。从rerank-2.5升级只需更改模型名称,API和价格不变。
原生重排与自动嵌入简化生产部署
文章提到,$rerank作为聚合管道中的无索引阶段,可直接对前一阶段产生的候选集重新排序,无需外部API调用或应用代码重组。Automated Embedding在字段级别近实时生成和刷新向量,并在Atlas UI中显示令牌消耗和索引健康状态,避免了嵌入作业维护和模型版本分裂问题。这些功能共同降低了构建生产级检索系统的复杂度。
Q&A
为什么给AI智能体更多上下文反而效果不好?
因为更多上下文会让智能体变慢、成本更高,并且无关信息会淹没有用信号,从而降低准确性。智能体成功的关键在于上下文工程,即从海量数据中选出最相关的少量内容,而非塞入更多信息。
MongoDB新推出的rerank-3模型准确率比哪些模型好?
rerank-3整体准确率比Cohere Rerank v4.0 Pro高2.72%,比Qwen3-Reranker-8B高3.02%。它在长文档和代码任务上提升最大。
MongoDB的$rerank聚合管道阶段有什么作用?
$rerank是一个无索引阶段,可以对上一阶段产生的候选集使用rerank-3或rerank-3-lite重新打分排序。它无需外部API调用,直接在MongoDB聚合管道中完成重排,简化了检索流程。
rerank-3能提升哪些首阶段检索方法的效果?
rerank-3能提升多种首阶段检索方法的效果,例如对BM25(仅词汇)提升20.56%,对OpenAI v3 large提升12.77%,对voyage-4-large提升5.08%(NDCG@10指标)。
Gravity公司使用Voyage AI后取得了什么效果?
Gravity公司切换至Voyage AI后,检索延迟降低了约50%,并且随着请求量增长,准确性也得到提升。Voyage AI模型能更好地区分不匹配的候选,并提升匹配候选的排名。
MongoDB如何解决检索系统中向量不同步的问题?
MongoDB通过Automated Embedding在字段级别近实时生成和刷新向量,并在Atlas UI中显示令牌消耗和索引健康状态。这避免了维护嵌入作业,也防止索引构建的模型版本与查询使用的模型版本不一致。
