

基于PyFlink的空气质量数据分析
内容提要
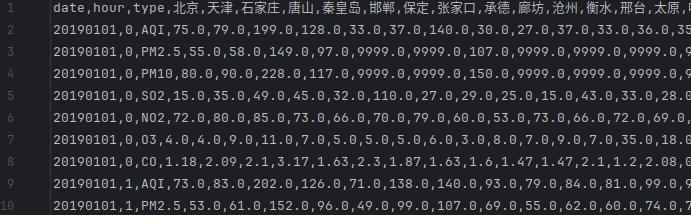
本文介绍了使用Python和Flink工具处理气象站点采集的空气质量数据的方法,计算全国多个城市的8小时移动平均空气质量信息,并进行数据可视化,更新空气质量榜单。数据集使用南京信息工程大学数学建模赛题附件1的2019年数据,经过数据清洗后上传到HDFS。
延伸解读
数据清洗的关键步骤
文章使用Pandas读取CSV文件,进行去重、填充缺失值为9999,并仅保留实时值,去除已有的8小时移动平均值。这一处理确保了后续Flink计算基于原始数据,避免重复计算。清洗后的数据整合为data2019_dist.csv,为流处理提供干净输入。
环境配置与依赖管理
操作环境为Ubuntu18.04、Flink1.17.0、Hadoop3.3.5、Python3.8.10,并指定Pandas1.3.5。通过data_clean.sh脚本安装pyhdfs和apache-flink依赖,并设置python别名。这体现了在特定版本下进行大数据处理的实践,版本一致性对避免兼容性问题很重要。
数据上传与HDFS目录结构
清洗后的数据通过hdfs dfs -put命令上传至HDFS,路径包含用户标识和“数据集”目录,同时上传citylist.txt。这种组织方式便于Flink作业从HDFS读取数据,也反映了数据管理的基本规范,为后续分布式计算提供存储基础。
Q&A
如何使用Python和Flink处理空气质量数据?
使用Python和Flink可以处理气象站点采集的空气质量数据,计算全国多个城市的8小时移动平均空气质量信息,并进行数据可视化。
文章中提到的空气质量数据集来源是什么?
数据集来源于南京信息工程大学2019年的数学建模赛题附件1,包含全国300多个城市的空气质量指标数据。
数据清洗过程中使用了哪些工具和方法?
数据清洗过程中使用Pandas读取csv文件,去重并填充缺失值为9999,最终整合得到data2019_dist.csv文件。
如何更新空气质量榜单并进行可视化?
通过计算8小时移动平均空气质量信息后,可以更新空气质量榜单,并使用可视化工具展示数据。
文章中提到的操作环境是什么?
操作环境为Ubuntu18.04,Flink1.17.0,Hadoop 3.3.5,Python3.8.10等。
如何将处理后的数据上传到HDFS?
使用hdfs dfs -put命令将处理后的data2019_dist.csv文件上传到HDFS指定目录。
