


数据不足时的学习 第一部分:半监督学习
内容提要
本文介绍数据不足时的半监督学习,核心是结合少量标注数据与大量未标注数据,损失函数由监督项和无监督项组成。主要方法包括一致性正则化(Π模型、平均教师)、伪标签、MixMatch、FixMatch等,通过数据增强、置信度过滤和锐化预测减少确认偏差,提升模型性能。
延伸解读
半监督学习在视觉与语言任务中的差异
文章指出,半监督学习的研究大多集中在视觉任务,而语言任务更常见的是预训练加微调。这提示读者,在选择方法时需考虑任务类型:视觉任务可尝试一致性正则化、伪标签等技术,而语言任务可能更依赖预训练模型。同时,半监督学习通常假设未标注数据与标注数据同分布,实际应用中需注意这一前提。
一致性正则化的核心与实现要点
一致性正则化要求模型对同一输入的不同扰动版本给出相同预测。Π模型通过两次前向传播实现,但计算成本高;平均教师用教师权重的移动平均提供更稳定的目标,且对EMA衰减系数β敏感,训练初期宜用较小β,后期增大。此外,输入增强或学生模型dropout对性能至关重要,而教师模型无需dropout。
伪标签与确认偏差的缓解策略
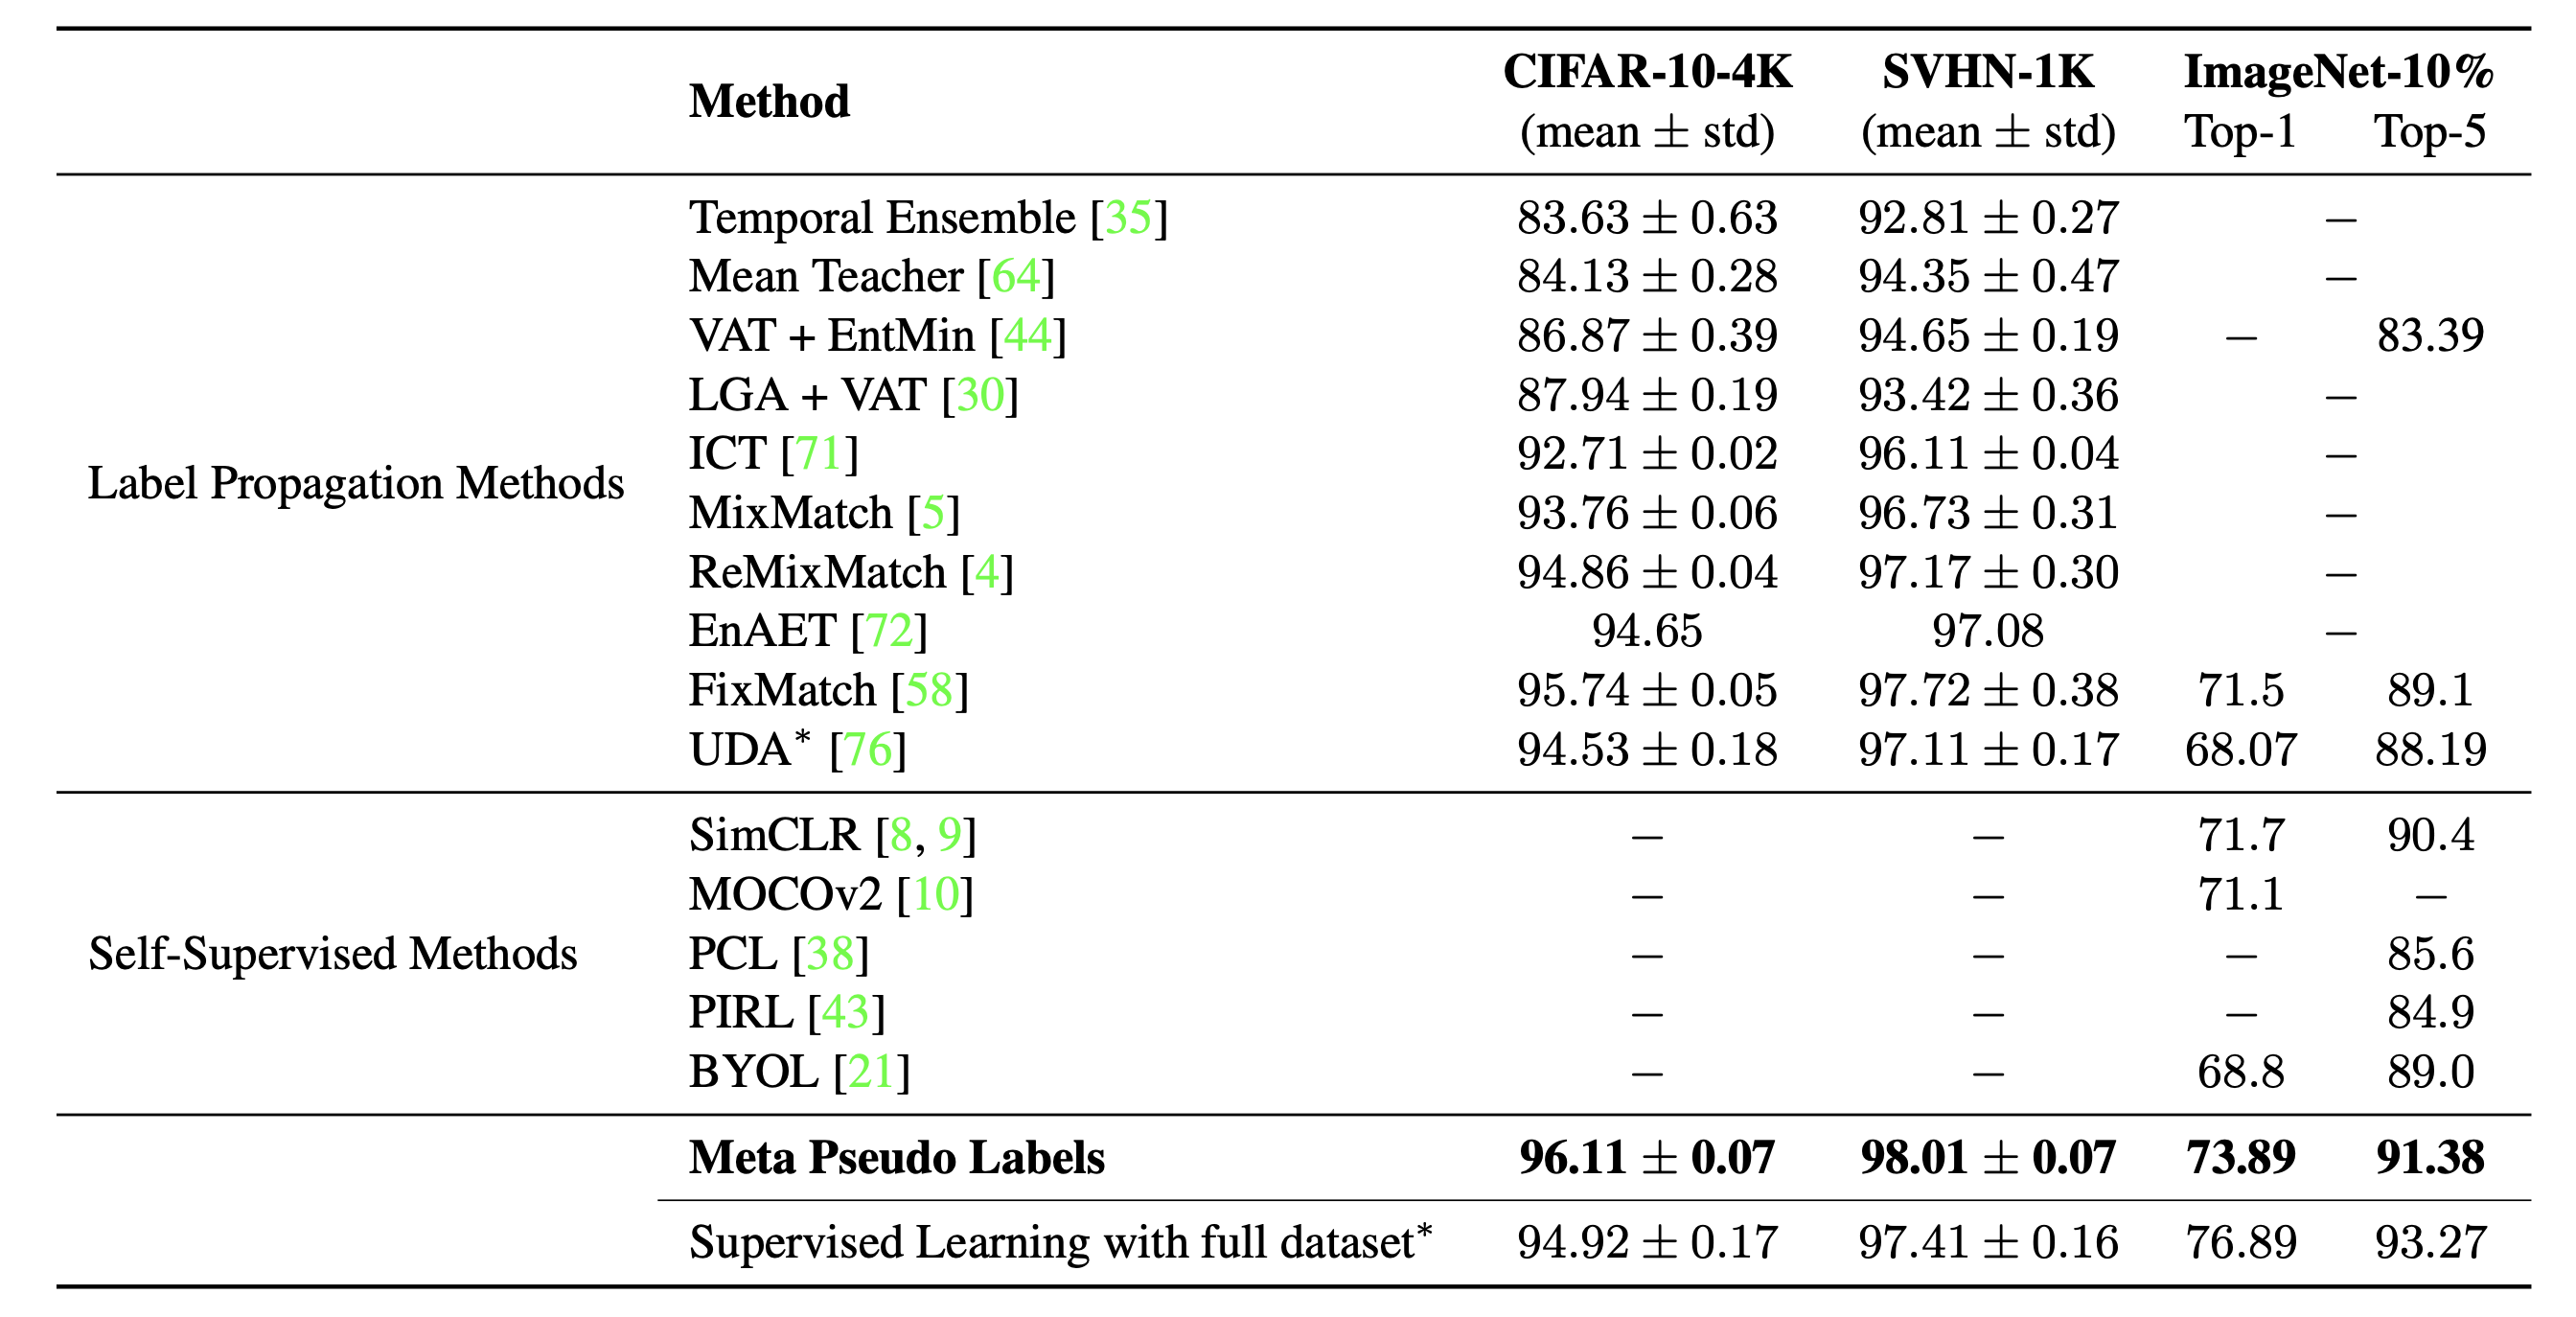
伪标签方法用模型预测为未标注数据打标签,但错误标签会导致确认偏差。文章提到多种缓解技术:置信度过滤(如FixMatch只保留高置信度预测)、锐化预测分布(降低温度T)、MixUp增强、以及元伪标签(Meta Pseudo Labels)让教师模型根据学生表现调整。这些策略共同目标是提高伪标签质量,避免学生模型过拟合错误标签。
半监督学习与预训练的结合及数据规模影响
文章强调,半监督学习可与预训练结合获得额外增益。实验表明,预训练在标注数据少时有益,数据多时可能无效甚至有害;自训练在数据多或强增强时有效,且能与预训练叠加。此外,更大的模型在少样本下表现更好,蒸馏未标注数据可进一步提升性能。读者需根据标注数据量决定是否采用预训练或自训练。
Q&A
半监督学习的损失函数通常由哪两部分组成?
半监督学习的损失函数通常由监督损失和无监督损失两部分组成,公式为 L = L_s + μ(t) L_u,其中 L_s 是监督损失,L_u 是无监督损失,μ(t) 是随时间增加的无监督损失权重。
一致性正则化方法的基本假设是什么?
一致性正则化假设神经网络中的随机性(如 Dropout)或数据增强变换不应改变模型对同一输入的预测。即对同一输入的不同扰动版本,模型应输出一致的预测。
FixMatch 是如何生成伪标签并利用未标注数据的?
FixMatch 对未标注样本进行弱增强,生成伪标签,并只保留预测置信度高于阈值 τ 的伪标签。然后,模型学习在强增强样本上预测这些伪标签。
半监督学习中的确认偏差是什么?如何减少?
确认偏差是指不完美的教师模型提供错误伪标签,学生模型可能过拟合这些错误标签。减少方法包括:使用 MixUp 与软标签、设置每个 mini-batch 中标注样本的最小数量、对伪标签分布进行锐化、以及使用高置信度过滤等。
Mean Teacher 与 Temporal Ensembling 在更新目标上有何不同?
Temporal Ensembling 维护每个训练样本的模型预测的指数移动平均(EMA)作为学习目标,每个 epoch 更新一次。Mean Teacher 则跟踪模型权重的移动平均,而不是模型输出,从而克服目标更新缓慢的问题。
半监督学习与预训练结合时有哪些关键发现?
关键发现包括:预训练在低数据量时有益,高数据量时可能有害;自训练在高数据量或强增强时有益,甚至可弥补预训练的不足;自训练与预训练可叠加提升;联合训练监督和自监督目标有助于解决预训练与下游任务的不匹配;自训练计算成本高于微调。
