


LEAF:前沿文本嵌入模型的蒸馏
内容提要
MongoDB Research 提出 LEAF 知识蒸馏框架,可将大型文本嵌入模型压缩为小型学生模型,且学生与教师模型嵌入空间兼容,便于非对称部署。基于此发布两个2300万参数模型:mdbr-leaf-ir 专注检索与RAG,mdbr-leaf-mt 面向分类、聚类等通用任务。二者可在纯CPU、物联网和移动设备上运行,性能保留教师模型最高97%,体积小5–15倍、速度快7–24倍,并以 Apache 2.0 开源。
延伸解读
非对称部署的实用价值
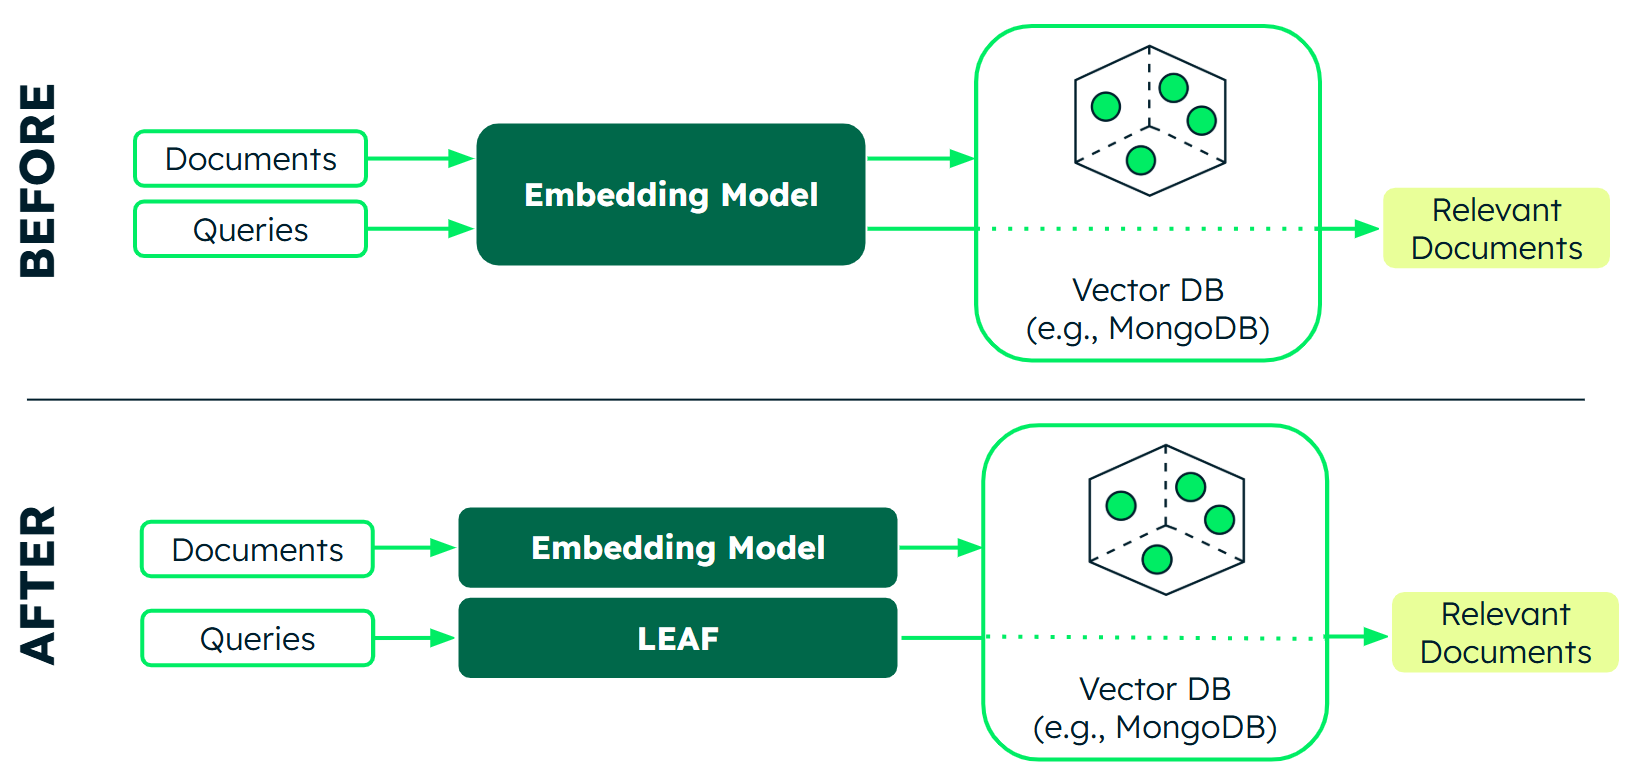
LEAF 的核心创新是学生模型与教师模型嵌入空间兼容,这允许非对称架构:文档用大模型离线嵌入,查询用小模型实时编码。文章指出,文档索引不频繁且可容忍高延迟,而查询需满足严格延迟目标。这种分离让系统在保持检索质量的同时,大幅降低查询时的计算开销,尤其适合大规模检索场景。
训练效率与数据要求
与传统对比学习需要标注判断和难负样本不同,LEAF 无需标注数据,且偏好小批量训练,仅用单张 A100 GPU 即可完成蒸馏。这降低了训练门槛,使资源有限的团队也能定制嵌入模型。此外,学生模型自动继承教师的 MRL 和量化鲁棒性,无需额外训练。
性能与部署权衡
两个 2300 万参数模型在各自基准上表现突出:mdbr-leaf-ir 在 BEIR 上 nDCG@10 达 53.55,接近 OpenAI text-embedding-3-large 的 55.43;mdbr-leaf-mt 在 MTEB v2 上得分 63.97。它们体积小 5–15 倍、速度快 7–24 倍,可在纯 CPU、物联网和移动设备上运行,全精度内存占用仅 87MB,适合无 GPU 或成本敏感的场景。
使用限制与注意事项
文章明确说明,这些模型由 MongoDB Research 的 ML 团队开发,以 Apache 2.0 许可“按原样”提供,不附带任何明示或暗示的支持,且截至写作时未用于 MongoDB 的商业产品或服务。因此,读者在采用时需自行评估和承担风险,并注意模型虽可微调,但初始性能基于特定教师模型和训练数据。
Q&A
LEAF 是什么?它主要解决什么问题?
LEAF(Lightweight Embedding Alignment Framework)是 MongoDB Research 提出的一个知识蒸馏框架,用于将大型文本嵌入模型压缩为小型学生模型。它主要解决现代嵌入模型参数规模爆炸、部署不灵活(需 GPU)以及不同模型间嵌入不兼容导致更换模型需重新计算所有文档嵌入的问题。
LEAF 蒸馏出的学生模型和教师模型在嵌入空间上兼容吗?有什么好处?
是的,LEAF 的学生模型与教师模型嵌入空间兼容,两者产生的文本嵌入可以互操作。这允许非对称部署,例如用大型教师模型嵌入文档(索引),而用小型 LEAF 模型编码查询,从而在保证检索质量的同时大幅降低查询延迟。
mdbr-leaf-ir 和 mdbr-leaf-mt 这两个模型分别适用于什么场景?
mdbr-leaf-ir 专为信息检索任务优化,如语义搜索和 RAG 的检索阶段;mdbr-leaf-mt 则面向更广泛的 NLP 任务,如分类、聚类、句子相似度和摘要。两者均为 2300 万参数,可在纯 CPU、物联网和移动设备上运行。
LEAF 模型在性能和效率上相比教师模型表现如何?
LEAF 模型能保留教师模型最高 97% 的性能,同时体积小 5–15 倍,速度快 7–24 倍。例如,mdbr-leaf-ir 在 BEIR 基准上平均 nDCG@10 为 53.55,接近教师模型 snowflake-arctic-embed-m-v1.5 的水平,而参数量仅 23M。
使用 LEAF 训练学生模型需要哪些数据和硬件条件?
LEAF 不需要标注数据,训练数据获取简单,不同于需要 judgment 和硬负例的对比学习。硬件方面,LEAF 偏好小批量,因此可以在单张 A100 GPU 上完成蒸馏训练,而传统方法往往需要 GPU 集群。
LEAF 模型是否支持量化?部署时吞吐量大概多少?
是的,LEAF 模型自动继承教师模型对输出量化的鲁棒性,并提供多种量化版本以进一步提升吞吐量、减少内存占用。全精度版本内存占用 87MB,在 2vCPU 实例上典型吞吐量为每秒 120 次查询和每秒 20 个文档。
