Jev是TypeSafe AI推出的模型,输入文本和问题即返回概率数字,具备零样本泛化与校准保证。Jimothy将Jev的判断蒸馏为本地小分类器,用Jev标注的数据训练,实现毫秒级推理、离线运行且无需API费用。风险在于教师偏差可能被学生放大、训练数据可能含噪声标签、概率校准未必可靠。因此它适合任务固定、错误成本低的粗分类,不适合风控、医疗等高风险场景。
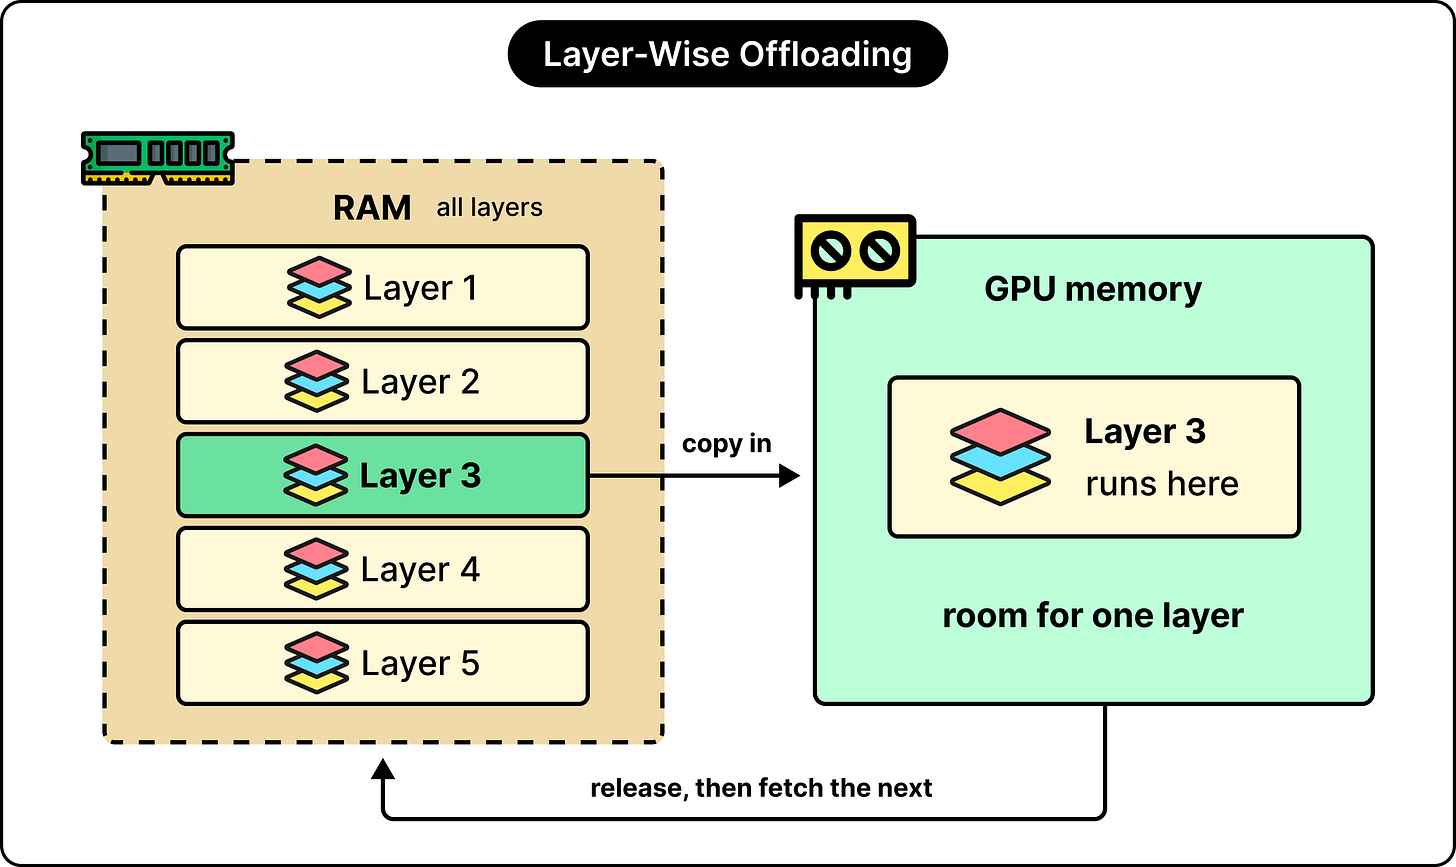
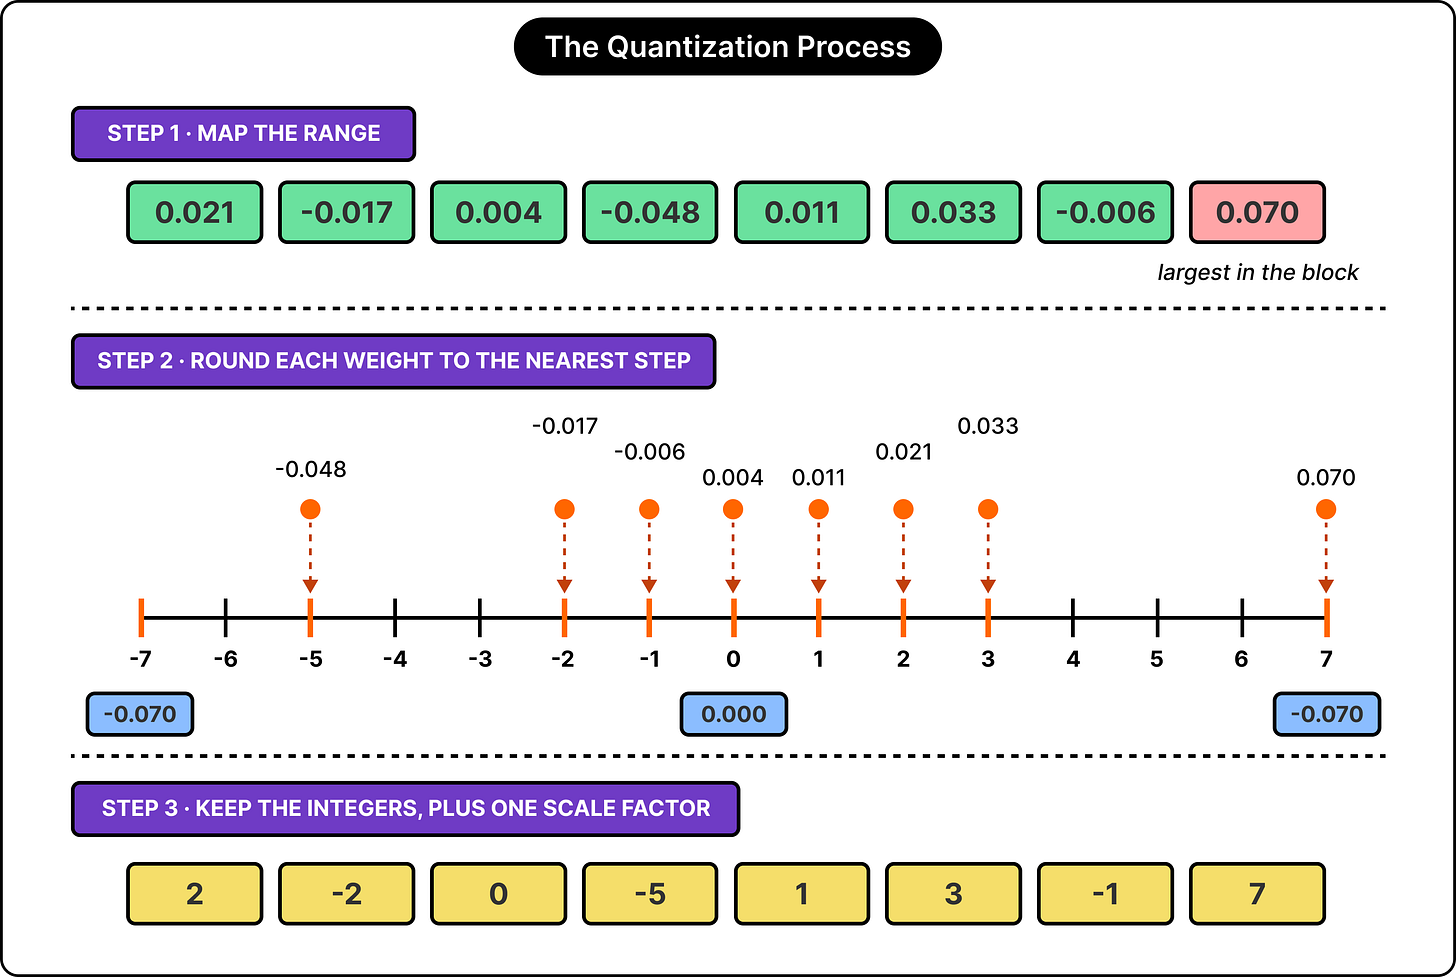
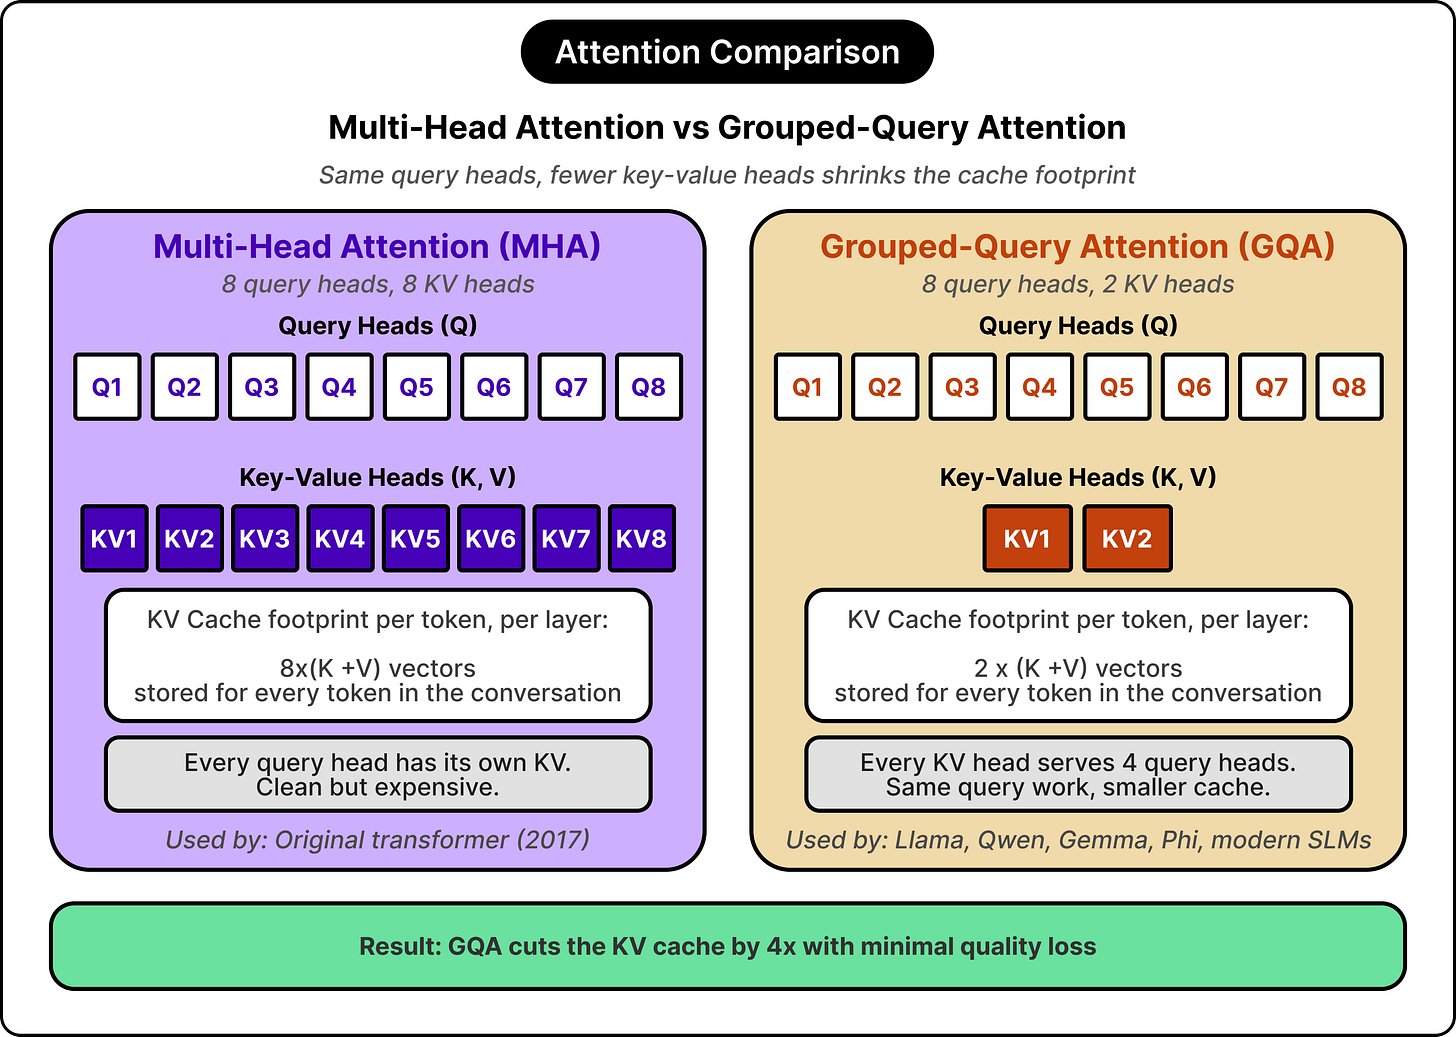
大模型在普通硬件上运行需降低内存占用与计算量。主要技术包括:量化压缩权重精度(如8B模型从16GB降至4GB)、分层卸载按需将权重移入GPU、混合专家仅激活部分参数、蒸馏用小模型学习大模型、剪枝去除低贡献权重、推测解码用小模型预生成再验证。KV缓存和FlashAttention等软件优化也能提升效率。目标是在硬件预算内平衡质量与响应速度。
Meta FAIR与华盛顿大学提出字节级蒸馏新方法,将教师模型的Token概率分布转换为字节级目标,让学生模型直接学习字节分布。实验以Llama 3-8B为教师,提出Marginalize-It和End-Of-Token两种方案。End-Of-Token蒸馏下游准确率上限达52.4%,比传统Token蒸馏高4个百分点,且存储更省,但训练计算量更高。
作者提出“AI的逗号”观点:大AI时代过度依赖AI,导致人的知识能力难以沉淀,缺乏基础体系与实践经验,难以理解前沿学科,最终人类知识被AI蒸馏,无人真正掌握知识,科学发展停滞。
本文介绍了三种压缩大型语言模型的技术:量化、剪枝和知识蒸馏,它们能在不显著降低智能水平的前提下减小模型规模。这些技术可叠加使用,但各有取舍,如量化可能损失细微理解力,剪枝影响复杂逻辑,蒸馏可能缺乏原创性。选择哪种技术取决于模型的具体应用目标。
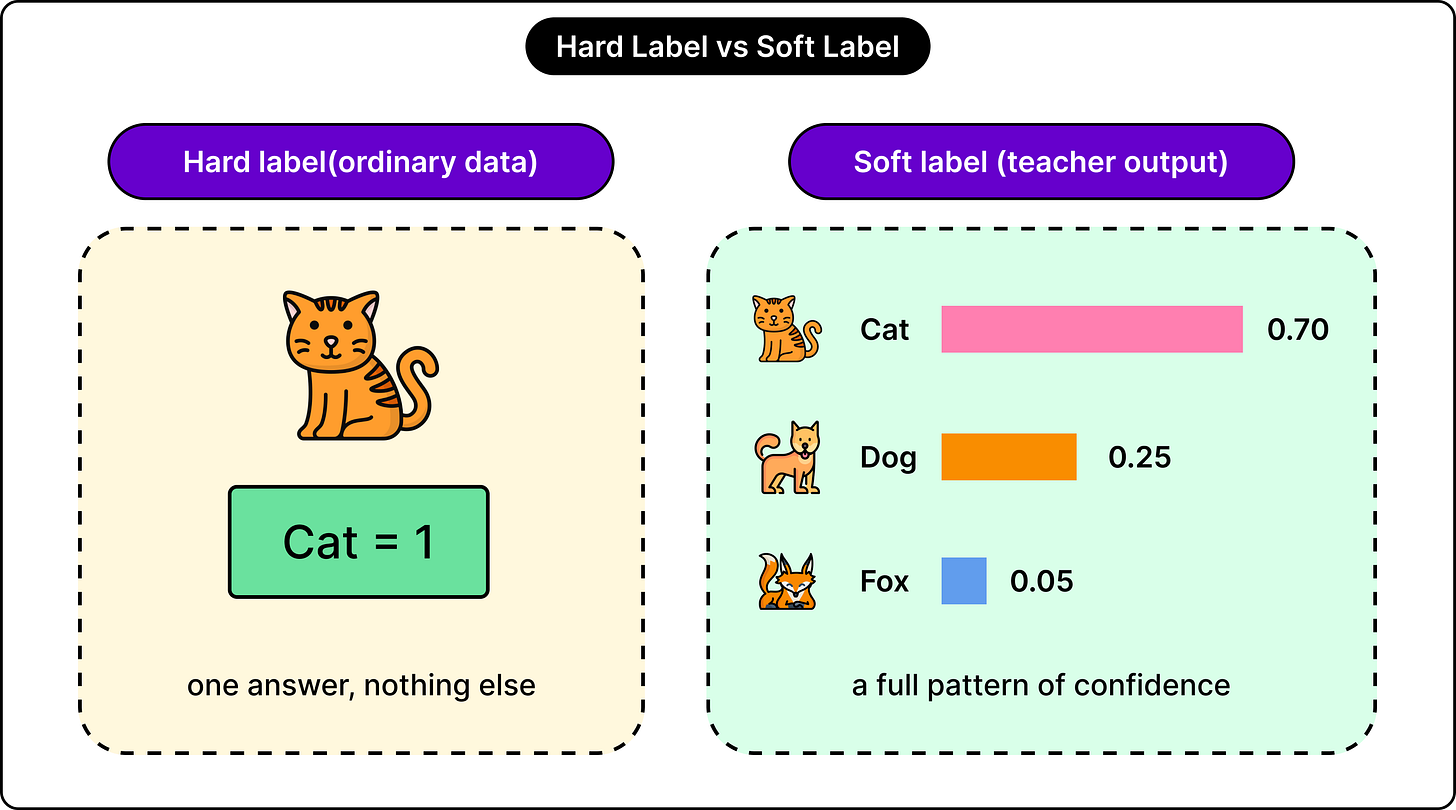
知识蒸馏是一种训练小型模型模仿大型模型行为的方法,与模型压缩不同,它生成独立模型。通过软标签传递更多信息,学生模型能超越原始数据学习。主要方法包括输出蒸馏、特征蒸馏和合成数据蒸馏,其中合成数据蒸馏最常用。蒸馏在窄任务上表现优异,但受限于教师模型能力、容量差距和架构影响,且可能传递非预期特征。自动化蒸馏正减少人工干预。
小型和大型语言模型因设计约束不同而异。小型模型适用于设备,内存和延迟有限;大型模型在数据中心运行,资源更充裕。两者基于变换器架构,小型模型通过数据质量、知识蒸馏和过度训练提高效率。生产系统通常结合两者,利用小型模型处理常规请求,大型模型应对复杂任务。
近期,Anthropic指控中国三家AI公司通过虚假账号与其模型对话,涉嫌违规“知识蒸馏”。专家指出,蒸馏技术在AI发展中重要,但其合法性存在争议。中国企业需提升技术实力与合规体系,以应对全球竞争与规则挑战。
intellij-community 是 IntelliJ IDEA 的开源代码库,支持 IDE 的开发与定制,提供源码和构建指导。TTPForge 是网络安全框架,模拟攻击者活动以提升检测能力。gpt-tokens 用于计算 OpenAI GPT 消息的令牌消耗,适合开发者。distill-sd 是知识蒸馏模型,提供快速图像生成。react-admin-ui 是构建管理界面的 React 组件库。
设备导向语音检测(DDSD)是一项二元分类任务,旨在区分用户对语音助手的查询与背景对话。本文提出了一种新型知识蒸馏方法,通过从大型预训练声学编码器中转移知识,显著提升DDSD的准确性。实验结果显示,该方法在关键词和无关键词调用中,分别提高了26%和19%的错误率,并在不同模型架构中展现出良好的泛化能力。
本文介绍了DiceHuBERT,一种用于压缩HuBERT的知识蒸馏框架。与传统方法不同,DiceHuBERT通过直接替换原始模型为学生模型,利用HuBERT的自蒸馏机制进行训练。实验结果显示,DiceHuBERT在音素识别和自动语音识别(ASR)性能上显著优于现有方法,提升超过21%和14%。
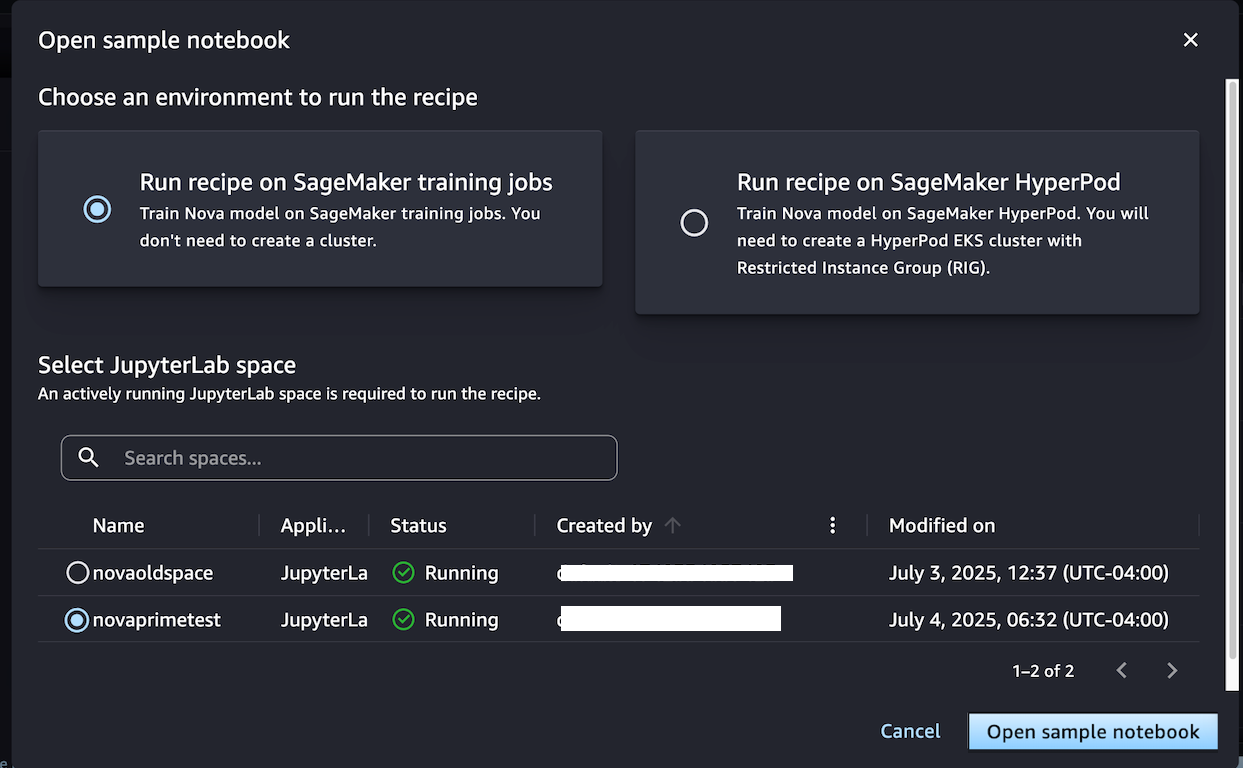
Amazon SageMaker AI为Amazon Nova推出定制功能,支持模型训练的各个阶段。客户可根据需求选择有监督微调、对齐、持续预训练和知识蒸馏等技术,以优化模型性能,满足特定的准确性和成本要求。
本研究提出了UWSAM模型和UIIS10K数据集,旨在解决水下实例分割中的技术不足。通过知识蒸馏和自动生成水下提示,显著提高了分割的准确性和效率,推动了水下视觉任务的发展。
本研究提出了DeepKD框架,旨在解决知识蒸馏中目标类与非目标类知识冲突及低置信度噪声问题。通过双重解耦和自适应去噪,显著提升了知识转移效果。
本研究探讨了问答系统中链式推理生成的可解释追踪与最终性能之间的关系。研究表明,基于规则的问题分解方法并不总能确保模型输出正确答案,挑战了知识蒸馏的假设。
本研究提出了一种基于时间序列的知识蒸馏策略,用于锂离子电池容量衰减预测。经过微调的Battery-Timer模型展现出强大的零-shot泛化能力,显著提升了专家模型的多条件泛化能力。
UniME框架由格灵深瞳和阿里ModelScope等团队联合发布,刷新了MMEB训练榜纪录。该框架通过文本判别知识蒸馏和困难负样本增强微调,显著提升了多模态理解能力,适用于多种下游任务,并已开源。
Falcon 3是阿布扎比技术创新研究所开发的高效开源AI语言模型,参数不超过100亿,适用于科学、数学和编程。该模型结合知识蒸馏和预训练技术,易于集成,适合开发者和研究人员。
本文探讨了大语言模型(LLMs)在资源受限环境中的优化问题,综述了知识蒸馏、模型量化和模型剪枝等压缩技术,提供了有效的解决方案和成功案例,为研究者和从业者在边缘设备上优化LLM提供参考。
DEEVISum(蒸馏早期退出视觉语言模型用于摘要)旨在提升视频分段摘要的性能与效率。通过多模态提示和多阶段知识蒸馏,DEEVISum在保持性能的同时显著降低推理时间,F1得分达到61.1,展现出与更大模型的竞争力。
完成下面两步后,将自动完成登录并继续当前操作。