

给 Agent 造一座记忆塔(一):扁平存储与一次性压缩之间
内容提要
忆时塔(Chronomem)是一种介于扁平存储与一次性压缩之间的Agent记忆架构:记忆按时间分层堆叠,越久越粗;底层原始条目append-only永不删除,上层摘要带引用可审计下钻。其核心是区分精确回想(沿引用链下钻,服务端零LLM)与语义回想(读LLM摘要,有损压缩),并强调摘要本身是时序条目,可递归自底向上总结。系统以MCP服务形式提供,含五道护栏控制成本。
延伸解读
记忆架构的第三条路:时间分层
现有Agent记忆方案要么扁平存储导致无法概览,要么一次性压缩丢失原始证据。忆时塔提出按时间分层堆叠记忆,越久越粗,底层原始条目append-only永不删除,上层摘要带引用可审计下钻。这种设计借鉴了日报体系和财务汇总报表的纪律:明细不可变、可审计下钻、幂等重算。它试图在细节保全和压缩之间找到平衡,让Agent既能精确回想原始事件,又能快速获取长期概览。
精确回想与语义回想的成本真相
文章将回想拆分为两条路径:精确回想沿引用链下钻到原始条目,服务端零LLM调用,但返回原始体量,客户端注入prompt时token成本随体量增长;语义回想读取LLM生成的摘要,服务端有LLM成本,但返回体量小。因此精确回想并非端到端免费,而是将成本转移给客户端。这一区分明确了不同回想方式的适用场景和代价,帮助开发者根据保真度与成本需求做出选择。
语义总结的护栏与递归设计
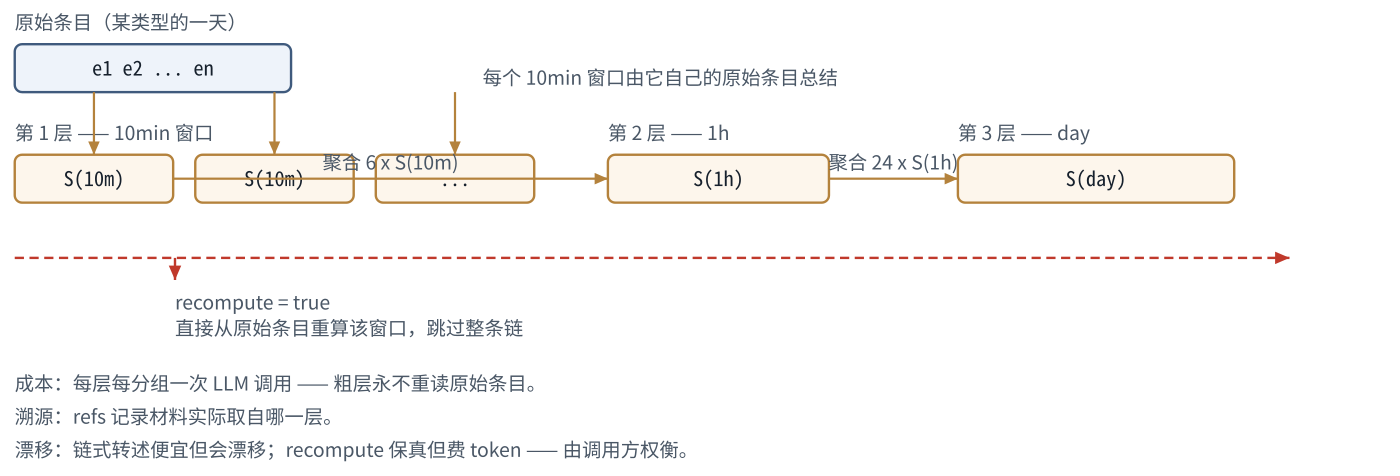
语义总结可能悄悄烧token,忆时塔通过五道护栏控制成本:只总结已闭合窗口且有沉降期、按窗口幂等、空窗口跳过、连续失败退避并放弃、每轮提交数上限。摘要作为时序条目append-only,可递归自底向上总结,粗粒度总结成本为每个分组一次调用。recompute可绕过链条直接从原始条目重算,在链式转述的漂移与重算的保真之间,将权衡交给调用方。
实现现状与待解局限
文章明确区分已实现与规划中功能:记忆类型、粒度链、引用链物化、语义摘要、护栏调度、MCP工具面等已实现;数值聚合、保留期、鉴权等仍在规划。两处局限值得注意:粗粒度视图只反映上次物化前的记录,可能返回陈旧但自洽的窗口;保留期仅声明式,实际全量保留。这些诚实交代有助于读者评估系统成熟度与适用边界。
Q&A
忆时塔(Chronomem)是什么?它想解决现有Agent记忆方案的哪些问题?
忆时塔是一种介于扁平存储与一次性压缩之间的Agent记忆架构。它解决扁平存储无压缩、无法回答长期概览的问题,以及一次性压缩破坏原始证据、无法重新推导的问题。
忆时塔的架构是如何分层的?粒度链可以怎么配置?
记忆按时间堆叠成塔,一层一个物化粒度,越久越粗、越久越高。粒度从{10min, 30min, 1h, 3h, day, week, month}中选取,默认10min→30min→1h→day→week。粒度链按记忆类型配置,高频通道保留分钟级,稀疏通道用day→week即可。
精确回想和语义回想有什么区别?成本上有什么不同?
精确回想沿引用链下钻到原始条目,服务端不调LLM,无损,返回原始体量;语义回想读LLM生成的窗口摘要,服务端调LLM,有损,返回摘要体量。成本上,精确回想服务端零token但客户端注入原始条目成本高;语义回想服务端有LLM成本但客户端注入摘要文本更小。
忆时塔如何实现递归总结?摘要为什么可以递归?
摘要作为SummaryRecord追加到该类型的.summary series,和原始条目一样是一等公民,因此可以被再次总结。总结默认自底向上:先确保每个更细子窗口有摘要,再用子摘要聚合。recompute可直接从原始条目重算,绕过链条。
语义总结有哪些护栏来控制成本?
五道护栏:1)只总结最近一个已闭合窗口且有沉降期;2)按窗口、按分组幂等,成功即清空重试账;3)空窗口零成本跳过;4)连续失败退避,到上限登记为已放弃并留痕;5)每轮提交数有上限。语义总结按类型opt-in,默认关闭。
忆时塔为什么做成MCP服务?它和主题记忆系统有什么区别?
做成MCP服务是为了让异构工具共享同一个记忆底座,零代码耦合。与主题记忆系统(如LLM wiki)按主题/语义词条组织不同,忆时塔按时间组织,类比账本,两者互补:一个回答“怎么发生的”,一个回答“是什么”。
忆时塔目前有哪些已实现和未实现的功能?
已实现:记忆类型、类型级粒度链、日历对齐自然窗口、引用链物化+exact下钻、语义摘要+递归总结、带护栏的定时自动总结、MCP工具面(13个mem/*)、内嵌Web控制台、会话活动自动采集。规划中:数值聚合、保留期/淘汰、MCP resources、鉴权/加密/多租户。
