


19世纪热物理中的数学如何帮助大语言模型理解句子
内容提要
傅里叶研究热传导的正弦余弦函数,现被用于大语言模型的位置编码。注意力机制不感知词序,需将位置转为数值表示。正弦余弦编码具有多频率、有界、平移一致的特点,模型经训练可借此理解语序;RoPE则将其用于旋转查询和键。
延伸解读
位置编码:从物理波到语言序
傅里叶用正弦余弦描述热传导,如今这些函数被用于大语言模型的位置编码。注意力机制本身不感知词序,需要将位置转为数值表示。正弦余弦编码具有多频率、有界、平移一致的特点,模型经训练可借此理解语序。RoPE则将其用于旋转查询和键,使注意力比较时依赖相对位置。
为何需要位置编码:注意力机制的盲区
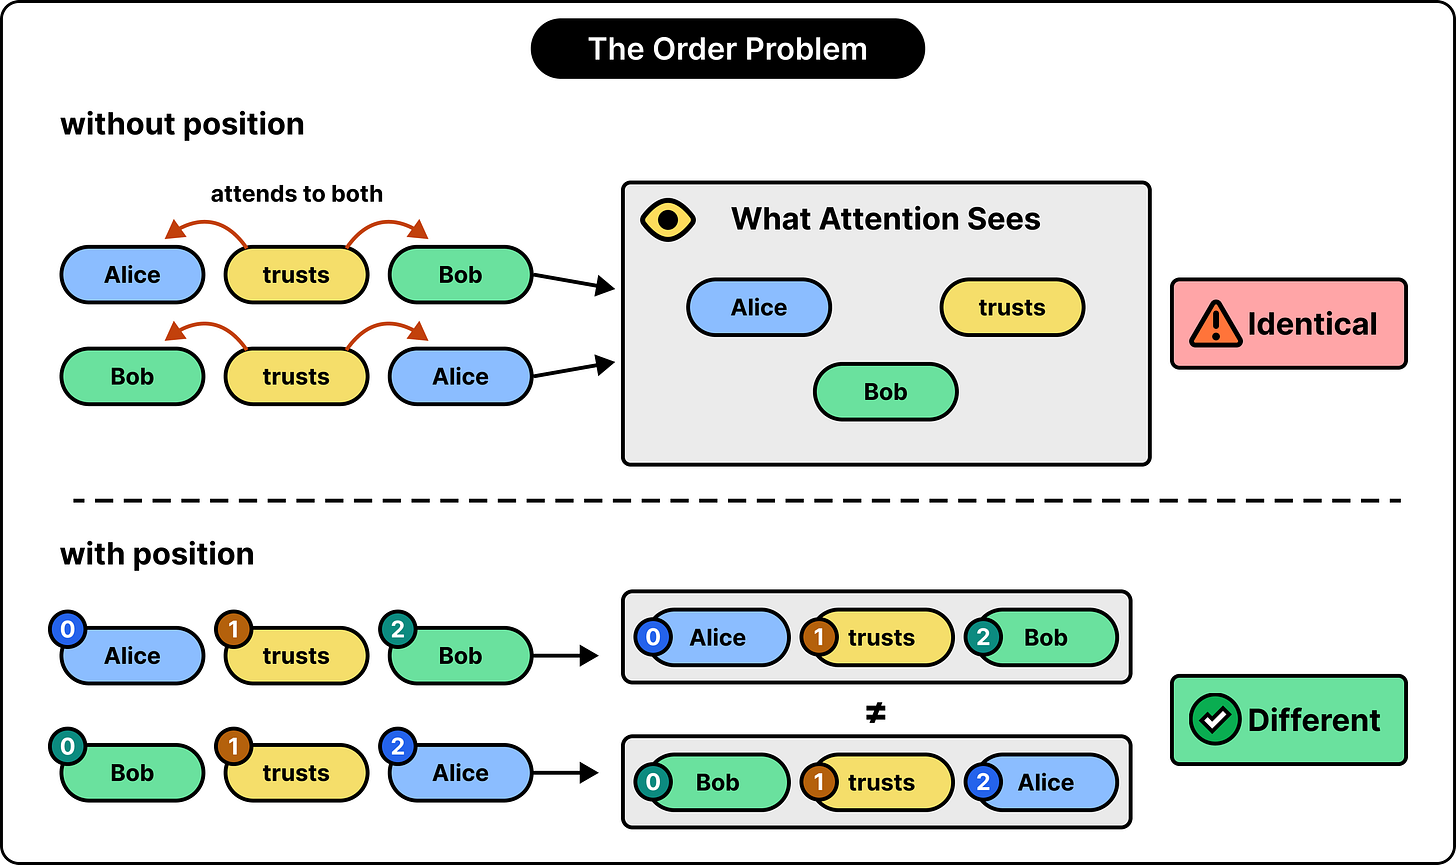
基础注意力机制对输入顺序不敏感,交换词序不会改变注意力计算的结果。例如“Alice trusts Bob”和“Bob trusts Alice”包含相同词,但含义不同。模型需要同时知道哪些词出现以及它们如何排列。位置编码将位置信息注入模型,使注意力能区分不同顺序,从而理解语法关系。
正弦余弦编码的优势与局限
正弦余弦编码使用多个频率,每个位置由不同频率的正弦和余弦值组成。这种编码值有界,且相对位置变化时旋转角度固定,便于模型学习平移不变的关系。但编码并非无限可区分,频率选择和数值精度会限制有效序列长度。模型需通过训练学会利用这些位置信息,而非自动获得语法规则。
位置编码的替代方案与注意事项
除了正弦余弦编码,还有可学习的位置嵌入和ALiBi等方法。可学习嵌入为每个位置分配可训练向量;ALiBi则根据 token 距离对注意力分数施加惩罚。此外,因果掩码本身也提供顺序信息,使模型即使没有显式位置编码也能学习位置行为。但能计算大位置编码不代表模型能理解任意长文档,内存和计算仍是限制。
Q&A
为什么大语言模型需要位置编码?
因为基本的注意力机制不感知词序,它只根据词的身份计算权重,无法区分“Alice trusts Bob”和“Bob trusts Alice”这类语序不同但词相同的句子。位置编码将位置转换为数值表示,使模型能利用语序信息。
正弦和余弦函数在位置编码中有什么作用?
正弦和余弦函数将位置转换为有界、多频率的数值模式。它们提供多个变化速率不同的分量,使不同位置有独特的编码,并且平移时旋转角度固定,便于模型学习相对位置关系。
RoPE(旋转位置嵌入)是如何工作的?
RoPE将查询和键的向量分量分组,并根据token位置用正弦和余弦函数旋转这些分组。当注意力比较旋转后的查询和键时,位置贡献取决于它们的相对旋转,从而编码相对位置。不同分量对以不同速度旋转,保留了多频率表示。
为什么位置编码要使用多个不同频率的旋转?
单一频率的旋转会在一个周期后重复,无法区分相隔一个周期的位置。使用多个不同频率的旋转,即使某些频率重复,其他频率仍能提供不同的读数,从而在更长的序列范围内区分位置。
位置编码如何与词嵌入结合输入模型?
原始Transformer将位置编码直接加到词嵌入上,即输入表示 = 词嵌入 + 位置编码。两者维度相同,对应分量相加。这样模型接收到的表示同时包含词的身份和位置信息,并在训练中适应这种组合。
除了正弦余弦编码,还有哪些位置编码方法?
还有可学习的位置嵌入(为每个位置分配可训练向量)和ALiBi(根据token间距离对注意力分数施加惩罚)。此外,因果掩码本身也能提供一定的顺序信息。
