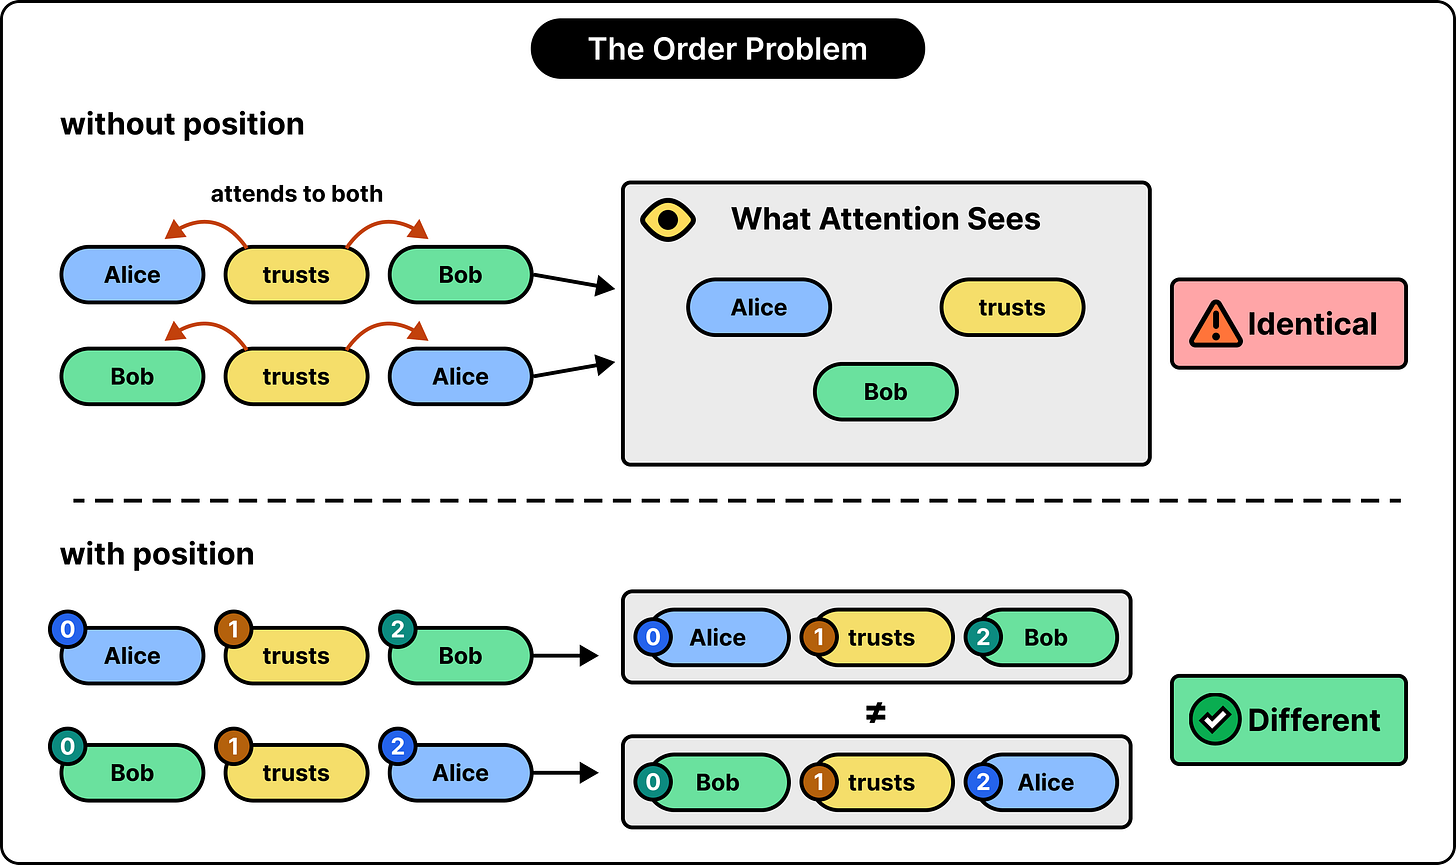
傅里叶研究热传导的正弦余弦函数,现被用于大语言模型的位置编码。注意力机制不感知词序,需将位置转为数值表示。正弦余弦编码具有多频率、有界、平移一致的特点,模型经训练可借此理解语序;RoPE则将其用于旋转查询和键。
RoPE通过旋转Q和K向量,使注意力分数依赖相对位置而非绝对位置。它利用多频率几何级数实现多尺度位置感知,保持向量范数,支持位置平移不变性。但存在周期性和相位混叠问题,长上下文需频率缩放或位置插值。RoPE不旋转V,无学习参数,是LLM中关键的位置编码方法。
RayRoPE是一种针对多视角Transformer的位置编码方法,利用预测的射线点进行几何感知编码,通过查询帧投影坐标实现SE(3)不变性和多频相似性,并处理预测不确定性。实验表明,该方法在新视图合成和立体深度估计任务上优于现有方案,在CO3D数据集上LPIPS指标提升15%,且能有效整合RGB-D输入。
本文讨论了基于注意力的编码解码模型(AED)与长音频编码的兼容性问题,并提出了四项改进措施以提高模型在长段落解码中的准确性。这些措施包括引入绝对位置编码、扩展音频上下文训练、段落拼接和语义分割,从而缩小了连续与分段音频编码之间的准确性差距。
这篇文章介绍了Transformer模型的结构和关键概念。Transformer通过注意力机制替代RNN,解决了序列建模中的上下文依赖问题。引入位置编码使模型能够感知token的位置信息,注意力机制包括自注意力和交叉注意力。编码器和解码器结构相似,但解码器使用因果掩码以确保生成序列的自回归特性。整体上,Transformer实现了高效的并行计算和长距离依赖处理。
本文探讨了长上下文模型的工程挑战与解决方案,包括位置编码、注意力计算复杂度、训练策略和推理优化。随着上下文长度增加,模型面临计算复杂度和显存限制。采用RoPE、YaRN等技术扩展位置编码,并结合线性注意力和稀疏注意力优化计算效率。在训练方面,采用短预训练与长继续预训练相结合的策略,推理时利用前缀缓存和KV压缩等技术提高效率。
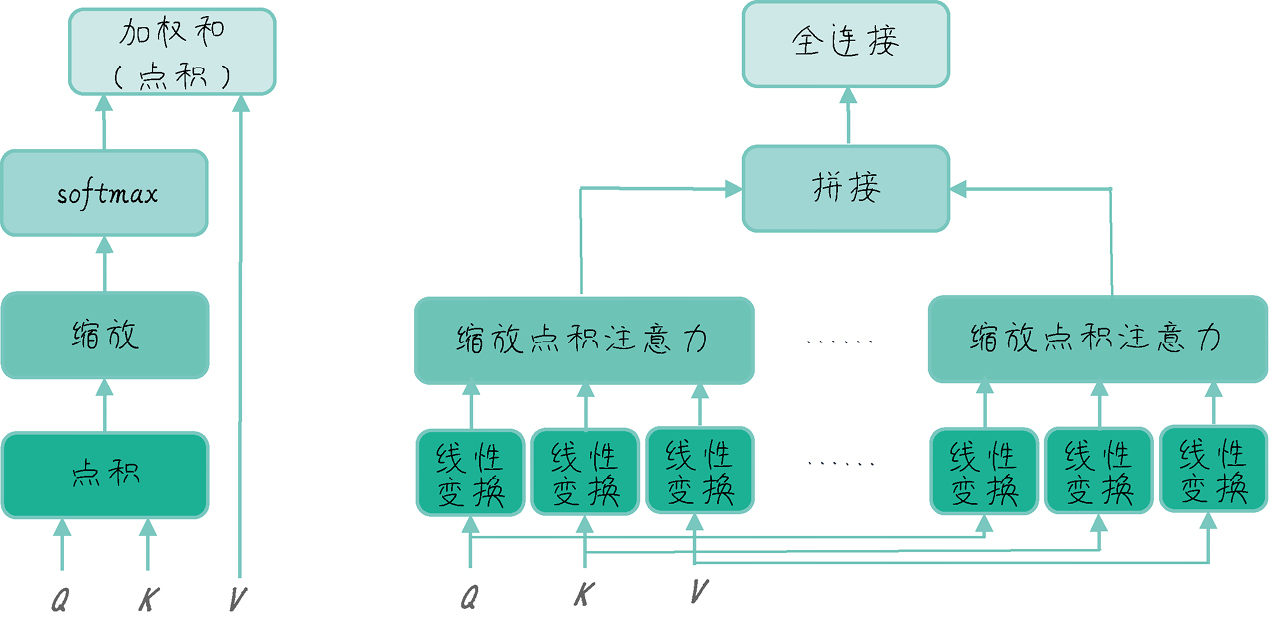
本文探讨了自注意力机制的核心概念及其与传统模型的比较。自注意力允许序列内的每个token相互沟通,解决了RNN的长依赖问题。由于自注意力对位置无知,需通过位置编码注入位置信息。多头注意力使不同头学习不同关系。尽管自注意力在长序列处理上表现优异,但其计算复杂度为O(N²),引发了对优化的研究。
《Attention Is All You Need》论文于2017年发表,提出了Transformer架构,摆脱了RNN和CNN,专注于并行化训练。其核心贡献包括多头自注意力和位置编码,显著提升了机器翻译的训练速度。尽管初期反响平平,但后来成为大语言模型的基础,影响深远。作者团队背景各异,后续大多离开Google,成为AI领域的重要人物。
本文讨论了Transformer模型中的位置编码,特别是正弦位置编码。由于自注意力机制的排列等变性,模型无法识别序列中token的顺序,因此需要引入位置信息。正弦位置编码通过sin和cos函数提供相对位置的线性表达能力,允许模型在不同位置之间进行有效学习。文章还探讨了绝对位置编码和相对位置编码的表现差异,强调了位置编码在模型性能和外推能力中的重要性。
变压器在机器学习中至关重要,推动了聊天机器人、搜索引擎和机器翻译的发展。freeCodeCamp.org推出了一门新课程,帮助初学者理解变压器架构的改进,内容涵盖位置编码、注意机制、归一化和激活函数等关键概念,适合学生和工程师,观看时间为3小时。
本文探讨了位置编码在处理不同长度序列时的插值和外推方法。正弦编码和RoPE能够轻松进行外推,而学习编码仅支持插值。YaRN方法通过不均匀缩放RoPE频率,提升了模型在长序列上的表现,使其能够在不重新训练的情况下处理更长的输入序列。
本文介绍了变换器模型中的位置编码,强调其在自然语言处理中的重要性。位置编码帮助模型理解词语顺序,主要有四种类型:正弦位置编码、学习位置编码、旋转位置编码和相对位置编码。每种编码方式各有优缺点,正弦编码适用于长序列,学习编码适应数据特征,旋转编码提高性能,相对编码关注词间距离。
本研究提出了一种二维语义感知位置编码($ ext{SaPE}^2$),有效解决了现有位置编码无法捕捉图像补丁间语义关系的问题,从而显著提升了模型的泛化能力和视觉任务性能。
本文介绍了人工智能中的基本概念,包括分词、向量嵌入、位置编码和自注意力机制。分词将文本拆分为可处理单元,向量嵌入为单元赋予数学意义,位置编码帮助模型理解词序,自注意力机制使模型根据上下文理解词义。这些概念是现代大型语言模型理解和处理语言的基础。
本研究探讨了音乐生成中高效位置编码(PE)的应用挑战,并比较了不同的PE方法。提出的新方法RoPEPool通过提取时间序列的因果关系并结合结构先验,在旋律和声化任务中表现出优越性。
Qwen2.5-Omni实现了多模态AI的端到端感知与生成,支持实时交互。其核心技术包括时间对齐的多模态位置编码、Thinker-Talker架构和流式处理,适用于语音对话和视频分析等场景,标志着向通用人工智能的进步。
本研究提出了一种新型位置编码方法STRING,克服了大型语言模型中旋转位置编码的局限性。STRING在保持低计算开销的同时,实现了精确的平移不变性,并在视觉变换器中应用,显著提升了开放词汇物体检测和机器人控制的效果。
AIxiv报道了一种新型注意力机制——多矩阵分解注意力(MFA),该机制显著降低了语言模型的推理成本,并提升了性能。MFA在内存使用上节省高达93.7%,兼容多种位置编码,解决了大语言模型的显存瓶颈,推动了其应用。
本文研究了奇偶性语言的识别问题,提出了一种新型三层变压器,其参数矩阵和位置编码与输入长度无关,显著改进了Chiang和Cholak的构造,提高了处理效率和简洁性。
本研究提出了一种新方法,通过结合二次长度差异的位置编码(LDPE)在输入嵌入中,解决大语言模型生成结构化输出时的响应长度控制问题。实验结果表明,该方法能够在不影响响应质量的前提下,实现精确的长度控制。
完成下面两步后,将自动完成登录并继续当前操作。