为什么对于有的人来说 ChatGPT 并没有什么卵用?
内容提要
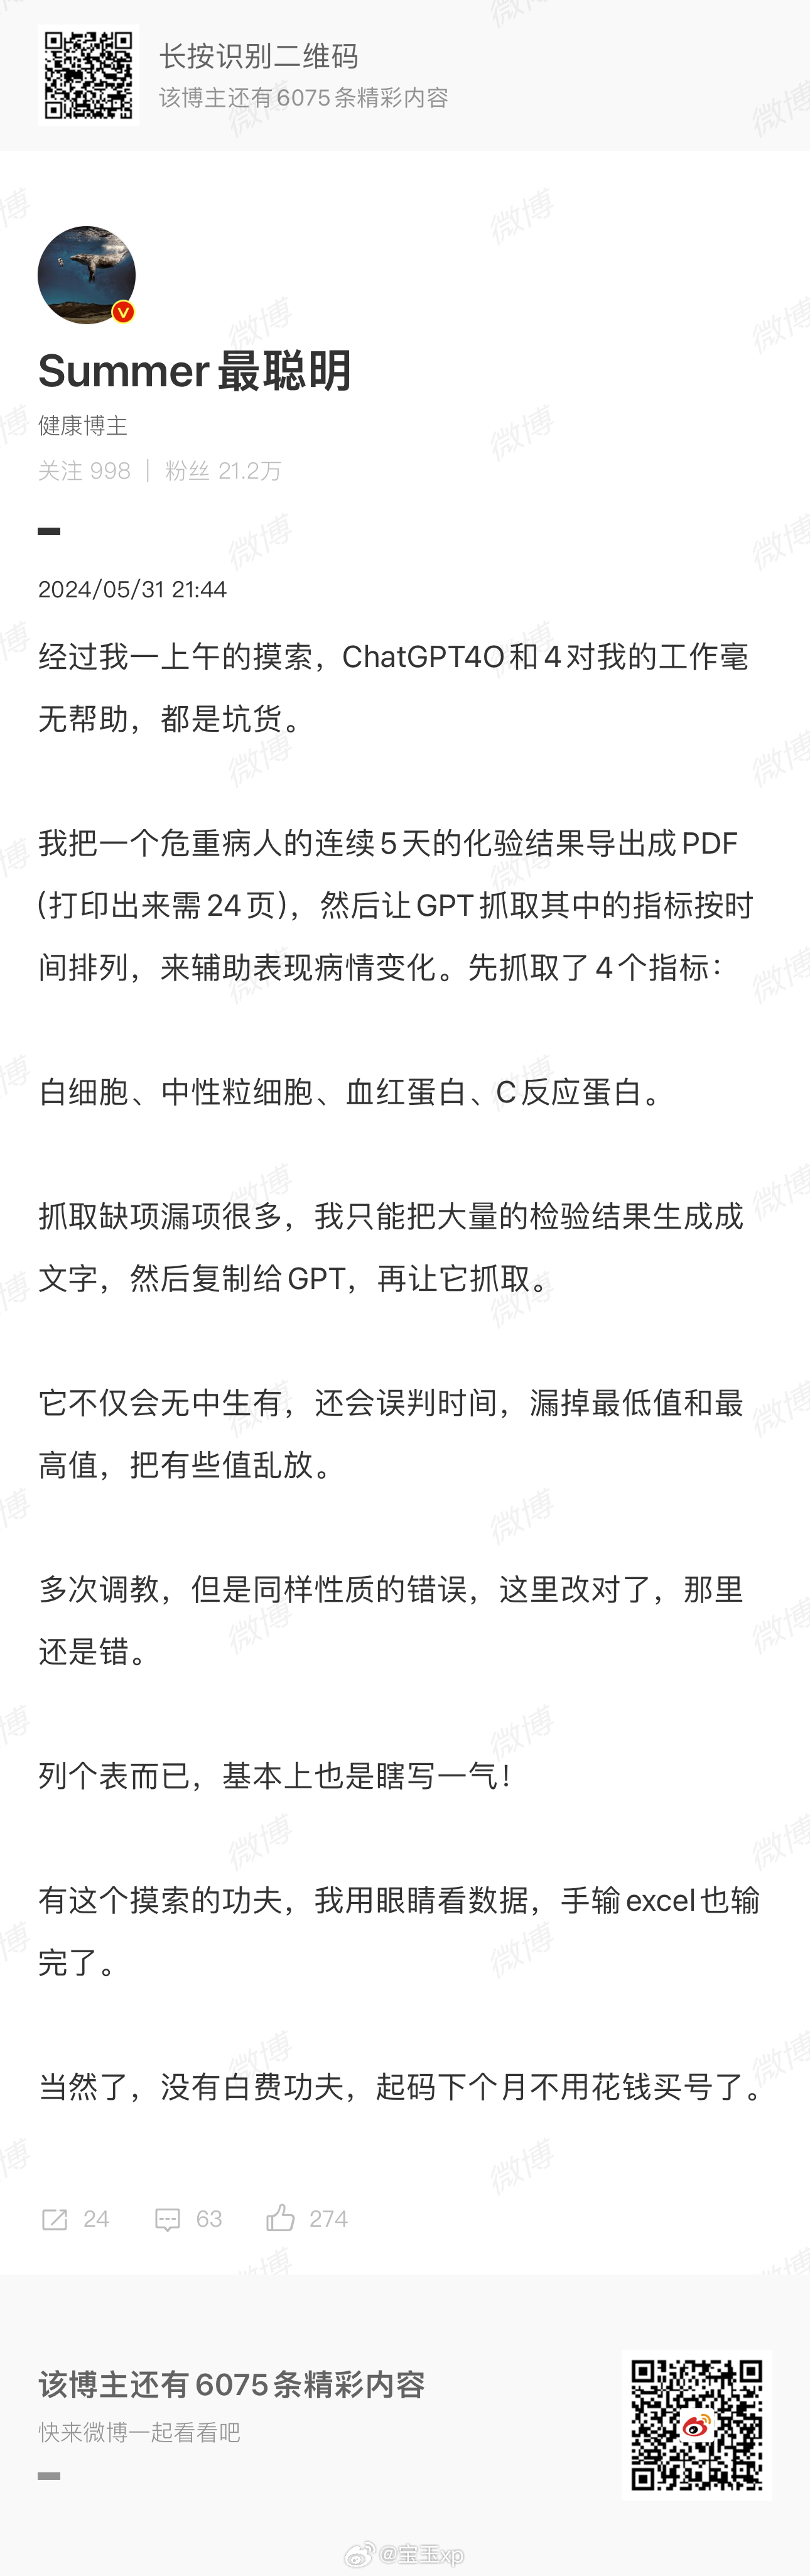
2024年6月2日,医生分享了使用ChatGPT-4o的经历,发现模型在处理医疗报告时存在问题:上下文窗口长度有限,输入过长影响生成效果;纯文本难以表达和解析结构化数据;模型推理能力较弱,需要提示工程。建议转换报告格式为LLM友好,预先分类内容,减小上下文窗口,二次处理模型结果。充分利用ChatGPT优势,转化高频使用场景为自动化工作流程。
延伸解读
上下文窗口的隐性限制
文章指出,ChatGPT-4o的上下文窗口上限为32K Tokens,但输入越长,生成质量越差、成本越高。医生一次性输入24页PDF,很可能超出或逼近窗口限制,导致抓取缺项漏项。这提醒我们,处理长文档时,应主动拆分内容,而非依赖模型一次性消化。
结构化数据在纯文本中的丢失
医疗报告中的表格、图表在转换为纯文本或复制粘贴时,行列关系会丢失,模型难以解析。文章建议使用Markdown、JSON等LLM友好格式表达结构化数据,例如GPT对JSON支持更好,Claude对XML支持更好。这能减少信息丢失,提升提取准确率。
推理能力不足与提示工程补救
模型推理能力较弱,难以自动完成多步任务。医生要求抓取4个指标并按时间排序,模型可能出错。通过提示工程,将任务拆解为列出所有指标、过滤目标指标、排序等步骤,并打印中间结果,可借助思维链(CoT)改善效果。
工作流配合比单点使用更重要
文章强调,现阶段AI远未达到AGI,需将AI作为工作流一环,上下游配合。例如,报告输出LLM友好格式、预先分类内容以减少上下文、对模型返回结果进行程序二次处理(如排序)。这需要医疗IT系统升级,超出医生个人控制范围。
Q&A
ChatGPT在处理医疗报告时存在哪些问题?
ChatGPT在处理医疗报告时存在上下文窗口长度有限、纯文本难以解析结构化数据和推理能力较弱的问题。
如何改善ChatGPT在医疗报告中的应用效果?
可以将报告格式转换为LLM友好的格式,预先分类内容以减少上下文窗口,并对模型返回的结果进行二次处理。
什么是提示工程,如何帮助ChatGPT处理复杂任务?
提示工程是通过在Prompt中将复杂任务拆分成简单步骤来引导模型,从而提高生成结果的准确性。
为什么上下文窗口长度会影响ChatGPT的生成效果?
上下文窗口长度限制了输入和输出的总字数,过长的输入会导致生成质量下降和成本上升。
ChatGPT对不同数据格式的支持情况如何?
ChatGPT对Markdown格式支持较好,对JSON支持更佳,而对XML的支持相对较弱。
如何将高频使用场景转化为自动化工作流程?
可以通过将LLM的文本处理能力与医疗IT系统结合,输出LLM友好的报告格式,并进行内容分类和二次处理。
