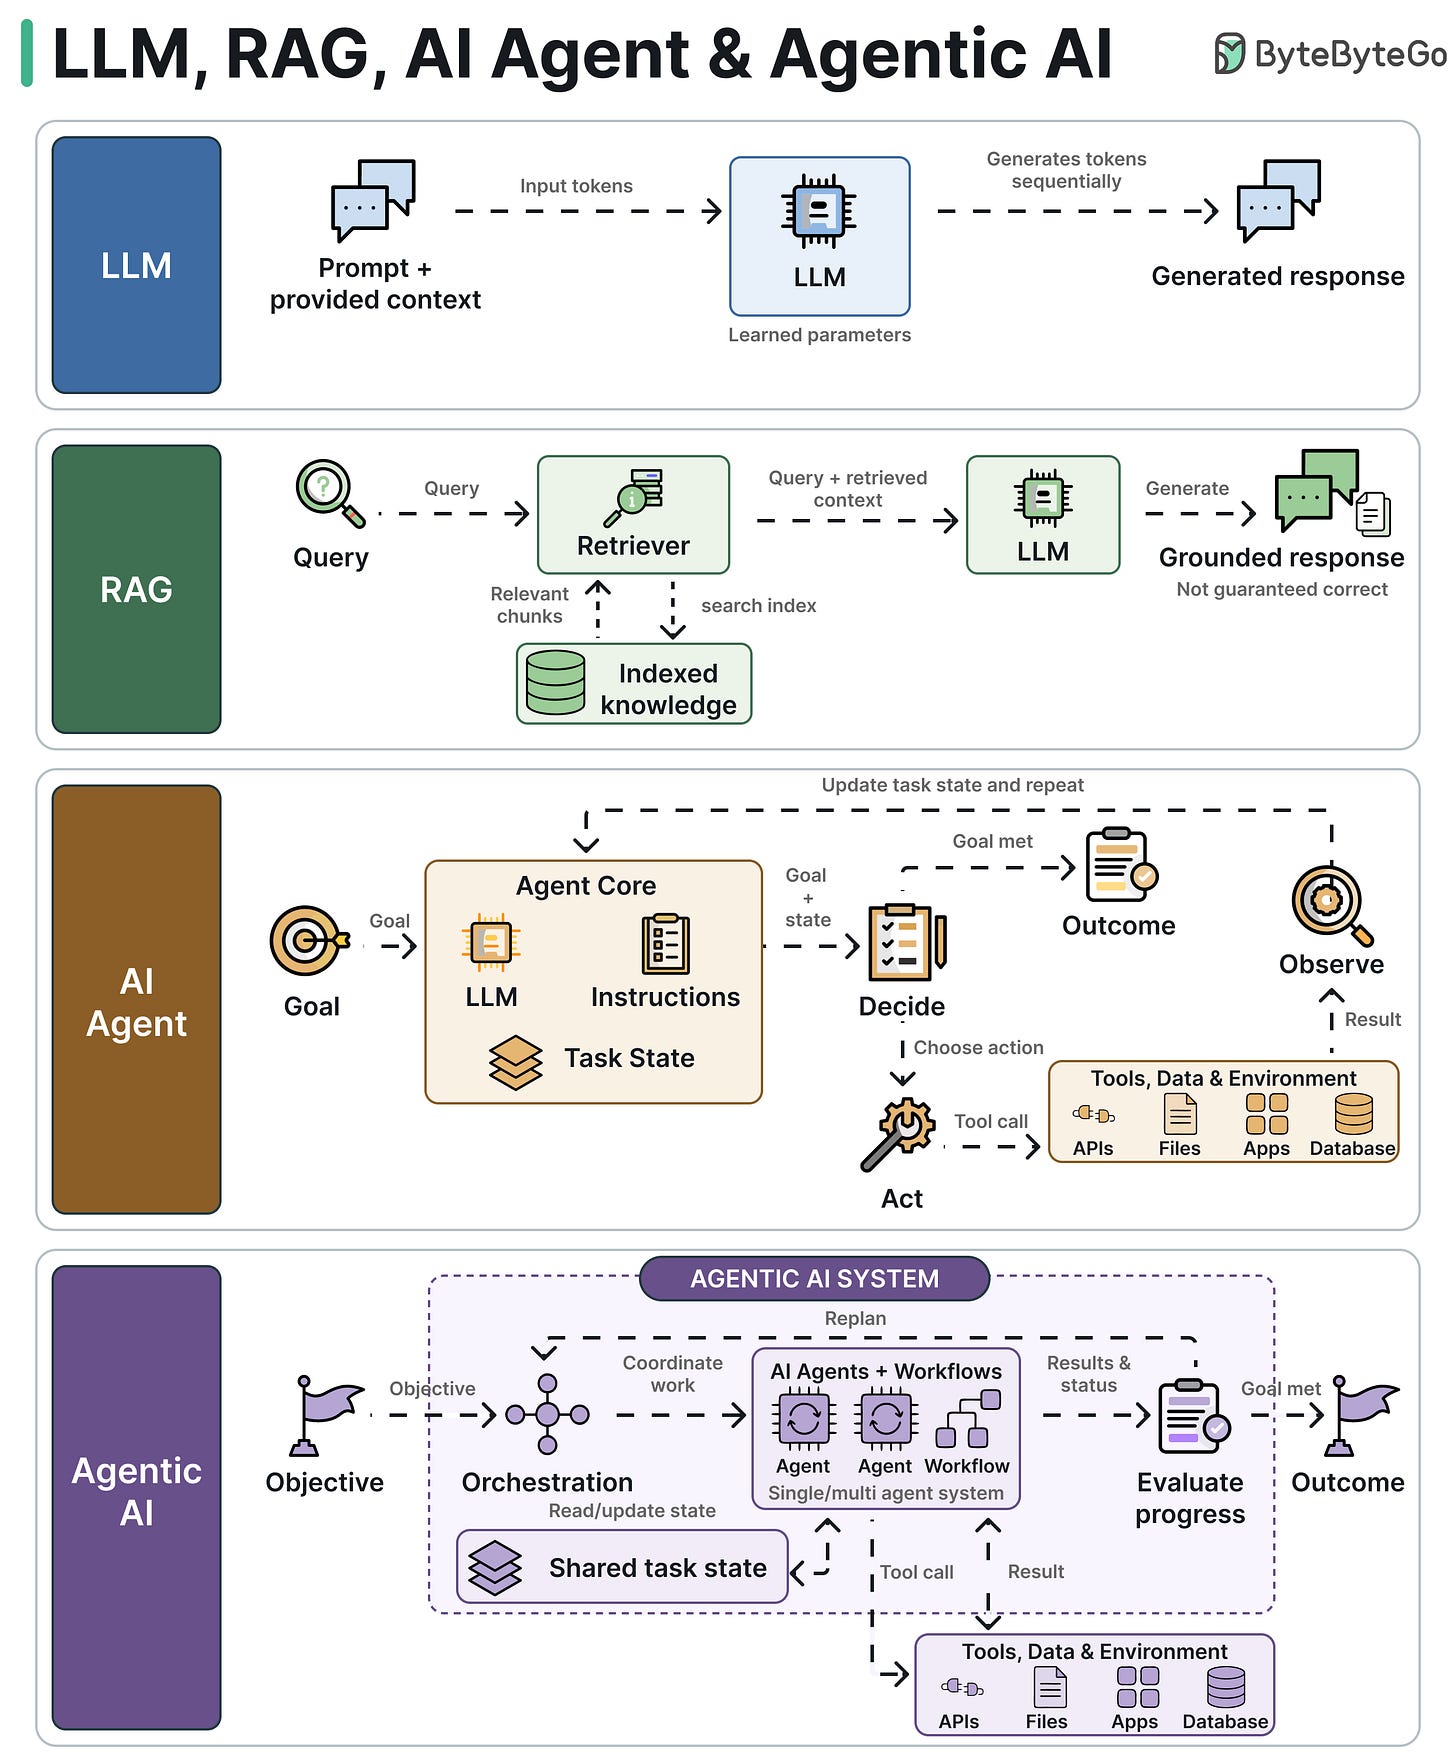
文章介绍Jev的九大用途:模型路由、安全护栏、工具调用权限分类、邮件分类、重排序、LLM评估、批量标注、实时决策和置信度门控,核心思路是用LLM负责生成、用Jev处理周边决策。文章还对比了LLM、RAG、AI代理与代理式AI,说明MCP与函数调用的区别,并列举Claude Code上下文窗口的九个来源。
文章澄清上下文窗口与KV Cache的区别:前者是单次请求的容量上限,后者是自回归解码中缓存历史Key/Value、以空间换时间的计算账本。DeepSeek V4.1 Flash将全局KV Cache降至每Token约890字节,但整机显存还需计入权重、并发等。长上下文不等于召回准,也不等于长期记忆,部署需实测峰值显存与延迟。
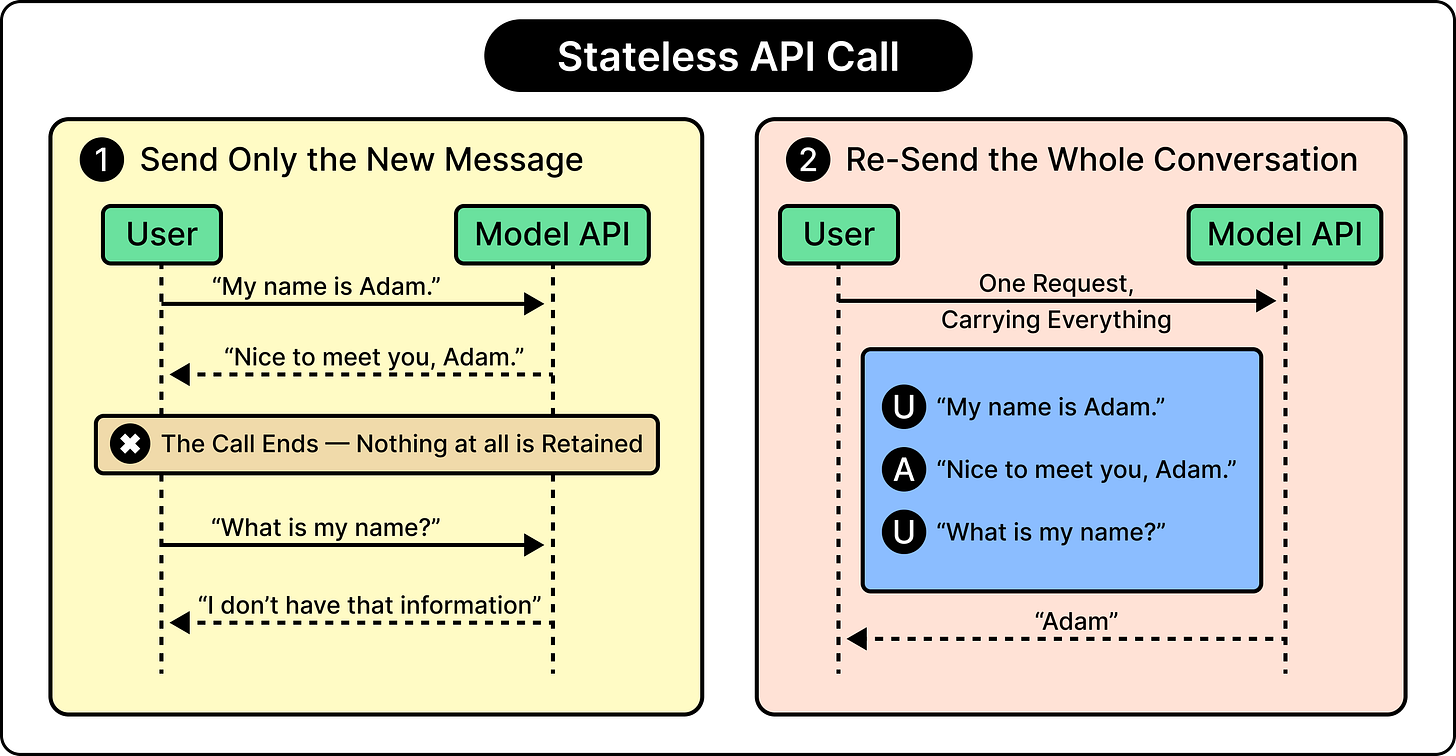
大语言模型无持久记忆,每次API调用均为无状态。对话中的“记忆”实为应用层在每次请求时重新发送历史消息、摘要或检索结果。上下文窗口是容量有限、成本随对话增长的临时工作记忆。为扩展记忆,应用常用滑动窗口、对话摘要、结构化提取、向量检索和用户画像等技术;跨会话记忆仍需将信息重新注入上下文。
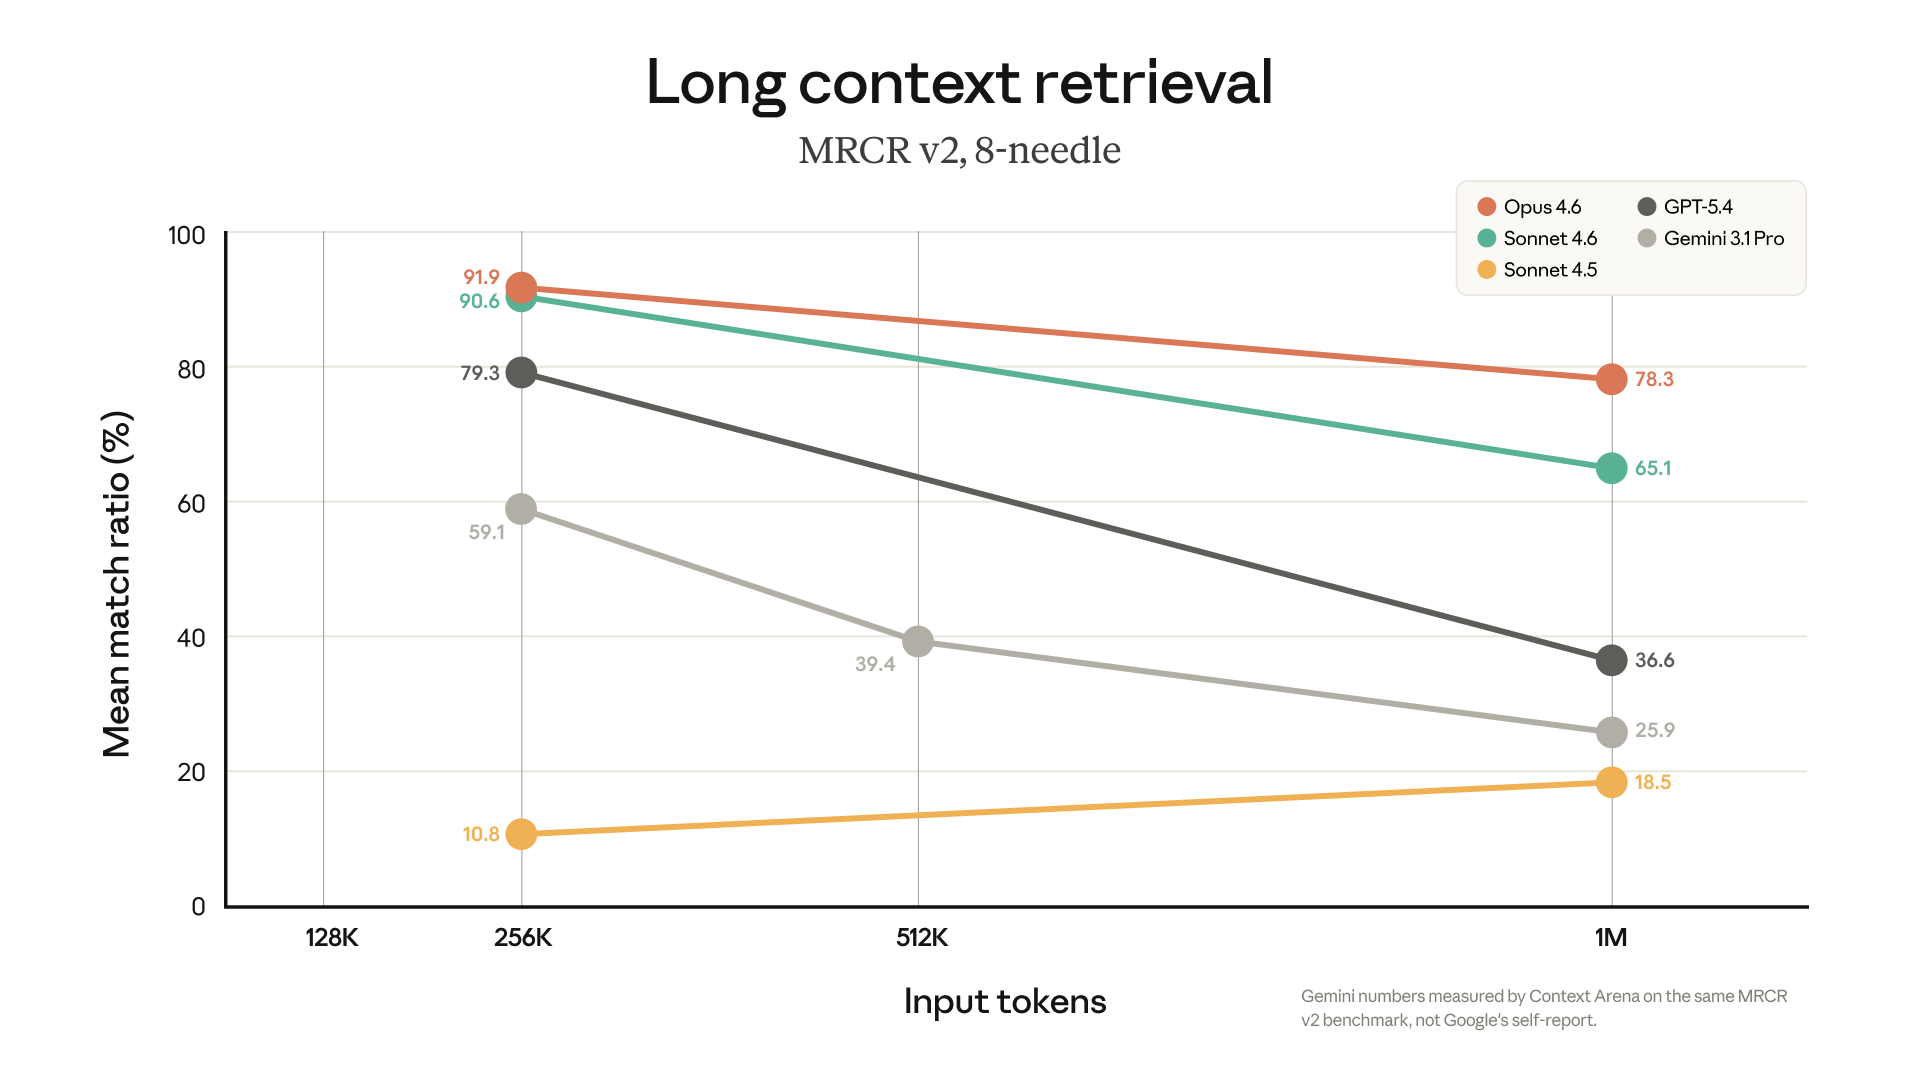
Claude Opus 4.6和Sonnet 4.6现已在Claude平台上推出,提供完整的100万上下文窗口。Opus 4.6的定价为每百万标记5美元/25美元,Sonnet 4.6为3美元/15美元。新版本支持更高的请求量和更长的上下文,提升了准确性,用户可以直接加载大量数据,保持对话完整。
OpenAI调整GPT-6 Astra在Codex中的计费政策:使用该模型时,1M上下文窗口内超出272K部分不再额外收费,全部按标准费率计费,且缓存输入免费。但此优惠仅限GPT-6 Astra与Codex组合,其他模型如GPT-5.4/5.5/5.6超长部分仍按1.5-2倍费率收费。
A社发布Claude Fable/Mythos 5.1模型,支持1M上下文窗口和128K输出,能力显著提升,尤其在科学和编程领域。API价格不变,但缓存读取价格暴降75%。Mythos 5.1放宽安全限制,仅限认证机构使用。
阿里发布Qwen 3.8 Flash模型,现已在AI Gateway上线。该模型支持文本和图像输入,上下文窗口达100万token,输出可达65k token,适用于编码、工具调用和多步代理工作流。用户可通过AI SDK设置模型,或连接Claude Code等编码代理使用。AI Gateway提供统一API、成本追踪、重试和故障转移等功能,且无加价和平台费用。
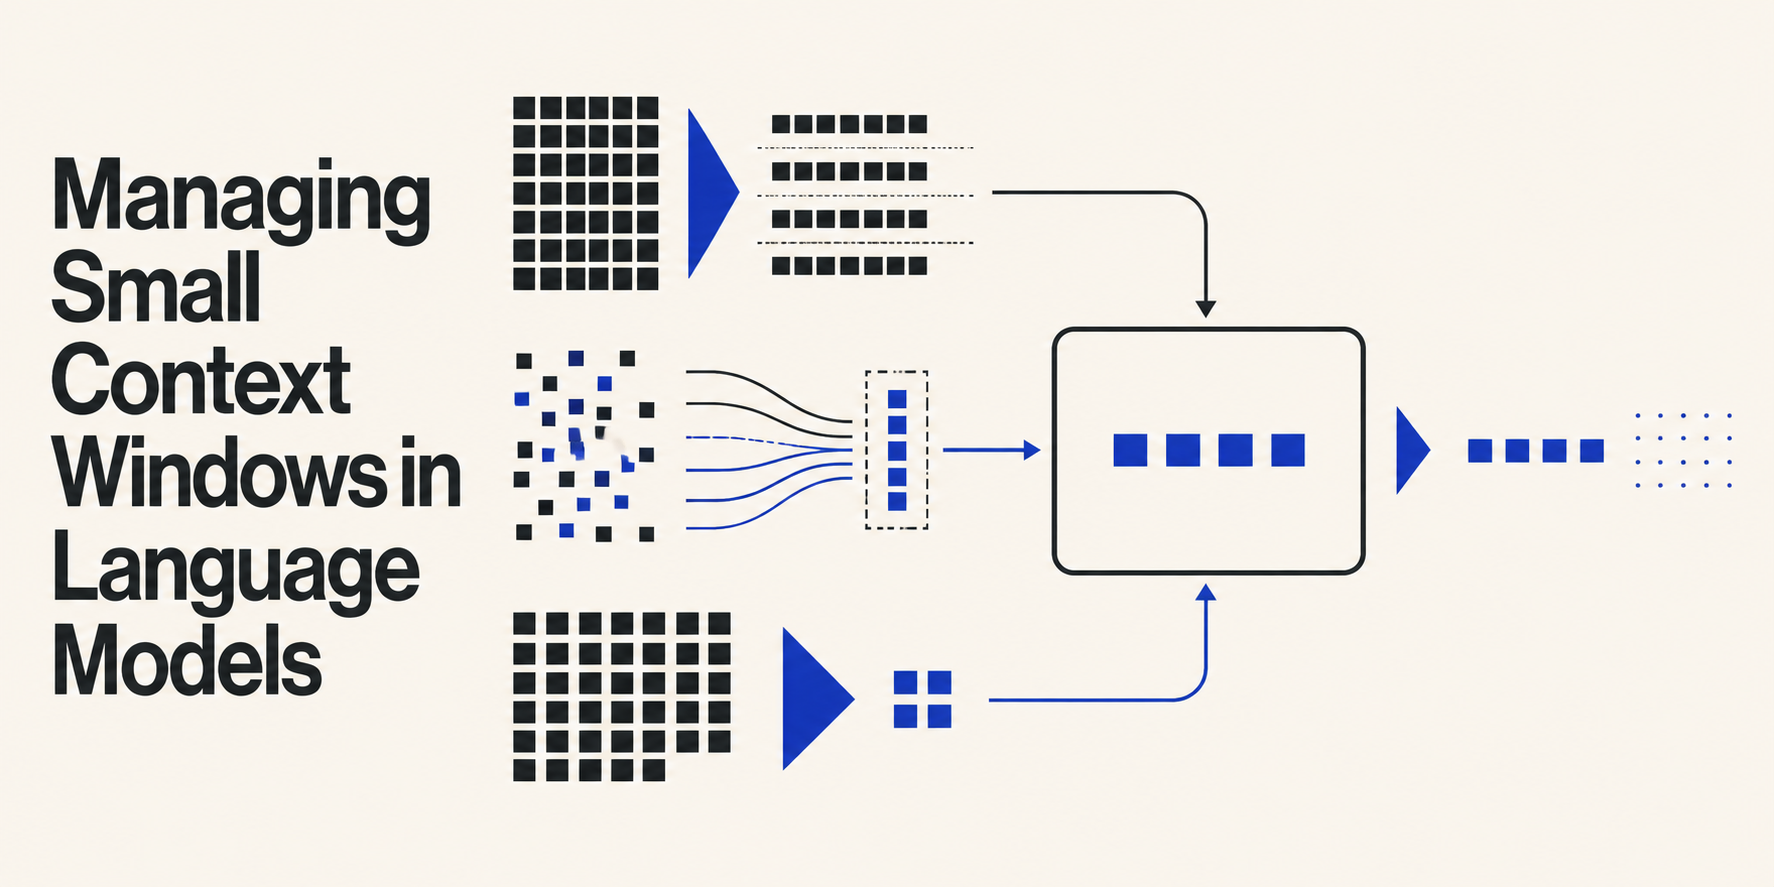
本文介绍管理大语言模型小上下文窗口的三种实用策略:滑动窗口截断法,通过FIFO队列保留最近对话,控制token使用;令牌预算结合检索增强生成,按比例分配上下文空间,确保只纳入最相关信息;以及滚动摘要、提示压缩和观察掩蔽等进阶方法。文章强调小上下文窗口能降低成本、减少延迟,并避免“迷失在中间”问题。
Codex现支持通过修改config.toml配置文件启用GPT-5.6模型的1M上下文窗口,默认272K,可在900K时自动压缩。但技术经理建议不修改,因1M窗口会更快消耗配额,当前配置已是最佳。ChatGPT订阅用户现也可体验此功能。
AI在数学竞赛中胜出,并非因推理更强,而是依靠近乎无限的上下文窗口,即外部工作记忆。人类数学受限于短期记忆容量,AI则能存储海量中间步骤,避免遗忘。其优势在封闭、可符号化的数学领域显著,但在开放日常推理中受限。本质是记忆碾压,而非深度思考超越。
深度求索发布DeepSeek-V4-Pro-0813版,从预览版正式进入GA阶段,模型ID不变,API定价暂未调整。该模型支持1M上下文窗口,提供Responses和Anthropic API,价格未变但已预告将涨价。目前未开源,基准测试数据待完善,内部数据显示多项测试较预览版大幅提升,编码、数学等核心任务保持开源领先,接近前沿闭源模型水平。
SpaceXAI推出Grok 4.6模型,现已在AI Gateway上线。该模型支持50万token上下文窗口,可处理文本和图像输入,提供低、中、高、超高四种推理级别,默认高。用户可通过AI SDK设置模型参数,或使用编码代理工具连接。AI Gateway提供统一API、成本追踪、重试和故障转移等功能,且无加价和平台费用。
本文面向重度使用Claude Code/Codex的工程师,解析上下文窗口、压缩与缓存三概念及其因果链。上下文是模型单次可见的输入输出总和,有硬上限且随token增多质量下降;压缩在窗口将满时用摘要替换历史,会永久丢失细节;缓存通过精确前缀匹配复用计算,失效仅增加成本与延迟,不影响正确性。实践建议:会话开头定好模型,中途只追加不修改,任务间用/clear,压缩趁缓存热时进行。
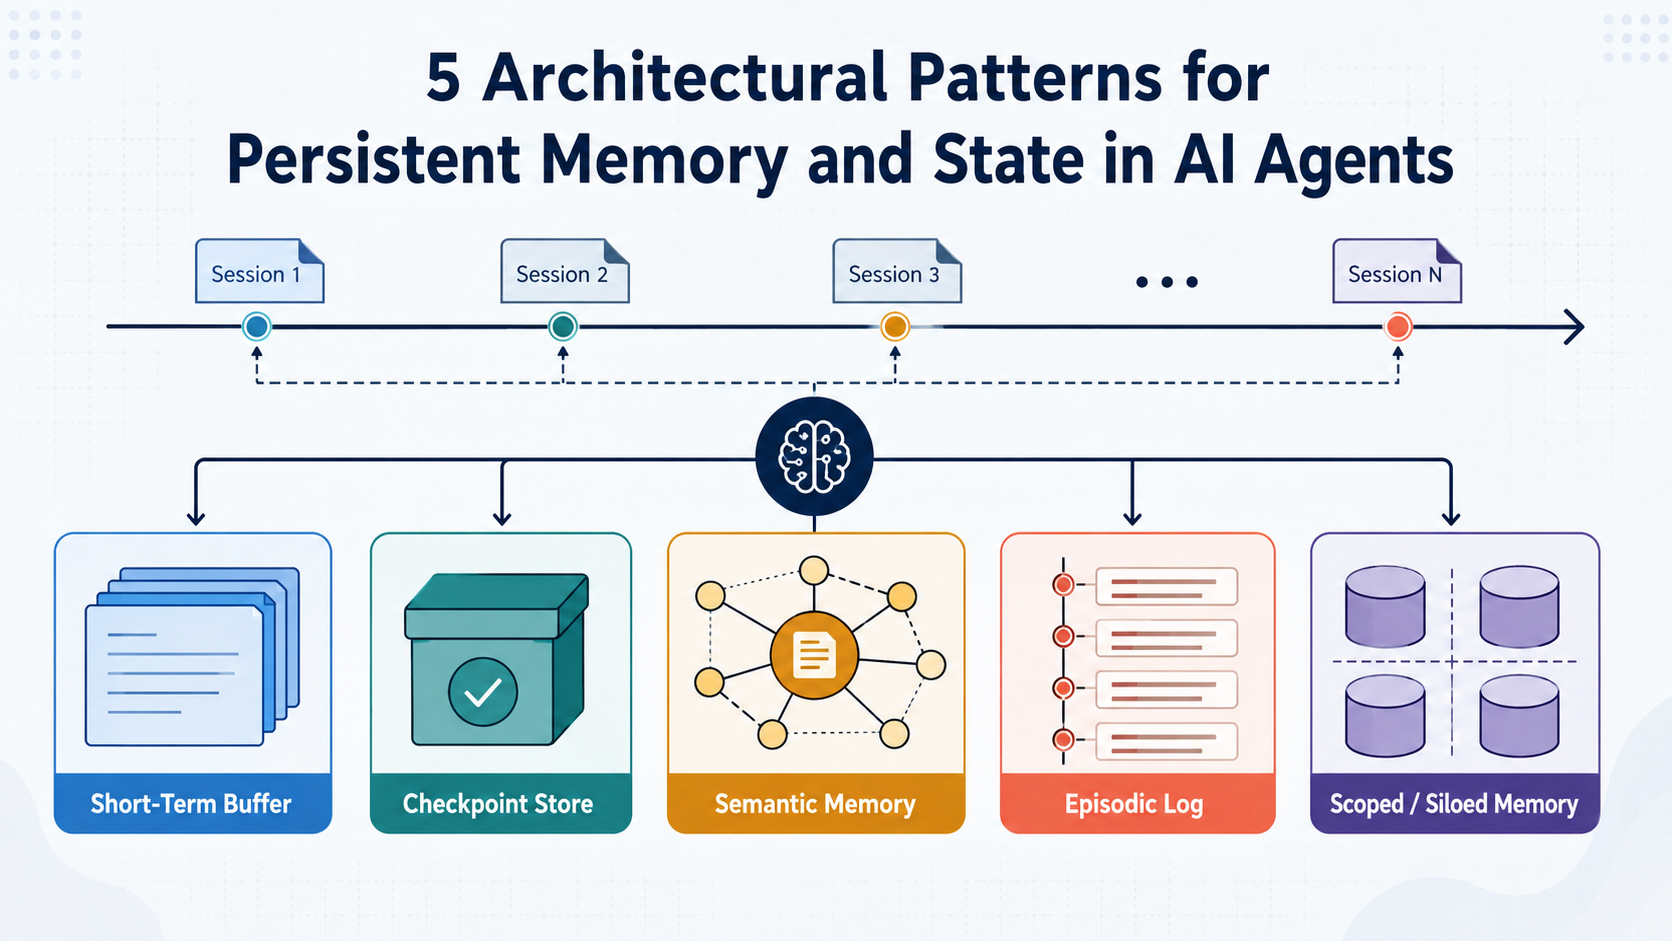
AI代理的持久记忆与状态设计有五种架构模式:工作缓冲处理短期执行,检查点实现容错暂停,语义记忆存储跨会话知识,事件日志记录历史反思,多范围隔离保障企业隐私。核心是区分状态快照与记忆机制,避免上下文窗口过载,并注意事实失效、安全隔离及存储增长管理。
AI内存并非概念,而是工程化的状态管理问题,涉及上下文窗口、会话摘要、向量库等层次,核心难点在于数据边界、删除、隔离和回滚。小团队应保守实现,优先可解释、可删除、可观测的小记忆,并监控检索命中率和成本,避免模型沿旧信息误导。
Visual Studio的新模型选择器简化了模型的选择和比较,用户可以固定常用模型,查看详细规格,监控上下文窗口的使用情况,以避免对话超出限制。这些更新旨在提升工作效率,让用户更专注于项目构建。
GPT-6预计在八月发布,参数规模可能达到10万亿,支持150万token的上下文窗口。然而,爆料人Lumina指出,超过25万到50万token后模型表现不佳,引发争议。AI行业面临效率与规模的挑战,单纯增加算力已不再有效,政治因素也影响发布进度。
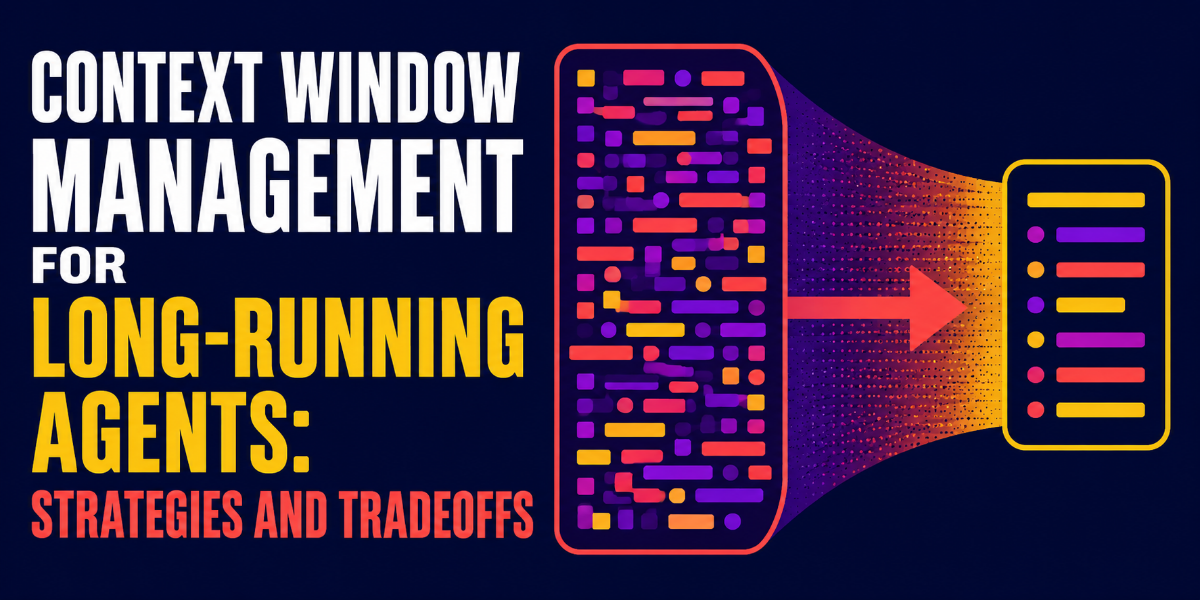
本文介绍了五种管理长期运行AI代理的上下文窗口策略,包括滑动窗口、递归摘要、结构化状态管理、基于RAG的短期上下文和动态上下文路由。每种策略都有其优缺点,如信息丢失、检索盲点和维护复杂性。成功的自主代理应用应关注智能架构,而非追求无限记忆。
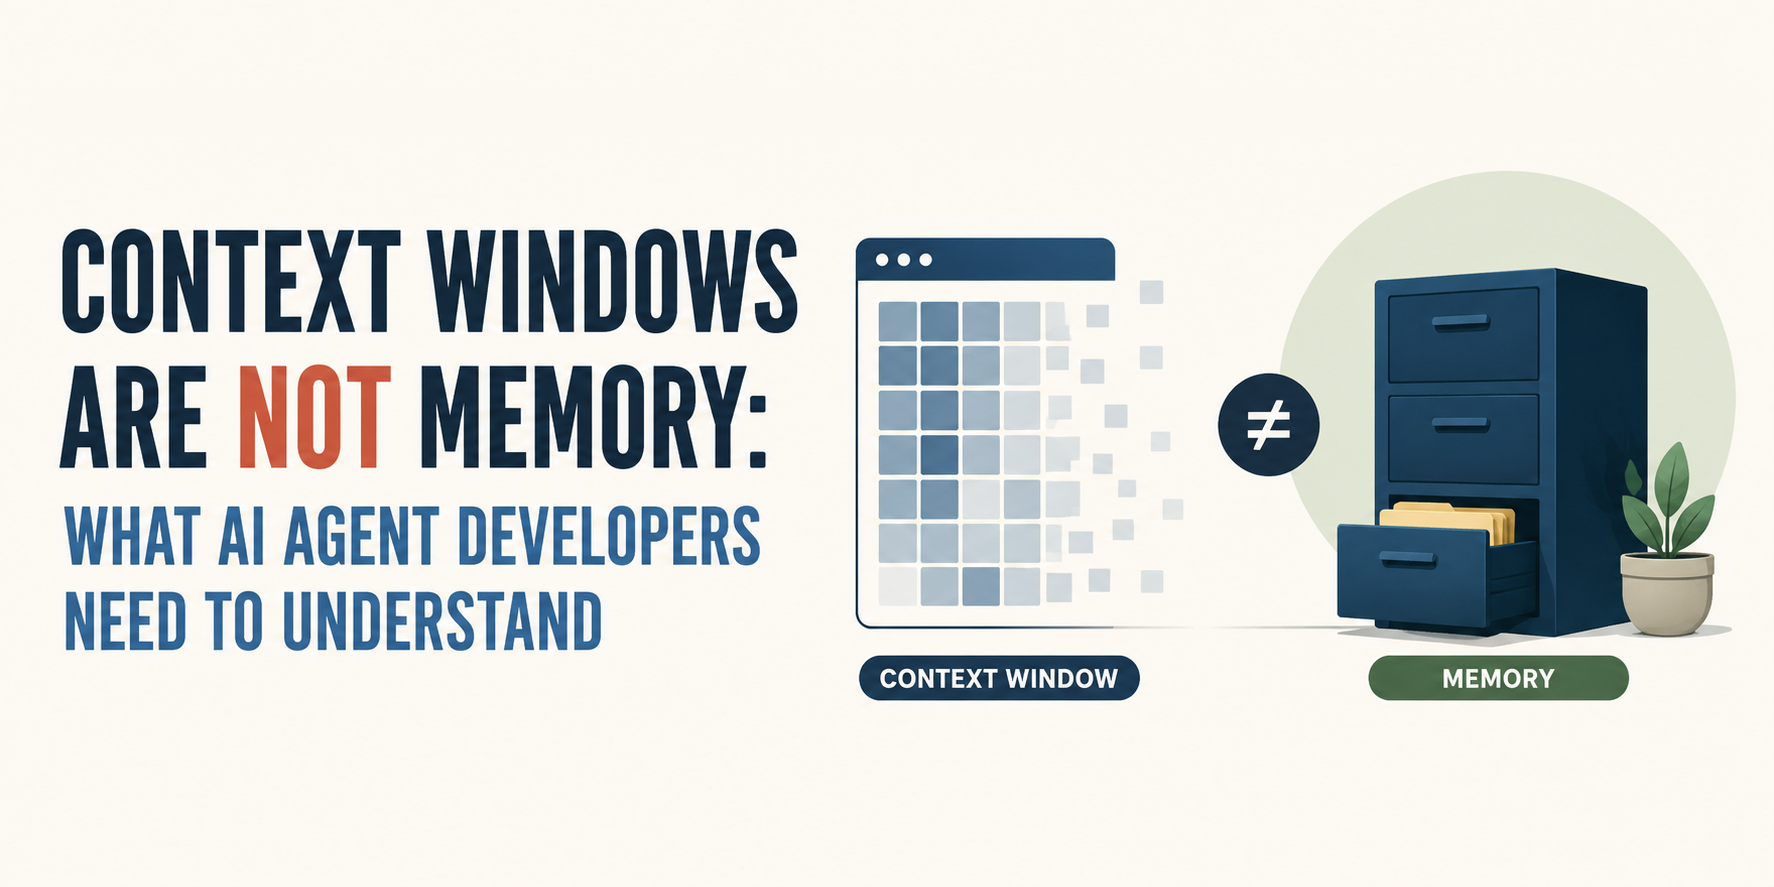
本文探讨了AI代理的上下文窗口与记忆的区别。上下文窗口类似于无状态的草稿纸,无法持久保存信息。通过检索增强生成、压缩和摘要等技术,代理可以更有效地管理信息。真正的记忆持久性需要代理作为数据库管理员,而非数据库本身。理解这些概念有助于优化AI代理的性能。
GLM-5.2是一个7530亿参数的开源大模型,具有百万token的上下文窗口和创新架构。其完整权重为1.51TB,普通硬件无法支持。最佳本地运行选择为256GB内存的Mac Studio,生成速度为每秒3-9个token。大多数用户应选择云GPU租用或API调用,以降低成本和技术门槛。
完成下面两步后,将自动完成登录并继续当前操作。