

大语言模型真的需要这么多层吗? [译]
内容提要
研究以OPT-66B为例,分析大语言模型各组件对上下文学习的作用:重要注意力头多集中于中间层,重要前馈网络多位于后层;移除70%的注意力头和20%的前馈网络后,模型在14项NLP任务上的性能几乎不受影响。仅少数注意力头对上下文学习至关重要,提示模型可能存在训练不足,扩大模型规模时需同步增加预训练数据。
延伸解读
层数冗余背后的训练不足信号
研究发现移除70%注意力头和20%前馈网络后,OPT-66B在14项NLP任务上性能几乎不变。这并非说明层数无用,而是暗示模型可能训练不充分:大量组件未被有效利用。作者指出,这印证了近期对“扩大模型规模时保持预训练数据量不变”的质疑,即模型规模与预训练数据量需同步增长才能达到最佳性能。
关键组件的位置分布规律
重要注意力头多集中于中间层,而重要前馈网络多位于后层。这种分布并非随机,提示不同层在上下文学习中承担不同角色。此外,跨任务和少样本次数,关键注意力头有相似性,说明存在一批通用且与任务无关的注意力头,它们在上下文学习中发挥核心作用。这为模型压缩和架构优化提供了可操作的切入点。
归纳头与任务特定头的重叠启示
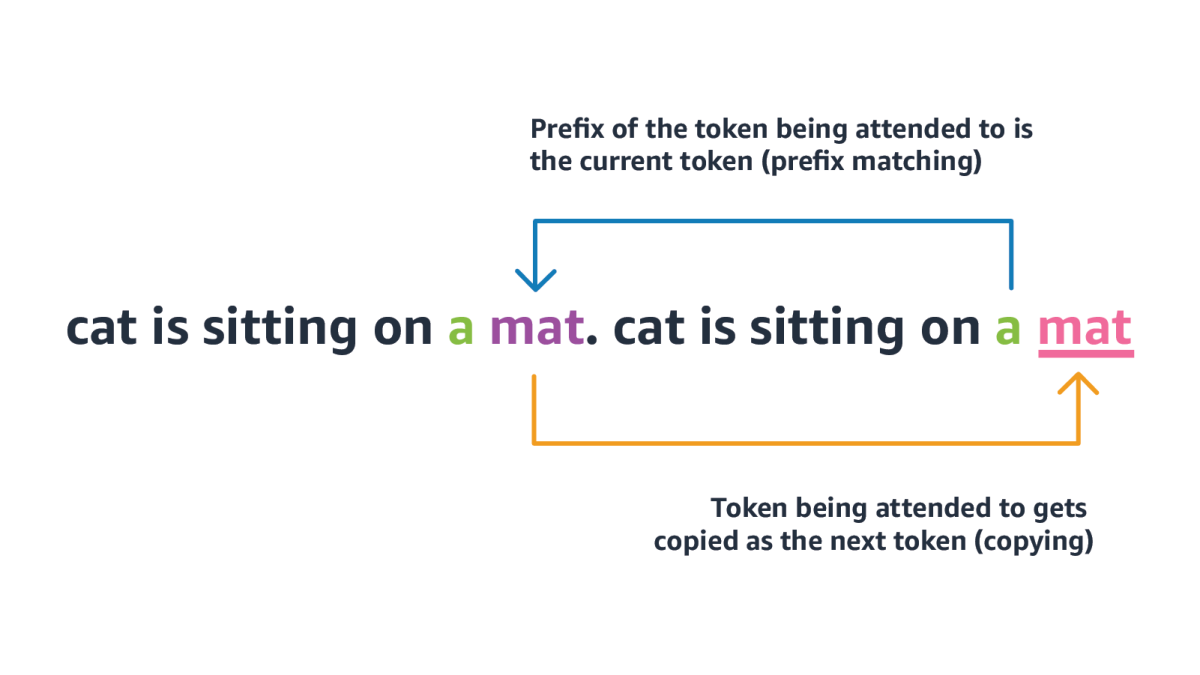
研究量化了前缀匹配和复制两种基础操作,发现仅少数头部能同时胜任,这些归纳头与任务重要头部分重叠。这表明归纳头不仅能执行复杂上下文学习行为(如隐性概念匹配),也说明它们并非唯一具备此类能力的头部。这一发现有助于理解上下文学习的机制,并为识别模型中的冗余组件提供了新视角。
Q&A
大语言模型真的需要所有层和组件吗?
不一定。研究表明,移除大语言模型中很大一部分组件(如70%的注意力头和20%的前馈网络)后,模型在多项NLP任务上的性能几乎不受影响,说明许多组件对上下文学习并非必需。
OPT-66B模型中哪些部分对上下文学习最重要?
重要的注意力头多集中在中间层,而重要的前馈网络(FFN)多位于后层。此外,存在一批通用的、与任务无关的注意力头对上下文学习至关重要。
移除大量注意力头和前馈网络对模型性能有什么影响?
移除高达70%的注意力头(约15.7B参数)和20%的前馈网络(约8.5B参数)后,模型在14项NLP任务上的零样本/少样本学习能力几乎未受影响。
为什么说大语言模型可能存在训练不足的问题?
因为只有少数注意力头和前馈网络对上下文学习至关重要,大部分组件可以被移除而不影响性能,这表明模型在预训练时可能没有充分利用其容量,即训练不充分。
扩大模型规模时需要注意什么?
研究暗示,在扩大模型规模时,需要同步增加预训练数据量,否则模型可能训练不足,无法发挥其全部潜力。
什么是归纳头部(induction heads)?它们在模型中起什么作用?
归纳头部是负责前缀匹配和复制两种基础操作的注意力头,由Anthropic发现。在OPT-66B中,只有少数头部能同时做好这两种操作,它们与任务重要的头部有重叠,表明其参与上下文学习。
