
从兆瓦到Token:NVIDIA如何最大化AI工厂产能
内容提要
NVIDIA推出DSX平台,通过协同设计计算、网络、供电与冷却,提升AI工厂每瓦token产出。Lambda验证DSX MaxLPS可在相同功耗下提升24%吞吐量。Emerald AI的Conductor平台已响应电网需求信号超200次,实现自动降载。DSX Flex将推广该能力,首站为弗吉尼亚州96兆瓦AI工厂。
延伸解读
从固定功耗到动态分配:MaxLPS 的实测价值
Lambda 在五机架、19 节点的 HGX B200 集群上验证了 DSX MaxLPS:在相同功耗预算下,让 19 个节点运行,而非 16 个节点满功耗运行,集群 token 吞吐量提升 24%,从约每秒 400 万 token 增至 500 万,每瓦性能提升 23%。这证明动态分配 GPU 与机架级功耗余量,能回收静态配置下被闲置的容量,对同时运行训练和推理的 AI 工厂尤其有意义。
电网互动:AI 工厂成为可调度资源
Emerald AI 的 Conductor 平台在 NVIDIA Eos AI 工厂参与 Silicon Valley Power 的柔性负载互联计划,已响应超过 200 次需求信号,每次都在一分钟内自动降载,将功耗从 4 兆瓦降至 3 兆瓦,且不中断高优先级推理任务。这首次在商业规模上证明,AI 工厂可以像可调度资源一样配合电网,而无需等待新建输电线路。
DSX Flex 的下一步:从验证到商业部署
DSX Flex 将把上述电网互动能力推广到更多场景。首个专用商业部署将是位于弗吉尼亚州马纳萨斯的 96 兆瓦 Vera Rubin AI 工厂,该设施属于 NVIDIA 的 AI 工厂研究中心,并建立在横跨两大洲的五次先前演示基础上。这意味着 AI 工厂与电网协同正从概念验证走向标准化产品,为未来更大规模部署铺路。
整体设计:突破单点优化的物理极限
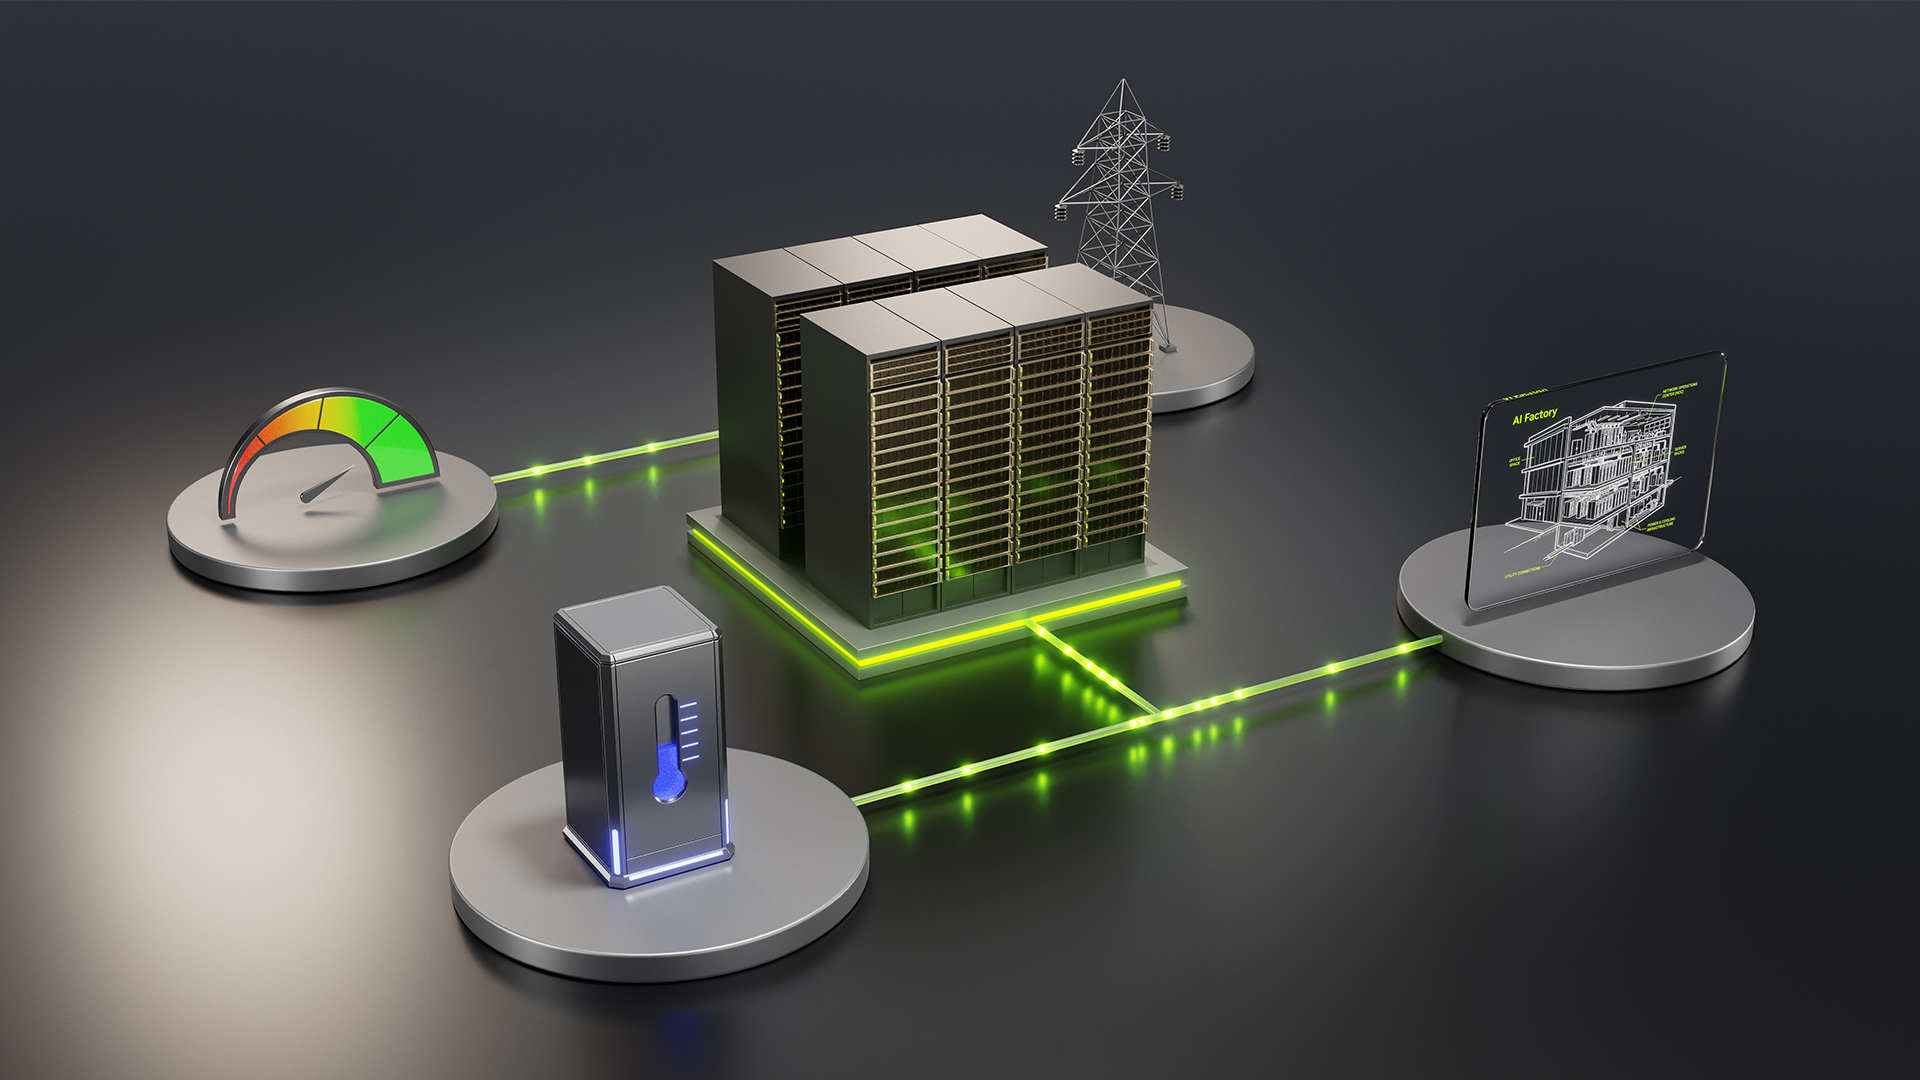
文章强调,AI 工厂的效率瓶颈无法靠单一组件解决:更快的 GPU 仍要等网络,供电配置不当会浪费电力,冷却开销也会挤占 GPU 用电——例如 GB200 NVL72 机架采用直接液冷时,约 120 千瓦的热量必须先被带走。因此 NVIDIA DSX 提供从模拟、运营软件到参考设计的全套工具,目标是在每兆瓦功耗下产出更多 token,而非只优化局部。
Q&A
NVIDIA DSX 是什么?它主要解决什么问题?
NVIDIA DSX 是一个通过协同设计计算、网络、供电、冷却和运营来帮助 AI 工厂从每瓦电力中产出更多 token 的平台。它旨在解决 AI 工厂的电力约束问题,让基础设施构建者能在现有电力预算下提升产能,并构建电网可协同的工厂。
DSX MaxLPS 在 Lambda 的验证中取得了什么效果?
在 Lambda 的五机架、19 节点集群上,DSX MaxLPS 在相同电力预算下实现了集群级 token 吞吐量提升 24%(从约每秒 400 万 token 增至 500 万),每瓦性能提升 23%。
Emerald AI 的 Conductor 平台在电网需求响应中表现如何?
Conductor 平台已响应电网需求信号超过 200 次,每次都能在不到一分钟内自动调整功耗,降低电力需求而不中断关键 AI 工作负载。例如在硅谷电力公司的一次信号中,功耗从 4 兆瓦降至 3 兆瓦,高优先级任务持续运行。
DSX Flex 是什么?它的首个商业部署在哪里?
DSX Flex 是 NVIDIA DSX 中用于推广电网灵活性能力的部分,旨在将 AI 工厂作为可调度资源。其首个专用商业部署将是位于弗吉尼亚州马纳萨斯的 96 兆瓦 Vera Rubin AI 工厂,该工厂属于 NVIDIA 的 AI 工厂研究中心。
NVIDIA 的 800V 直流电源架构有什么作用?
800V 直流架构旨在降低转换复杂度、提高电力传输效率,并支持更密集的加速计算机架。NVIDIA DSX 正在将其纳入参考设计。
为什么优化整个 AI 工厂比优化单个组件更重要?
因为单个组件无法独立优化 AI 工厂:更快的 GPU 仍要等待网络,不良配置会导致电力搁浅,冷却开销会分流电力。只有优化整个工厂——从设计、模拟到运营——才能可靠地提升每兆瓦 token 产出。
