


Strata 现已支持 macOS,还能运行更轻量的 Qwen3.6-35B-A3B 大模型了
内容提要
Strata本地AI推理工具更新,新增实验性支持Apple Silicon Mac,并引入更轻量的Qwen3.6-35B-A3B模型以降低硬件门槛。该模型约35B参数、激活3B,支持MTP加速,生成速度提升约94%。运行需至少12GB显存、32GB内存,模型文件22GB起。Mac版需macOS 15以上,暂不支持该新模型。
延伸解读
硬件门槛与模型选择
Strata 新增的 Qwen3.6-35B-A3B 模型显著降低了硬件需求,官方建议至少 12GB 显存和 32GB 系统内存。对于仅有 12GB 显存的用户,推荐使用低量化版本(如 UD-Q4_K_XL),其模型文件为 22.4GB,内存需求 32GB。但需注意,该模型目前仅支持 NVIDIA 和 AMD 显卡,Intel Arc 和 Mac 用户无法使用。
性能提升与适用场景
Qwen3.6-35B-A3B 支持 MTP 推测解码,在 AMD Radeon AI PRO R9700 测试中,开启 MTP 2 后生成速度从 83 tokens/s 提升至 161 tokens/s,增幅约 94%。虽然其复杂推理和编程能力相对 Flash-Next 较弱,但足以应对日常对话、文字处理和一般编程任务,且系统资源占用更低。
Mac 支持现状与限制
Strata v0.1.44 开始实验性支持 Apple Silicon Mac(M1~M5),需 macOS 15 及以上,并通过源码编译安装。目前仅支持单个并发请求,官方验证最高 32K 上下文,且 Qwen3.6-35B-A3B 暂未适配。测试显示,Mac mini M4(32GB)运行 Flash-Next Q2_0 生成速度为 8~14 tokens/s,而 M5 Max(128GB)可达 95~103 tokens/s。
存储与内存的实际需求
除了显存和内存,模型文件本身也占用大量存储空间。Qwen3.6-35B-A3B 的 UD-Q4_K_XL 版本为 22.4GB,而 Flash-Next 的 UD-IQ4_XS 版本高达 93.7GB。用户实测运行 IQ2_XS 量化版本约占用 100GB SSD 空间。此外,运行成功后系统内存可能被耗尽,需提前规划硬件配置。
Q&A
Strata 现在支持哪些显卡?
Strata 支持 NVIDIA RTX 20/30/40/50 系列、AMD RX 6000/7000/9000 系列的部分型号,并为 Intel Arc 和 Apple Silicon(M1~M5)提供实验性支持。官方建议使用至少 12GB 显存的 NVIDIA 或 AMD 显卡。
运行 Strata 需要多大内存?
至少需要 32GB 系统内存。官方推荐 12GB 显存 + 32GB 内存。对于 12GB 显存用户,推荐尝试 35B 模型的低量化版本。
Qwen3.6-35B-A3B 和 Flash-Next 模型有什么区别?
Qwen3.6-35B-A3B 总参数量约 35B,激活 3B,资源占用较低,适合日常对话、文字处理和编程;Flash-Next 总参数量 125B,激活 6B,复杂推理和编程能力更强,但资源占用更高。两者均支持 MTP 推测解码。
MTP 加速能提升多少生成速度?
在官方使用 AMD Radeon AI PRO R9700 的测试中,普通推理速度为 83 tokens/s,开启 MTP 2 后达到 161 tokens/s,生成速度提升约 94%。
Strata 的 Mac 版有什么限制?
Mac 版从 v0.1.44 开始实验性支持 Apple Silicon M1~M5,要求 macOS 15 或更新版本。目前只支持单个并发请求,官方仅验证了最高 32K 上下文,且 Qwen3.6-35B-A3B 模型暂未适配。
如何安装和启动 Strata?
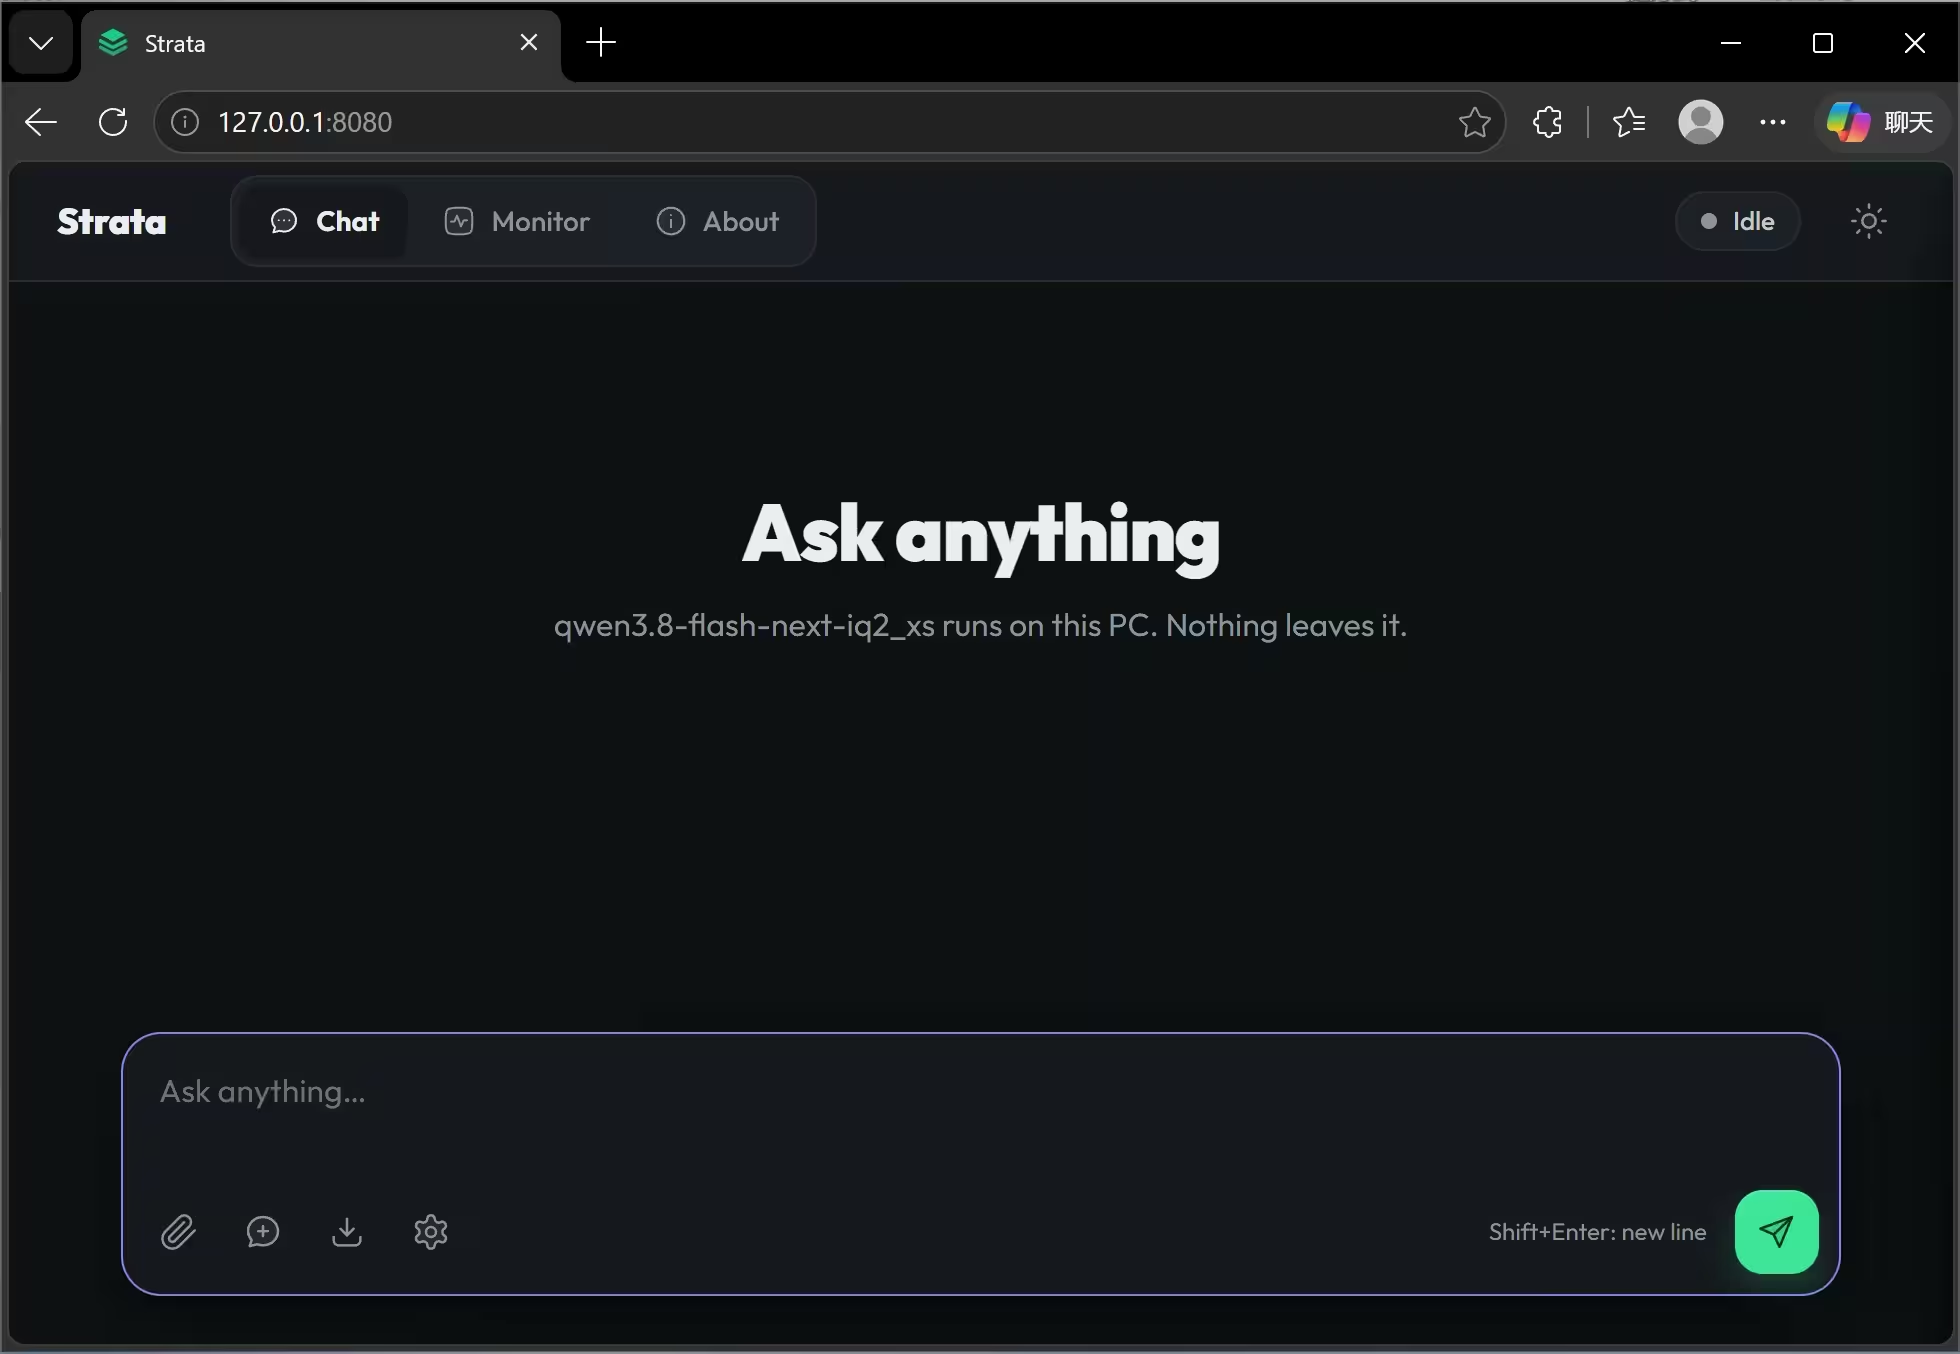
可以按照 GitHub 仓库中的 docs/AI_SETUP.md 让 AI 协助设置,或直接下载源码:Windows 双击 START-HERE.bat,Linux/macOS 运行 ./setup.sh,然后根据页面提示操作,成功后会自动弹出浏览器进行对话。
