

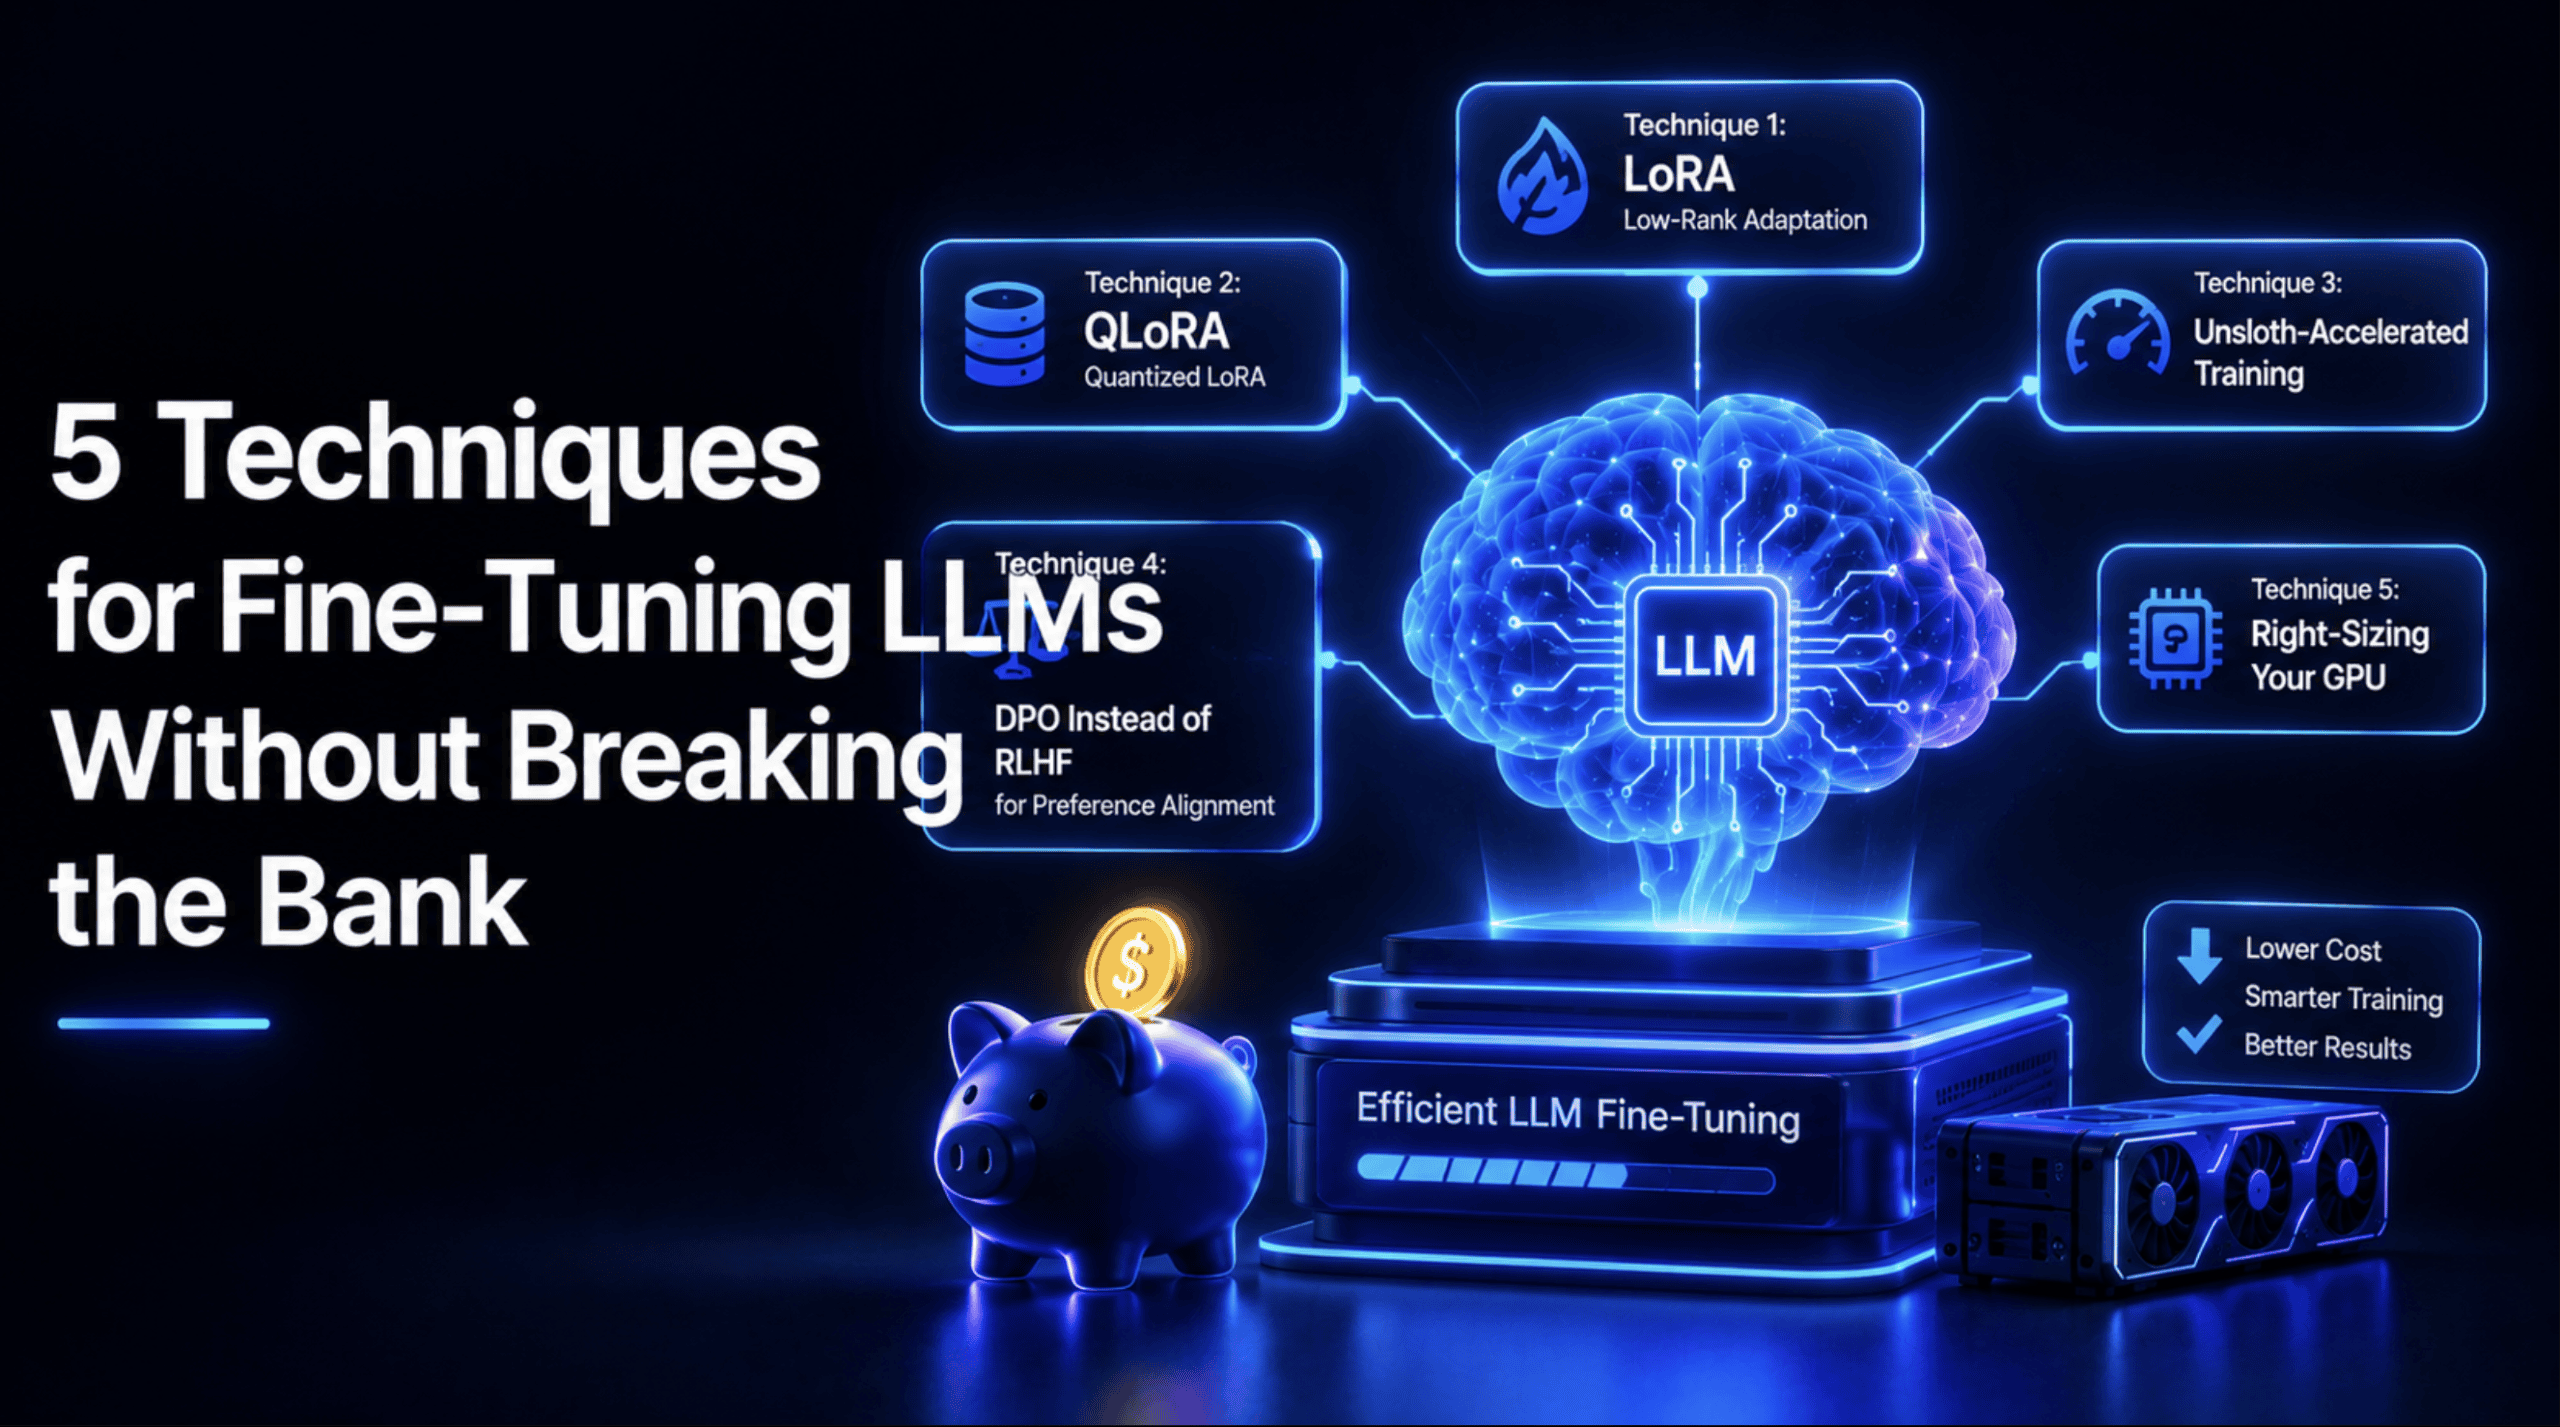

五种低成本微调大模型的技术
内容提要
文章指出,微调大模型并非昂贵的研究级任务:借助LoRA、QLoRA、Unsloth加速、DPO偏好对齐和合理选择GPU这五种可叠加技术,8B模型微调的GPU成本可低至几美元。真正的开销在于数据构建、迭代与评估。多数“需要微调”的需求其实可用检索解决,应先估算再租用硬件。
延伸解读
微调的真实成本不在GPU,而在数据与迭代
文章指出,8B模型微调的GPU成本可低至几美元,但完整项目仍常落在5000至15000美元区间。差距主要来自数据集构建、多轮迭代和评估,且每次基座模型更新后这些工作都会重复。因此规划预算时,应把数据与评估视为持续投入,而非一次性开销。
先判断是否真的需要微调
文章引用实践指南称,约80%以“需要微调”提出的需求,其实可通过更好的检索解决。微调真正适用的场景包括:大规模调用下行为一致性、严格输出格式、以及窄领域词汇或品牌语气。若问题只是提示词或检索不足,微调会是昂贵且不必要的补丁。
五种技术可叠加,而非互斥选择
LoRA减少可训练参数,QLoRA进一步压缩显存,Unsloth加速训练以缩短租用时间,DPO替代RLHF做偏好对齐,合理选择GPU则直接控制硬件成本。文章强调,实际省钱来自组合使用:例如QLoRA加Unsloth,再按估算脚本选择RTX 4090而非H100,可避免为不需要的算力付费。
规模与架构决定技术适用边界
文章明确,所述技术主要适用于约2B至13B的稠密模型,可在单GPU上运行。超过约70B参数,尤其是稀疏混合专家架构,即使QLoRA也需要多GPU节点才能容纳量化权重。因此,在套用低成本方案前,应先确认模型规模和架构是否落在适用范围内。
Q&A
微调一个8B大模型到底要花多少钱?
根据文章,使用LoRA或QLoRA微调7-8B模型的GPU成本约为3到10美元(在租用的A100上训练2-4小时),在租用的RTX 4090上可低于3美元。但完整项目的实际花费通常在5000到15000美元之间,因为主要开销来自数据集创建、多次迭代和评估,而非GPU时间。
LoRA和QLoRA有什么区别?应该选哪个?
LoRA通过冻结基础模型并注入小型可训练低秩矩阵来减少训练参数量,但仍需足够显存以16位精度加载完整模型。QLoRA在此基础上将冻结的基础模型量化为4位NormalFloat,大幅降低显存需求,使8B模型能在单张消费级GPU(如8-24GB)上训练。如果显存有限,QLoRA是默认起点;如果显存充足且追求更快训练速度,可选LoRA。
Unsloth是如何帮助降低微调成本的?
Unsloth通过用手工优化的内核替换较慢的默认GPU操作,减少训练时间和内存使用,从而直接减少租用GPU的计费小时数。它提供预量化的模型权重和自带的内存节省检查点技术,可与LoRA或QLoRA叠加使用,进一步降低成本。
DPO和RLHF在偏好对齐上有什么不同?为什么DPO更便宜?
RLHF需要先训练一个独立的奖励模型,再通过强化学习(如PPO)进行对齐,涉及额外的基础设施和训练不稳定性。DPO则完全跳过奖励模型,直接使用成对的偏好数据(一个选中回复和一个拒绝回复),通过简单的分类式损失训练模型,无需第二个模型参与,因此更便宜、更稳定。
如何选择适合微调的GPU?租H100有必要吗?
文章建议根据任务规模选择GPU:对于7-8B模型的LoRA/QLoRA,RTX 4090(约0.31美元/小时)通常足够;A100 80GB(约1.19美元/小时)适合更大批量或13B模型;H100(约1.99美元/小时)仅真正需要用于30B以上密集模型或多GPU工作。租用前应先用估算脚本计算训练时间和成本,避免为小任务租用高端硬件造成浪费。
所有“需要微调”的需求都真的需要微调吗?
不一定。文章指出,大约80%以“我们需要微调模型”形式提出的需求,实际上可以通过更好的检索(RAG)解决。微调仅在三种情况下是真正必要的:需要模型在大量调用中保持行为一致性、需要精确的输出格式或模式、以及需要狭窄的领域词汇或特定品牌语气。否则,微调可能是修补提示或检索问题的昂贵方式。
