

ChatGPT 正在偷偷给你画像,用这段提示词让它交出来
内容提要
一项研究依据GDPR获取80名用户数据,发现ChatGPT记忆中仅4.1%由用户明确要求,95.9%为系统自行写入;28%含个人数据,52%含心理推断(如欲望与恐惧),多数记忆忠实于对话。研究者复刻记忆提取过程并开发预警工具,帮助用户审计记忆、降低隐私风险。
延伸解读
记忆主导权:用户指令仅占4.1%
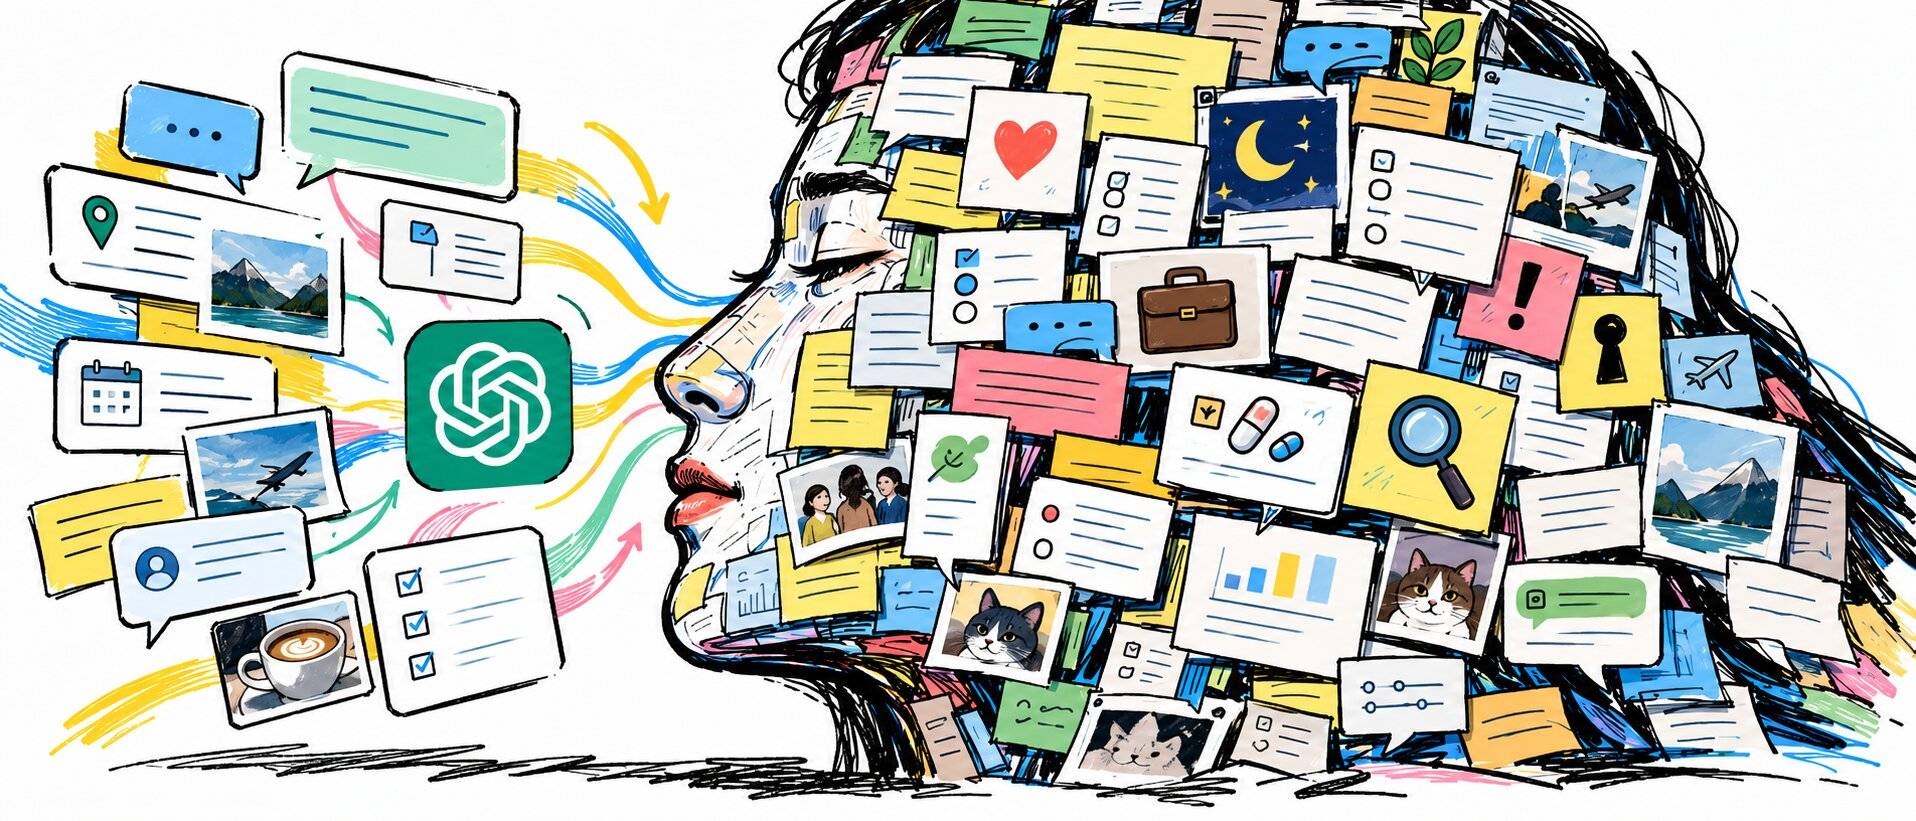
研究显示,ChatGPT存储的2050条记忆中,仅4.1%由用户明确要求写入,95.9%是系统自行判断“对未来对话有用”后单方面记录。这并不违反OpenAI政策,因为文档允许保存“有用”信息,但用户对记忆形成只能通过“说什么”间接影响,无法直接控制“记什么”。这种落差意味着用户对自身画像的掌控远低于预期,需要主动审计记忆内容。
记忆内容:不止事实,还有心理推断
28%的记忆包含GDPR定义的个人数据,7%含特殊类别数据(健康信息占61%);52%的记忆包含对用户心理状态的推断,其中欲望和意图合计近九成。例如“对失败有恐惧”这类判断已超出事实记录,属于对“你是什么样的人”的刻画。虽然84%的记忆有对话文本依据,但心理推断的准确性难以验证,可能持续影响后续对话。
隐私保护与对话质量可兼得
研究者复刻记忆提取过程并开发Attribution Shield工具,在用户提问前预判可能触发的敏感记忆,并给出“去身份化”改写建议。评测显示,94%~100%的改写查询显著降低个人归因,同时87%~91%保持回答实用度不变。这表明保护“算法肖像权”在技术上可行,用户可通过改写提问方式减少敏感信息被记录,而不牺牲回答质量。
主动审计:从查看记忆到使用提示词
文章建议用户先打开ChatGPT设置中的“个性化”查看已存储记忆,检查过时、错误或不愿保留的条目。同时提供一段审计提示词,要求AI披露已存储记忆、心理画像、隐性推断、沟通模式分析、潜在误读及信息来源,并区分明确提供、记忆检索、互动推断和当前对话生成的信息。这有助于用户了解AI对自己的认知边界,但需注意AI可能无法访问隐藏数据,回答应基于实际可访问的证据。
Q&A
ChatGPT 的记忆里有多少是我主动要求它记住的?
根据一项基于 GDPR 获取 80 名用户数据的研究,在 2050 条记忆条目中,只有 4.1%(84 条)是用户通过“记住”“保存”等触发词明确要求写入的;其余 95.9% 都是 ChatGPT 自行判断“对未来对话有用”后单方面写入的。
ChatGPT 的记忆会记录我的健康信息或心理状态吗?
会。研究显示,28% 的记忆包含 GDPR 定义的个人数据(其中姓名占 41%),7% 包含特殊类别数据(其中健康信息占 61%);此外,52% 的记忆包含对用户心理状态的推断,如欲望(73%)、意图(16%)等,甚至包括“对失败有恐惧”这类人格判断。
ChatGPT 记住的内容和我实际说的对得上吗?
大部分对得上。研究者用三种方法验证溯源,发现 84% 的记忆能在用户完整对话历史中找到直接文本依据,77% 被评为“直接陈述”或“转述总结”,明确“无依据或矛盾”的仅占 4%。但研究也指出,一幅不忠实的画像比没有画像更危险,因为 AI 可能基于错误的你持续影响后续对话。
有没有工具能提前预警 ChatGPT 会记录我的敏感信息?
有。研究者用三个开源模型复刻了 ChatGPT 的记忆提取过程(语义相似度约 60%~70%),并在此基础上搭建了 Attribution Shield(归因护盾)。它能在你按下回车前预判问题会触发什么敏感记忆,给出预警,并提供“去身份化”的改写版本。评测显示,94%~100% 的改写显著降低了个人归因,同时 87%~91% 的改写保持了回答的实用度。
我怎么查看和清理 ChatGPT 已经记住的关于我的信息?
可以打开 ChatGPT 的设置,在“个性化”里查看记忆,检查哪些信息已过时、被理解错或你不希望保留,并进行修改或删除。文章还提供了一段审计提示词,要求 AI 分类披露已存储记忆、心理画像、隐性推断、沟通模式分析、潜在误读、信息来源、置信度评估等,并明确区分持久记忆与临时推断,帮助你全面审计 AI 对你的用户模型。
AI 记忆和传统平台的行为画像有什么不同?
传统平台刻画的是“行为轮廓”,即我们做了什么;而 ChatGPT 的记忆刻画的是“特征性适应”,即我们是谁。研究借用心理理论框架发现,52% 的记忆包含对用户心理状态的推断,且偏好欲望(73%)和意图(16%)这类稳定人格特征,而非情绪、感知等瞬时状态,已经跳出了事实记录,变成对“你是什么样的人”的判断。
