


你随手安装的那些 skill,会消耗你多少 token
内容提要
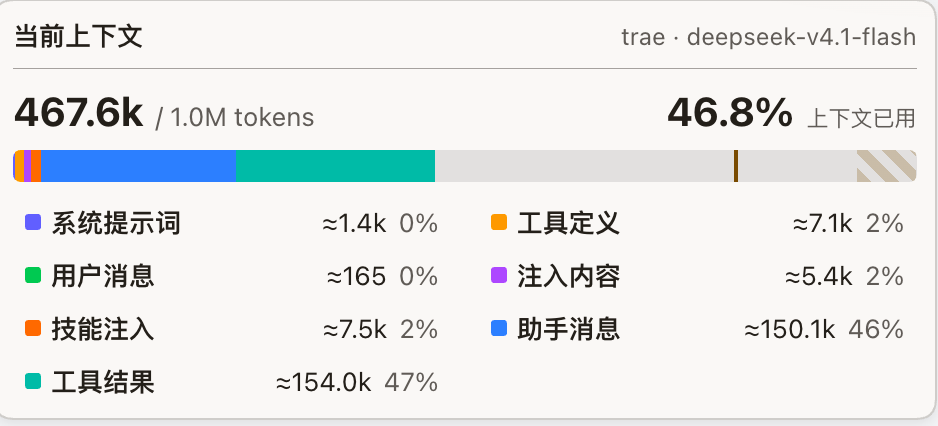
实测发现,skill的token消耗取决于安装数量而非使用数量:即使只安装不到20个、仅使用1个,技能注入仍累计消耗420万token,占总量的2.3%,主要来自每轮携带的skill目录清单。安装越多,固定开销越大,选错或漏选的概率也越高。为此作者推出flint工具,核心理念是“归集一次,按需投放”:skill本体统一存放于本地仓库,通过预设只向指定agent部署所需skill,使仓库可无限扩展,而目录开销只按实际投放量计算。
延伸解读
目录清单才是隐藏成本
文章实测显示,skill 的 token 消耗主要来自每轮携带的目录清单,而非实际加载的技能正文。即使只使用 1 个 skill,安装的每个 skill 都会在目录中占一行,按轮次累计。这意味着安装数量直接决定固定开销,与使用频率无关。读者需注意:减少安装量比控制使用次数更能有效降低 token 消耗。
装得多还会增加选错风险
文章指出,候选清单越长,模型挑错 skill 或漏掉正确 skill 的概率越高。这不仅是 token 账单问题,更影响任务执行的准确性。skill 本为节省 token 而设计,但无限制安装反而让每轮都背负目录税,并可能引入选择错误。因此,管理 skill 时应优先考虑精简,而非贪多。
按需投放的解耦思路
作者提出的 flint 工具核心是“归集一次,按需投放”:skill 本体统一存于本地仓库,通过预设只向指定 agent 部署所需 skill。这样仓库可无限扩展,而目录开销只按实际投放量计算。读者可借鉴这一思路,将 skill 管理从“安装”转向“投放”,让每个 agent 的上下文只保留真正干活的技能。
Q&A
为什么只使用一个 skill 也会消耗大量 token?
因为 token 消耗主要来自每轮对话中携带的 skill 目录清单,而不是实际使用的 skill 数量。即使只加载一个 skill,agent 仍需在上下文中保留所有已安装 skill 的目录信息,每轮都会产生固定开销,累积起来就非常可观。
安装大量 skill 除了浪费 token 还有什么坏处?
候选清单越长,模型挑错 skill 或漏掉正确 skill 的概率越高。就像在一箱别人的工具里翻自己的扳手,工具越多,翻错的那次越致命。skill 本来是来省 token 的,装多了反而变成每轮必缴的税。
flint 工具是如何解决 skill 目录 token 开销问题的?
flint 的核心理念是“归集一次,按需投放”。所有 skill 本体统一存放在本地仓库,通过预设(Preset)只向指定 agent 部署所需 skill。这样 agent 上下文中的目录清单长度由你决定,仓库可以无限扩展,而目录开销只按实际投放量计算。
flint 的预设(Preset)功能具体怎么用?
预设是一个 skill 包,成员可以是显式指定的几个 skill,也可以是“带某标签的全部”。在 agent 详情页选择一个预设,点击“Apply preset”,只有该预设里的 skill 会被部署进该 agent 的 skill 目录。没链接预设的 agent 一个 skill 都看不到,目录注入为零。
flint 除了按需投放还有哪些功能?
flint 还提供:Projects(给项目登记路径加标签,标签即部署策略,技能包可随项目走)、Health(六维体检,一键修复问题)、npx 安装托管(在受管目录运行安装命令,带 git 快照可回滚)、标签与元数据(优先写入 SKILL.md 的 frontmatter)。安装只需一行命令,本地运行,无云无账号。
如何安装和启动 flint?
安装只需一行命令:npx flint-skills-hub,然后打开 http://localhost:8787 即可使用。没有云、没有账号、没有遥测,skill 是你磁盘上的文件,flint 卸了它们也在。界面中英可切换,日志可下载。
