


K8s 1.37 新特性:原生 Gang Scheduling 与 HPA Scale to Zero
内容提要
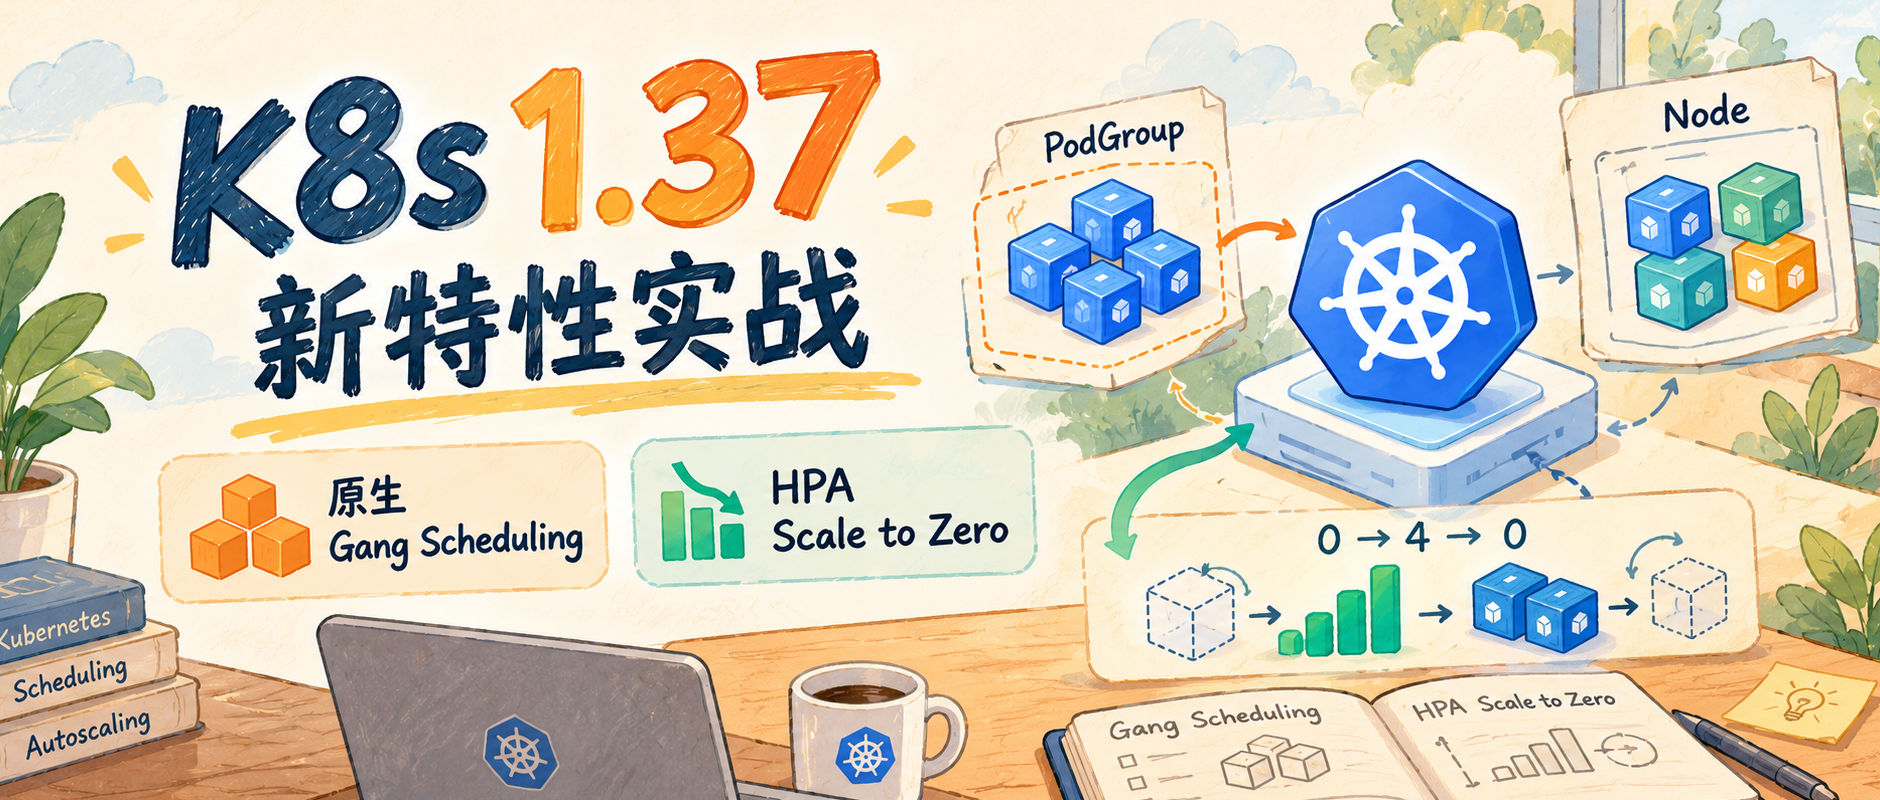
Kubernetes 1.37 将原生 Gang Scheduling 与 HPA Scale to Zero 提升至 Beta。Gang Scheduling 引入 Workload 和 PodGroup,按组判断资源,资源不足时整组等待;简单场景可用原生能力,多租户公平调度仍需 Volcano。HPA Scale to Zero 默认启用,依赖 Object/External 指标唤醒零副本,适合按队列长度伸缩消费者;多事件源接入和 HTTP 冷启动转发仍分别适合 KEDA 与 Knative。
延伸解读
原生 Gang 调度与 Volcano 的边界
文章明确区分了两者:原生 Gang Scheduling 只解决“一组 Pod 如何一起调度”,通过 Workload 和 PodGroup 按组判断资源,资源不足时整组等待。而 Volcano 还负责批处理作业管理、多租户 GPU 队列、资源借用与公平调度。因此,若只是简单组调度,可优先用原生能力;若需要多团队共享集群的公平与效率,Volcano 仍有价值。
零副本唤醒依赖独立指标
HPA 缩到零后,Pod 的 CPU、内存指标随之消失,无法据此发现新任务。文章指出,minReplicas: 0 必须至少配置一个 Object 或 External 指标,通常用队列长度这类独立存在的指标来唤醒。只有 CPU、内存指标的配置会被 API Server 拒绝。若指标链路不可用,HPA 可能报 FailedGetExternalMetric,已归零的消费者也无法自动唤醒。
原生 HPA 与 KEDA、Knative 的分工
文章对比了三者:原生 HPA 根据指标调整副本数,零副本时持续读取 Object、External 指标恢复副本,但指标适配和请求缓冲需另外提供;KEDA 擅长对接多种事件源,由 Operator 处理 0↔1;Knative Serving 提供 HTTP 流量接入,由 Activator 暂存请求并配合唤醒。若已有可靠 External Metrics 链路、只需按队列长度伸缩消费者,可直接用原生 HPA。
Demo 揭示的调度语义与伸缩限制
实验显示,普通调度下资源不足时部分 Pod 先运行;Gang 调度在无法满足 minCount 时整组 Pending,释放资源后才一起调度。但文章提醒,Gang 只保证初始调度门槛,容器启动仍有先后,成员后续被删除或驱逐也不保证运行数量始终满足 minCount。HPA 示例用 LPOP 模拟消费,任务出队后若 Pod 退出可能丢失,实际业务需消息确认、失败重投和优雅退出。
Q&A
Kubernetes 1.37 中 Gang Scheduling 和 HPA Scale to Zero 处于什么阶段?
两者在 Kubernetes 1.37 中均进入 Beta 阶段。Gang Scheduling 需要手动开启 GenericWorkload 特性门控和 scheduling.k8s.io/v1beta1 API;HPA Scale to Zero 则默认启用。
原生 Gang Scheduling 引入了哪些核心对象,它们之间是什么关系?
引入了 Workload 和 PodGroup 两个核心对象。Workload 保存调度策略模板(如 gang.minCount),本身不创建 Pod;PodGroup 表示实际参与调度的一组 Pod,通过 workloadRef 引用模板,并保存自己的调度策略和状态。Pod 通过 schedulingGroup.podGroupName 加入 PodGroup。PodGroup 也可以独立使用,无需先创建 Workload。
K8s 原生支持 Gang Scheduling 后,还有必要用 Volcano 吗?
取决于需求。如果只需要简单的 Gang Scheduling(一组 Pod 一起调度),可以优先使用 K8s 原生能力,无需引入 Volcano。但如果需要多租户 GPU 队列、资源借用与回收、多组作业间的公平调度等批处理作业管理能力,Volcano 仍然有明显价值。原生 Gang Scheduling 解决的是“一组 Pod 如何一起调度”,Volcano 解决的是“多组作业如何公平、高效地共享集群资源”。
HPA 缩到零副本后,靠什么指标唤醒?配置上有什么限制?
零副本后 Pod 指标消失,因此必须依赖独立存在的 Object 或 External 指标(例如队列长度)来唤醒。HPA 持续读取该指标,当指标显示有新任务时恢复副本。配置 minReplicas: 0 时,至少需要一个 Object 或 External 指标,仅配置 CPU、内存指标的 HPA 会被 API Server 拒绝。
原生 HPA Scale to Zero 与 KEDA、Knative 在零副本伸缩上如何分工?
原生 HPA 根据 Object/External 指标调整副本数,适合已有可靠 External Metrics 链路、只需按队列长度伸缩消费者的场景。KEDA 擅长对接多种事件源(消息队列、数据库等),提供 Scaler、认证和触发器配置,由 Operator 处理 0↔1。Knative Serving 提供面向 HTTP 服务的自动伸缩和流量接入,通过 Activator 暂存请求并配合 Autoscaler 唤醒服务,适合需要 HTTP 请求触发唤醒和冷启动转发的场景。
在 Demo 中,普通调度和 Gang 调度在资源不足时的表现有什么不同?
普通调度会逐个处理 Pod,能放下的先运行,不会等待其他成员。例如两个各需 3 CPU 的 Pod,在剩余资源只够一个时,一个 Running,另一个 Pending。Gang 调度则按组判断:当 PodGroup 的 minCount 为 2 而资源只能满足一个时,两个成员都保持 Pending,PodGroup 状态显示 UnschedulablePodGroup,直到资源满足才整组调度。
HPA Scale to Zero 的 ScaledToZero Condition 有什么作用?
ScaledToZero Condition 用于区分 HPA 自动归零和手动暂停。当 HPA 自己将副本缩到零时,ScaledToZero=True,Reason 为 ScaledToZeroScaledToZero,后续会继续评估指标并自动唤醒;手动将 Deployment 缩到零则保留暂停语义,不等同于自动归零。唤醒后该 Condition 变为 False,Reason 为 NotScaledToZero。
