


通过LlamaIndex微调Cohere重排序器以提升检索性能
内容提要
本文介绍了如何使用LlamaIndex对Cohere重排序器进行微调,以提升检索性能。通过创建自定义重排序器并进行训练,微调后的重排序器在检索效果上有显著改善。文章强调了选择硬负样本的重要性,并鼓励社区参与改进检索系统。
延伸解读
硬负样本的选择策略
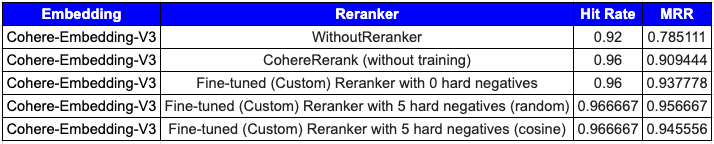
文章通过对比实验展示了硬负样本对微调效果的影响。使用随机采样和基于余弦相似度采样的硬负样本,均能提升检索性能,但具体哪种方法更优需根据数据集和参数进行实证评估。文章建议至少提供约5个硬负样本以获得有意义的改进,并鼓励社区探索最佳的硬负样本选择方法。
微调重排序器的数据要求
微调Cohere重排序器需要特定格式的数据,包括查询、相关段落和可选的硬负样本。训练集至少需要256对查询-相关段落,验证集至少64对(可选)。每个查询必须至少有一个相关段落。硬负样本虽为可选,但提供约5个能带来显著提升。数据格式为三元组,需注意查询与段落的token总数不超过510。
微调效果与评估指标
文章使用命中率(hit_rate)和平均倒数排名(MRR)作为评估指标,在Uber 2021 10K数据集上测试了不同重排序器的性能。结果显示,微调后的重排序器相比基础Cohere重排序器和无重排序器均有性能提升。但文章强调,结果依赖于所选数据集和参数,建议在纳入RAG管道前进行充分实验。
实践中的注意事项
微调过程预计需要25到45分钟,训练任务提交后可在Cohere仪表板查看状态。文章提醒,本指南的结果特定于所选数据集和参数,并非通用结论。读者应使用自己的数据集和多种参数进行实验,以确定是否适合集成到RAG管道中。此外,硬负样本的数量和采样方法应基于实证证据选择。
Q&A
如何使用LlamaIndex微调Cohere重排序器?
可以通过创建自定义重排序器并进行训练来微调Cohere重排序器,具体步骤包括设置环境、下载数据、创建节点、生成训练和验证数据集等。
选择硬负样本对微调重排序器有什么重要性?
选择硬负样本对微调重排序器的效果至关重要,能够显著提升检索性能,尤其是在训练过程中。
微调后的重排序器在检索性能上有何改善?
微调后的重排序器在检索性能上有显著改善,尤其是在使用硬负样本时,能够提高检索的准确性和效率。
社区如何参与改进检索系统?
社区可以通过探索最佳的硬负样本选择方法和分享经验来参与改进检索系统,推动技术的进步。
Cohere重排序器的自定义模型有什么优势?
Cohere重排序器的自定义模型可以根据特定领域或数据集进行微调,从而提升检索性能,适应不同的应用场景。
如何评估微调后的重排序器性能?
可以通过对比不同重排序器的检索结果,使用指标如命中率和平均倒排率(mrr)来评估微调后的重排序器性能。
