


为什么传统 VVC 在芯片上将比神经编解码器的热潮活得更久
内容提要
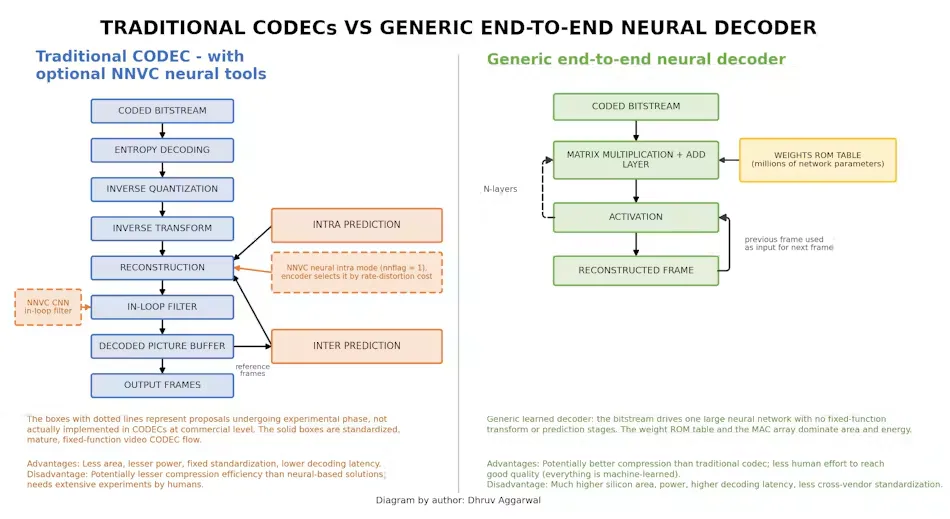
神经网络编解码器算法上可媲美VVC,但硬件成本高约一个数量级,且缺乏标准与许可体系;NNVC混合方案增益仅10–12%,难以收回芯片成本。因此消费级SoC应继续以VVC为主通路,仅在标准化和预算允许时加入NNVC辅助模块,端到端神经解码器暂不适用于消费芯片。
延伸解读
算法优势不等于芯片可行
文章指出,端到端神经编解码器在特定测试中可媲美甚至超越VVC,但硬件成本高一个数量级。已发表的NVCA ASIC在28nm下每像素14.6nJ,而传统VVC解码器估算仅1–1.5nJ。这意味着算法上的胜出无法直接转化为消费芯片的竞争力,芯片架构师需以能耗和面积底线评估技术路线,而非仅看BD-rate数字。
混合方案增益有限,标准化是关键门槛
JVET的NNVC混合方案仅带来10–12%的BD-rate增益,却需增加神经网络推理模块、片上ROM和验证成本。文章认为,该方案只有在未来标准正式批准后才在高端消费级ASIC中具备可行性。当前NNVC仍处探索阶段,缺乏比特精确的定点推理规范,这排除了许多NPU效率技术,增加了落地难度。
分层部署:VVC主通路,神经工具作辅助
文章建议未来五到七年继续以VVC(或AV1)作为主解码通路,因其成熟、行为确定且生态支持完善。神经工具应作为辅助模块,在标准化和预算允许时加入,并需为权重ROM、工作SRAM和验证工作量做好预算。端到端神经解码器暂不应进入消费级芯片,仅可能在VR/AR、机器视觉等特殊场景有限使用。
对芯片规划的务实启示
文章提醒芯片架构师不要为追逐神经编解码器而跳过VVC硬件支持,也不要过度配置NPU容量。神经工具的采用应与标准化时间表绑定,流片应反映真实存在的世界。这种保守策略并非否定神经编解码器的长期潜力,而是基于当前硬件成本、标准缺失和生态不成熟做出的务实判断。
Q&A
为什么说传统 VVC 在芯片上会比神经编解码器活得更久?
因为端到端神经解码器的硬件成本比成熟 VVC 芯片高约一个数量级,且缺乏标准与许可体系;混合方案增益仅 10–12%,难以收回芯片成本。因此消费级 SoC 应继续以 VVC 为主通路。
VVC 相比 HEVC 能节省多少码率?
VVC(H.266)是 HEVC(H.265)的继任者,在同等视觉质量下可带来约 40–50% 的码率降低。
JVET 的 NNVC 混合方案能带来多少编码增益?硬件上可行吗?
NNVC 探索中的两个神经工具(全连接帧内预测和卷积环路滤波器)合计约带来 10–12% 的 Y BD-rate 增益。硬件成本比端到端神经解码器低,但仍相当可观,只有在未来标准正式批准后才在高端消费级 ASIC 中具备可行性。
端到端神经解码器 ASIC 的能效比传统 VVC 差多少?
已发表的端到端神经解码器 ASIC(NVCA)采用台积电 28 nm 工艺,约每像素 14.6 nJ;而同节点传统 VVC 解码器大致在每像素 1–1.5 nJ,相差约一个数量级。
为什么端到端神经编解码器目前不适合消费级芯片?
硬件成本过高(每像素能耗比 VVC 差一个数量级)、没有已批准的标准、缺乏跨厂商互操作性和专利许可框架,且消费设备对散热、功耗、标准化和功能安全有严格要求。
芯片架构师应如何规划 VVC 与神经编解码器的部署?
让传统 VVC 继续作为主通路,未来五到七年内 VVC(或 AV1)解码器模块仍是正确选择;在标准化与预算允许时,把 NNVC 工具作为辅助模块加入;通用型端到端神经解码器模块不应进入消费级芯片。
