

七大Python时间序列分析与建模库
内容提要
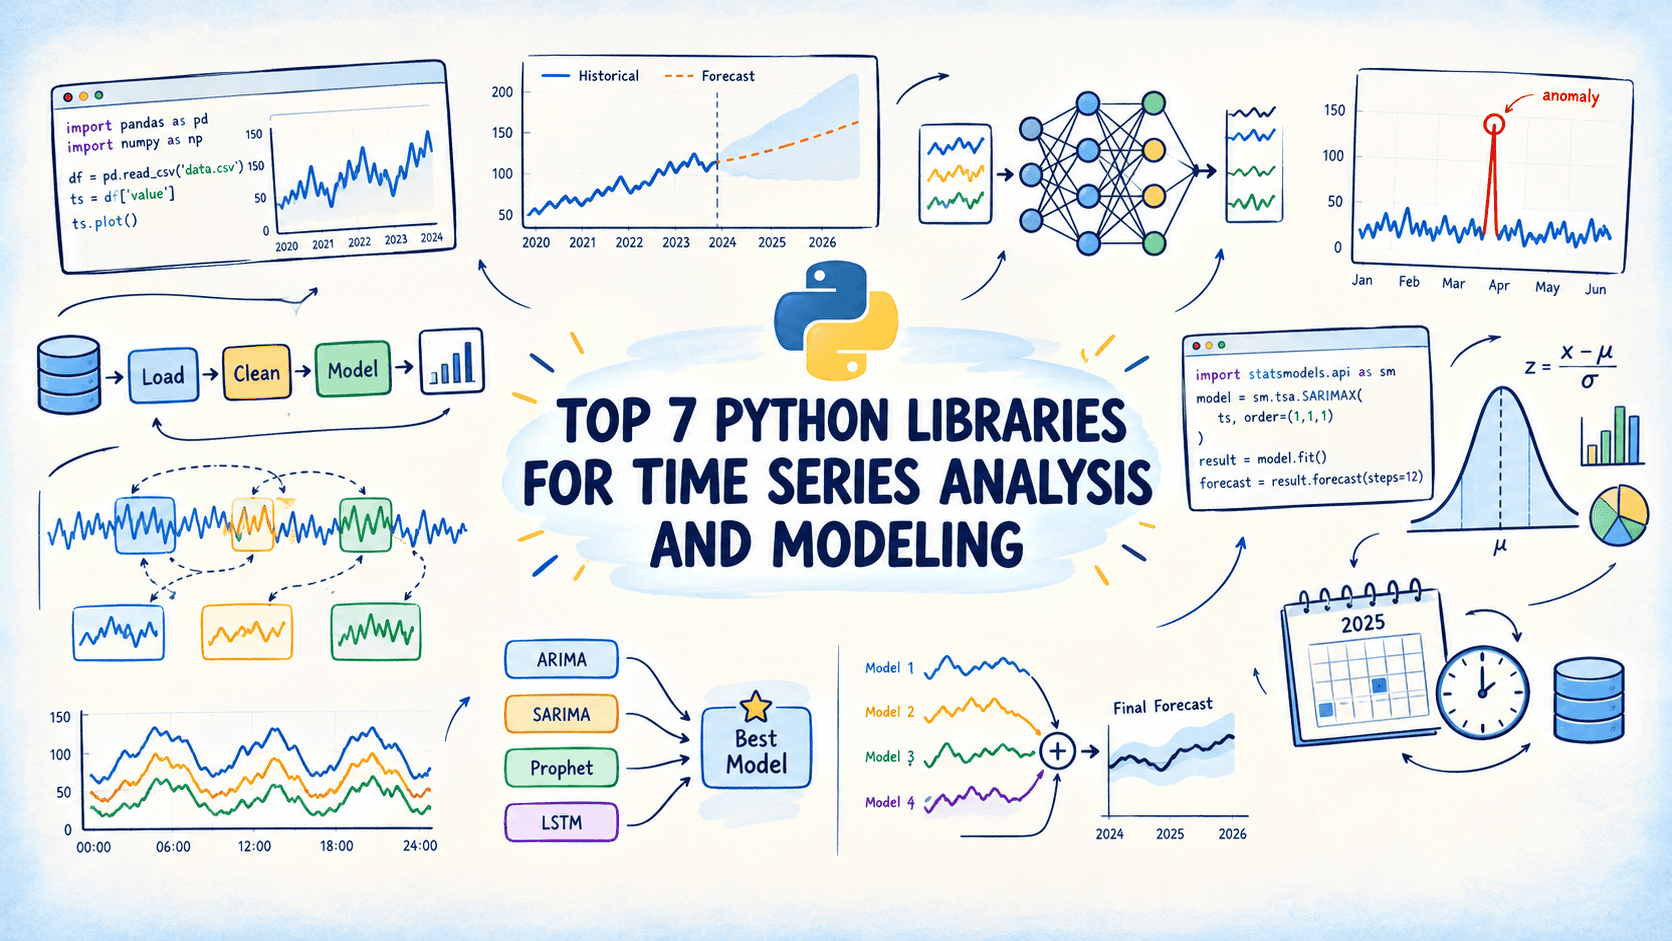
文章介绍了七个Python时间序列库:statsmodels用于可解释的ARIMA等统计建模;pmdarima自动搜索ARIMA阶数;sktime提供统一的机器学习接口与防泄漏交叉验证;Darts支持概率预测、多序列全局模型及异常检测;stumpy通过矩阵轮廓发现模式和异常;PyOD汇集60多种异常检测算法;NeuralForecast提供30多种深度学习预测架构。建议在同一数据集上对比使用这些库。
延伸解读
选型先看任务类型,而非模型热度
文章将七个库按任务定位划分:统计建模选statsmodels,自动定阶选pmdarima,统一机器学习流程选sktime,概率与多序列预测选Darts,无监督模式发现选stumpy,特征矩阵异常检测选PyOD,深度学习预测选NeuralForecast。读者应先明确问题是“预测未来”“发现模式”还是“检测异常”,再对应选择,避免用同一套工具硬套所有场景。
注意库的维护状态与适用边界
文章特别提醒pmdarima近期开发放缓,新生产管线需先查更新日志。PyOD虽已扩展到时序等模态,但最常用场景仍是人工构造的特征矩阵,而非原始序列。stumpy适合回答“数据里有什么模式”,而非“下一步会发生什么”。这些边界说明能帮助读者避免误用,也提示在关键项目中评估替代方案。
统一接口与防泄漏验证是工程关键
sktime的价值在于用一致接口切换ARIMA、梯度提升和神经网络,并提供尊重时间顺序的交叉验证,避免通用交叉验证在序列数据上造成泄漏。Darts和NeuralForecast则强调用全局模型覆盖大量相关序列,并内置回测或时序交叉验证。对需要可复现、可比较工作流的团队,这些工程特性比单个模型精度更值得关注。
用同一数据集对比,比看排行榜更有收获
文章建议把这些库应用到同一数据集上比较结果,并理解模型为何如此表现。这能帮助读者判断统计模型、机器学习模型和深度学习模型在当前数据上的实际差异,而不是盲目追随基准表。对比时还应结合各库的诊断输出、预测区间和异常分数,形成对数据本身更完整的认识。
Q&A
Python时间序列分析有哪些常用库?
文章介绍了七个库:statsmodels(统计建模)、pmdarima(自动ARIMA)、sktime(统一机器学习接口)、Darts(概率预测与多序列)、stumpy(模式发现)、PyOD(异常检测)、NeuralForecast(深度学习预测)。
statsmodels在时间序列分析中有什么优势?
statsmodels适合需要可解释性的场景,实现了完整的ARIMA家族(包括SARIMAX),提供置信区间、AIC/BIC评分和诊断图,还包含指数平滑模型和平稳性检验等统计测试。
如何自动选择ARIMA模型的参数?
可以使用pmdarima库的auto_arima函数,它通过逐步搜索候选ARIMA阶数,基于AIC或BIC评分自动选择最佳参数,无需手动分析ACF/PACF图。
sktime库的主要用途是什么?
sktime提供统一的接口用于时间序列的预测、分类、回归、聚类和标注,支持构建复合模型(如流水线、集成)和时序感知的交叉验证,避免数据泄漏,并能与scikit-learn、statsmodels等库直接对接。
Darts库在时间序列预测中有哪些特色?
Darts支持概率预测(返回预测区间),可训练跨多个序列的全局模型,包含回测工作流和异常检测模块,覆盖从指数平滑到深度学习的多种模型。
stumpy库如何用于时间序列的模式发现?
stumpy通过计算矩阵轮廓(matrix profile)来发现频繁出现的子序列(模体)和异常子序列( discord),无需标注数据,支持CPU/GPU加速,适用于传感器数据等场景。
PyOD库支持哪些异常检测算法?
PyOD实现了超过60种异常检测算法,包括基于邻近度、线性、集成和深度学习的方法,提供统一的接口和连续异常分数,并支持并行训练和评估。
NeuralForecast库适合什么场景?
NeuralForecast适合当经典和机器学习模型效果不佳时,使用深度学习进行预测。它提供30多种神经架构(如PatchTST、TimesNet、TimeLLM),支持外生变量、自动超参数调优和时序交叉验证,专为多序列预测设计。
