


如何在Python中构建面向图像和文档的多模态RAG流水线
内容提要
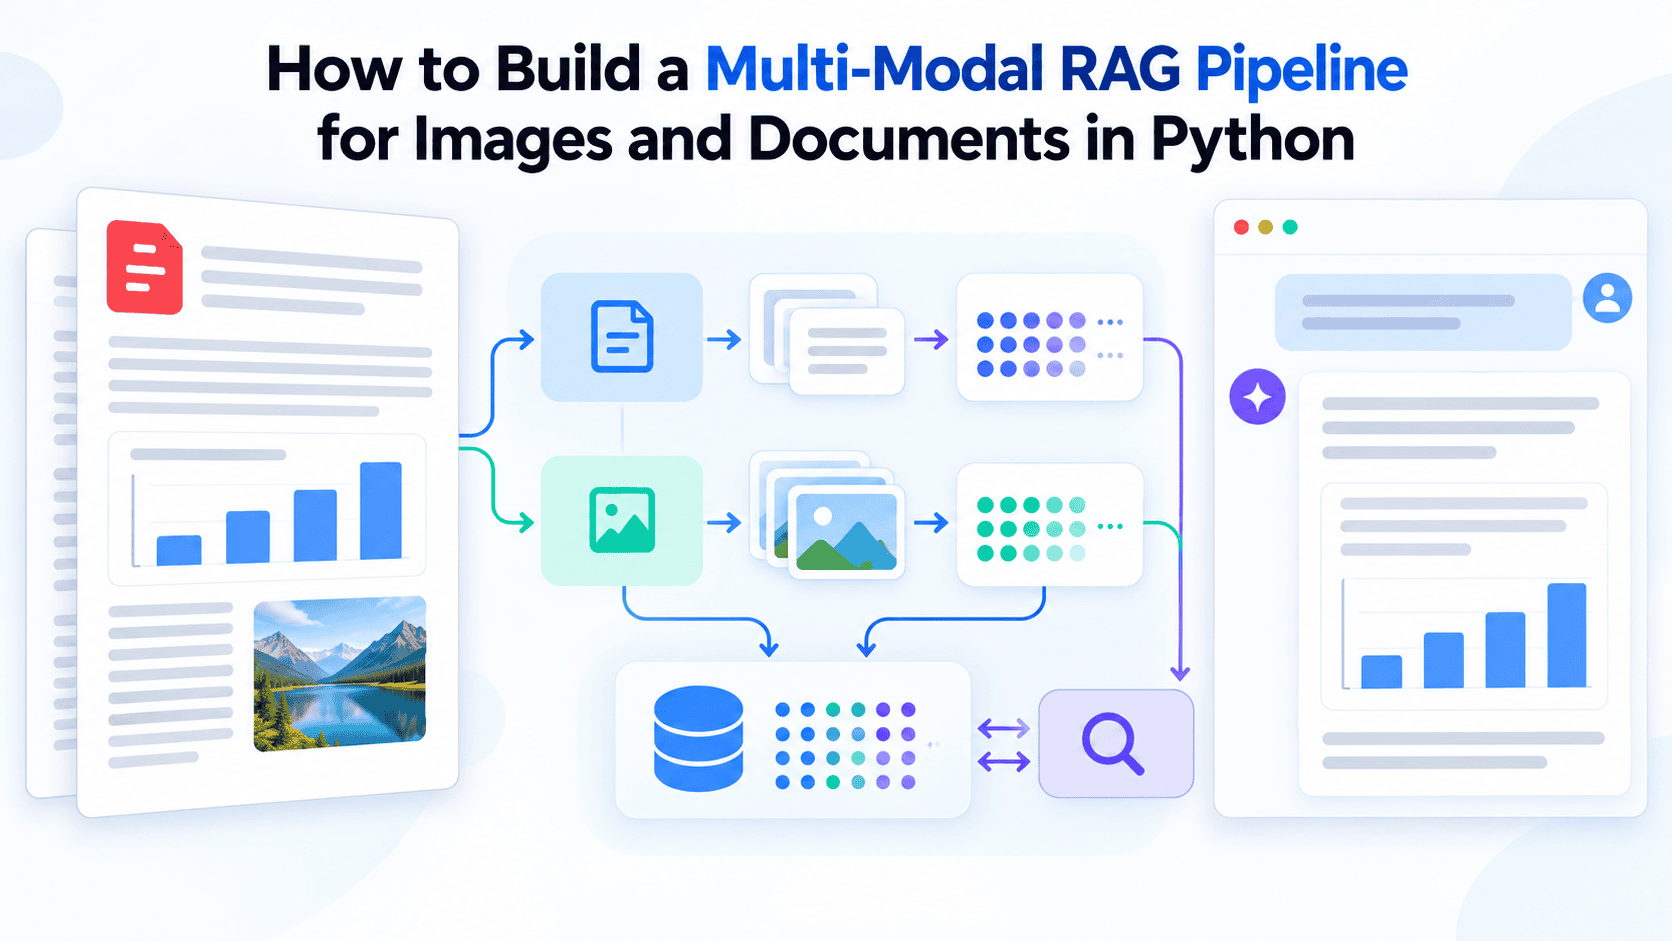
本文介绍用Python构建多模态RAG流水线以处理含图表和图片的复杂PDF,流程分四步:用unstructured库将PDF解析为文本块和图片;用GPT-4o为每张图片生成可检索的文字摘要;用MultiVectorRetriever建立向量库与文档库双存储,以ID关联摘要与原始内容;查询时检索文本和图片摘要,将原始图片与文本一并传给GPT-4o生成有据可依的答案。该方案适用于研究报告、财务文档等图文混排文件。
延伸解读
多模态RAG的核心:为图片生成可检索摘要
传统RAG只处理文本,遇到含图表、扫描图的PDF时,文本分块会破坏表格结构并跳过图片,导致答案不完整。本文方案的关键在于用GPT-4o为每张图片生成稠密描述,作为可检索的文本代理。这样向量库能通过自然语言查询匹配到图片摘要,再通过ID关联取回原始图片,与文本一起送入GPT-4o生成答案。这使图片成为一等检索对象,而非附属信息。
双存储架构:向量库与文档库分离
MultiVectorRetriever维护两个存储:向量库存放文本块和图片摘要的嵌入,用于相似度搜索;文档库存放原始文本和图片路径,通过唯一ID与向量库关联。查询时先检索摘要,再根据ID取回原始内容。这种设计避免了直接嵌入原始图片的困难,同时保留了原始证据供最终生成使用。代码中为每个元素生成UUID,并用metadata的type字段区分文本和图片,使检索逻辑清晰。
成本与过滤:索引阶段需注意图片数量
每张提取的图片都会触发一次GPT-4o API调用,用于生成摘要。对于包含大量图标、logo的文档,索引成本会显著增加。文章建议在调用summarize_image前,按文件大小过滤掉过小的图片。此外,该方案依赖OpenAI API和poppler-utils,适合标准硬件上的业务文档场景,但需考虑API调用延迟和费用。若追求本地化,可参考其他PyTorch方案,但本文未展开。
可扩展方向:重排序与持久化
文章在结论中提出几个延伸方向:加入重排序(re-ranking)提升检索精度;将Chroma向量库持久化到磁盘以供生产使用;或探索ColPali等视觉语言模型,直接嵌入文档页面图像,跳过解析步骤。这些方向表明当前流水线是基础版本,实际部署时可根据需求增强。但文章未提供这些扩展的具体实现,读者需自行研究。
Q&A
为什么普通的RAG处理不了带图表和图片的PDF文档?
标准RAG只擅长纯文本。当PDF包含嵌入图表、扫描图或数据表时,基于文本的分块会破坏表格格式并跳过图片,导致流水线只能基于不完整的文档信息回答问题。
构建多模态RAG流水线需要安装哪些Python包和系统依赖?
需要安装langchain、langchain-openai、unstructured[pdf]、chromadb和pillow这些Python包,以及系统依赖poppler-utils(unstructured用它从PDF中提取图片)。同时需要设置OpenAI API密钥环境变量。
如何用unstructured库把PDF拆分成文本块和图片?
使用unstructured的partition_pdf()函数,设置extract_image_block_types=["Image"]、extract_image_block_output_dir指定图片保存目录、infer_table_structure=True推断表格结构、chunking_strategy="by_title"并按标题分块。然后遍历返回的元素,将CompositeElement类型归为文本块,将Image类型归为图片并记录其metadata.image_path。
为什么需要为每张图片生成文字摘要?如何生成?
因为基于文本的向量数据库无法直接索引原始图片,所以每张图片需要一个可被自然语言查询检索到的文本表示。生成方法是:将图片base64编码后,连同提示词“Describe this image in detail for use in a search system.”一起发送给GPT-4o,返回的详细描述即作为该图片的可检索摘要。
MultiVectorRetriever是如何关联图片摘要和原始图片的?
MultiVectorRetriever维护两个存储:向量库存储文本块和图片摘要的嵌入,用于相似度搜索;文档库存储原始内容(文本块或图片路径)。为每个元素生成唯一ID,向量库中的文档元数据包含该ID,文档库用相同ID存储原始Document,从而通过ID将嵌入摘要与原始内容关联起来。
查询时如何将检索到的文本和图片一起传给GPT-4o生成答案?
查询时,检索器对问题做嵌入并在文本和图片摘要中找最接近的匹配。对于匹配到图片的文档,根据元数据中的type字段判断,加载原始图片文件并base64编码,构造image_url内容;文本块则直接作为text内容。然后将文本内容、图片内容和用户问题组合成一个多模态消息,发送给GPT-4o,由其基于文本和视觉证据生成最终答案。
这个多模态RAG流水线适合哪些应用场景?
适合处理信息主要存在于图表、示意图或嵌入图形中的文档,例如研究报告、财务报告、产品手册,以及任何混合文本和视觉内容的文档类型。
构建这个流水线时有哪些成本或优化注意事项?
每张提取的图片在索引时都会触发一次GPT-4o API调用,产生成本。如果文档包含大量嵌入的logo或图标,建议在调用summarize_image()之前过滤掉小于最小文件大小的图片。此外,可以扩展流水线加入重排序以提高检索精度,或将Chroma向量库持久化到磁盘以供生产使用。
