


测试Anthropic Claude的100K令牌窗口在SEC 10-K文件上的表现
内容提要
Anthropic最近推出的100K上下文窗口模型能够处理约75,000个单词,适合分析SEC 10-K文件。尽管在整体理解和速度上表现良好,但在复杂提示的推理能力和成本方面仍存在不足,需要优化以提高效率和准确性。
延伸解读
实际处理能力与分块需求
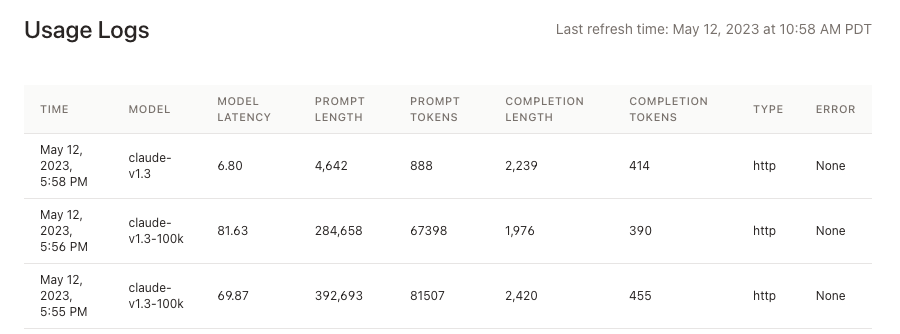
尽管Anthropic的100K上下文窗口能容纳约75,000个单词,但单个UBER 10-K文件实际包含约160K个令牌,远超窗口限制。因此,即使使用该模型,仍需将文件分块处理,无法一次性完整输入。这提醒我们,在处理大型文档时,需预先评估令牌数量,并合理设计分块策略,以充分利用模型能力。
响应合成策略的选择影响结果
文章测试了两种响应合成策略:默认的“创建-改进”和“树总结”。在“创建-改进”策略下,模型返回了包含原始答案和精炼答案的混合结果,未能正确理解提示。而“树总结”策略则生成了更准确、详细的回答。这表明,对于复杂查询,选择合适的合成策略至关重要,开发者可能需要根据任务调整默认设置。
成本与延迟的权衡
使用100K模型处理单个10-K文件,每次查询成本约1-2美元,且延迟约150秒。虽然比多次调用GPT-3更快,但成本较高。处理多个文件时,延迟增至9-10分钟,成本进一步累积。因此,在享受大上下文窗口便利的同时,需权衡成本与响应速度,尤其对于高频或实时性要求高的场景。
多文档分析的局限性
在尝试比较多个年份的10-K文件时,模型仅分析了2019年文件中的风险因素(涵盖2017-2018年),未能涵盖2020年及以后的内容。这可能是由于树总结策略的递归特性导致信息丢失。说明简单地将多文档塞入大上下文窗口,并不总能保证全面分析,可能需要更复杂的检索或合成方法。
Q&A
Anthropic的100K上下文窗口模型能处理多少个单词?
该模型能够处理约75,000个单词。
使用Anthropic的模型分析SEC 10-K文件的速度如何?
模型能够在60-90秒内处理整个UBER 10-K文件。
在复杂提示的推理能力方面,Anthropic的模型表现如何?
模型在复杂提示的推理能力方面表现不佳,常返回不正确或无关的结果。
使用“树总结”策略时,模型的表现如何?
使用“树总结”策略时,模型能够更好地回答问题,提供更详细的风险因素分析。
使用Anthropic模型分析SEC文件的成本是多少?
每个查询的成本约为1美元,处理数十万个标记的费用迅速累积。
UBER的风险因素在SEC文件中是如何演变的?
UBER的风险因素随着时间的推移不断演变,反映了公司面临的关键问题和挑战。
