商汤大装置CTO宣善明指出,Agentic时代Token需求将增长千倍,AI基础设施须从规模扩张转向效率优化。商汤通过PD分离与异构混合调度构建万卡级推理集群,以动态角色切换应对故障与闲置,特定配置下Token吞吐提升至5倍。未来将探索跨域PD分离与AF分离,并以Token工厂模式提升产能,日均服务量已达6万亿。
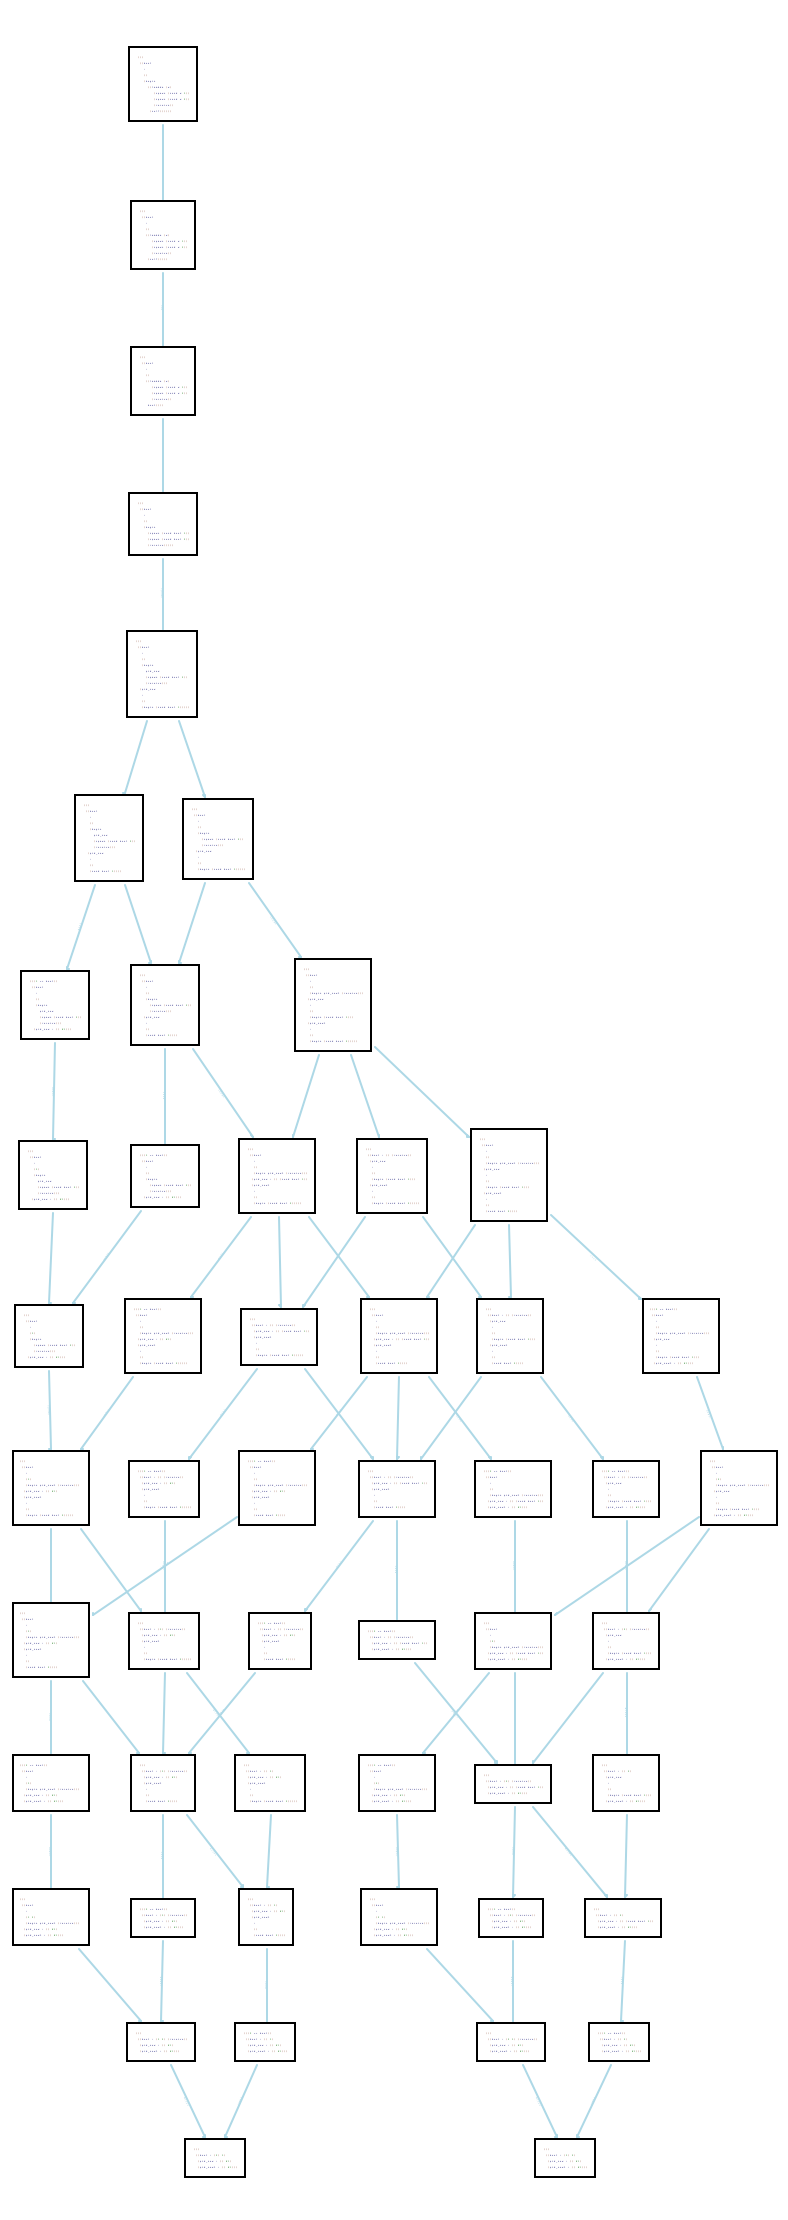
本文介绍使用PLT Redex建模Actor系统时,通过减少不可观察的非确定性来提高效率。作者将内部计算与通信效果分离,合并发送和投递规则,并采用贪婪归约,使示例程序的评估时间从1015毫秒降至2毫秒,状态数从74减至13。最终模型更简洁,能更真实地反映Actor的观察能力,但要求Actor不发散。
文章讨论了如何优化软件交付流程,以更好地利用人工智能代理。当前手动软件开发生命周期(SDLC)中的审批和交接环节导致效率低下。建议通过建立清晰的上下文、保护措施和可见性来重构交付流程,分为规划、审核、开发、预览和部署五个阶段,确保信息的完整性和透明度,以实现从工单创建到生产部署的高效转变。
本文讨论了大语言模型(LLM)推理引擎的现代化技术,包括连续批处理和分页注意力。这些技术显著提升了LLM的吞吐量和GPU利用率,同时优化了显存利用率。文章还介绍了分块预填充和前缀缓存等策略,以降低延迟和提高效率,强调在生产环境中应用这些技术的重要性。
Font Awesome 最近优化了其问题跟踪系统,关闭了现有的图标请求问题,并鼓励用户在需要时重新提交请求。此举旨在提高效率,专注于重要的错误报告和可操作事项。团队将利用 GitHub Discussions 组织其他讨论,以确保更清晰的沟通和管理。
文章讨论了AI基础设施的最新动态,包括NVIDIA的Feynman架构和Rosa CPU、LinkedIn的LLM内容排序系统以及Armis的安全报告。强调了LLM技术从研究到生产的重要性,以及在安全性和效率优化方面面临的挑战。智能体基础设施逐渐成熟,涵盖计算、编排、记忆和金融等多个层面。
尽管云计算普及,物理IT基础设施依然重要。IT运营需确保系统可靠性并减少故障。硬件故障率高,需有效管理。BMC Helix与Sentry Software结合,提供主动监控,提升可见性,减少停机时间,优化效率。
喷砂是机械和航空制造行业的关键表面处理工艺。许多公司因设备参数配置不当导致效率低下和成本增加。本文提出优化喷砂效率的步骤,包括明确目标、调整关键参数、设备测试、自动化监控和定期维护。这些方法可提升喷砂效率20-30%,并延长设备使用寿命。
本研究提出了AutoSculpt框架,旨在优化深度神经网络在边缘设备上的部署。通过结合图学习和强化学习,AutoSculpt能够自动识别并剪除DNN中的模式,显著提高效率,同时保持模型准确度。实验结果表明,剪枝率可达90%,计算量减少近18%。
本研究提出FuzzDistill方法,通过编译时分析和机器学习优化模糊测试目标,解决效率低下和资源消耗问题,能够识别高优先级漏洞区域,显著减少测试时间。
本研究提出了一种新方法,优化大型语言模型处理长文本的效率,减少不重要标记的内存和计算负担。研究发现,近标记更为重要,通过层间共享注意力得分,节省了35%的KV缓存。
云计算改变了组织运作方式,但要实现其价值,需要战略管理成本与资源。FinOps连接财务、云运营与DevOps团队,确保云投资与业务目标一致。尽管89%的公司认为FinOps是解决云成本管理复杂性的关键,但近45%对其效果存疑。成功实施FinOps需明确目标、建立成本架构、设定现实KPI、测试工具、共享责任及早期参与利益相关者。应建立跨职能团队,转向主动的FinOps策略,持续优化以提升效率与降低支出。
本研究提出了一种基于深度强化学习的masked PPO算法,用于优化太空碎片会合任务的规划效率。通过优化碎片访问顺序,任务总时间比遗传算法和贪婪算法分别减少约10.96%和13.66%。这一创新为太空碎片清除任务提供了新思路。
《Chameleon: 混合模态早期融合基础模型》介绍了一种新的单一Transformer架构,称为Chameleon,该架构对混合模态序列进行建模,以实现无缝推理和生成。Meta FAIR团队提出了模态感知稀疏架构(MoMa),通过集成特定于每种模态的模块来优化此框架。实验结果表明,MoMa模型在各种下游任务中表现出色。此外,团队进行了效率优化和吞吐量分析,证明了MoMa的高效性。
本文介绍了跨模态图像-文本检索的研究进展,涵盖特征提取、对齐和效率优化等方面。评估了2003至2016年的检索算法,并提出未来研究方向。研究了结合语音和图像的检索方法,提出了知识增强的双流框架KEDs,表现优于以往方法。此外,介绍了新数据集ReMuQ和Retriever模型ReViz,提升了多模态查询的检索效果。
本文综述多种大语言模型效率优化方法:Hyena用长卷积替代注意力以降低训练成本;GLA引入门控线性注意力;Medusa通过额外解码头并行预测加速推理;FlexGen优化有限GPU下的推理;LightSeq降低长上下文训练的通信开销;SparQ Attention减少内存带宽占用;多查询注意力加速解码;FLASH改良Transformer;PagedAttention与vLLM提升吞吐量。
本文综述长文本摘要与长序列建模进展,提出局部自注意力与显式内容选择方法处理长跨度依赖,在多个数据集上取得最优ROUGE;并介绍S4、压缩Transformer、LSG注意力、Hepos、Block-State Transformer等方法,以提升长序列效率与准确率,降低内存与计算成本。
该文综述了多种提升视觉Transformer效率的方法,包括:A-ViT通过自适应减少令牌数提高效率;基于剪枝与恢复的3D人体姿态估计方法;语义标记ViT通过降维提升效率;SVT利用语义池模块减少视频冗余;可学习回归标记用于视频事件定位;FPGA硬件高效标记修剪框架HeatViT;STTS动态选取视频关键信息;VTN视频识别框架实现提速;AVT基于注意力预测未来动作,在多个基准测试中表现优异;EVAD高效视频动作检测框架降低计算复杂度并提速。
本文介绍了美团外卖智能陪伴型导购的探索与尝试,通过智能刷新推荐框架、策略、用户行为建模和效率优化等方法提升用户选购效率和个性化体验。取得了增加搜索UV_RPM、搜索UV_CXR和框内词UV_CTR等指标的成果。未来将继续探索智能刷新、大模型赋能导购和打破反馈闭环等方向。
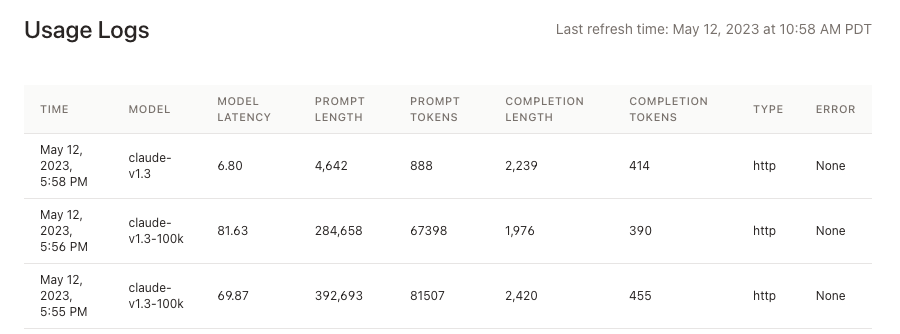
Anthropic最近推出的100K上下文窗口模型能够处理约75,000个单词,适合分析SEC 10-K文件。尽管在整体理解和速度上表现良好,但在复杂提示的推理能力和成本方面仍存在不足,需要优化以提高效率和准确性。
完成下面两步后,将自动完成登录并继续当前操作。