


让每一字节发挥更强性能:全栈协同设计如何破解AI内存难题
内容提要
英伟达提出“全栈协同设计”以应对AI内存压力:模型参数、KV缓存和RAG数据激增使HBM容量与带宽成为瓶颈。其方案包括用NVFP4压缩权重与KV缓存、在NVL72内分布式存放权重、借助Vera CPU和Dynamo软件将闲置上下文卸载至CMX存储层,并让RAG索引留在HBM之外,从而提升每字节内存的有效产出。结果显示,Vera Rubin NVL72每美元吞吐量较GB300 NVL72最高提升30倍,而每GPU的HBM容量仅增约3%。
延伸解读
内存墙:容量之外,带宽才是关键约束
文章用仓库与装卸口的比喻说明,HBM容量扩大并不自动转化为吞吐提升。当内存带宽无法跟上计算速度时,额外容量既不能有效利用,还会增加成本和功耗。这解释了为何英伟达不单纯堆叠HBM,而是通过压缩、分层和调度让数据在正确的时间出现在正确的层级。对读者而言,评估AI硬件时应同时关注带宽与容量配比,而非只看HBM数字。
分层卸载:让闲置上下文离开最贵的内存
文章指出,KV缓存和RAG数据并非时刻都需要留在HBM中。英伟达通过Dynamo软件将暂停使用的上下文移至CMX共享存储层,并在复用前取回;RAG索引则借助cuVS留在CPU和存储侧,只有必要段落进入上下文。这种分层思路的核心是区分“正在用”和“等待用”的数据,从而把有限的HBM留给并发用户,而不是被闲置状态占用。
每美元吞吐量:比HBM容量更贴近运营的指标
文章给出的对比显示,从GB300 NVL72到Vera Rubin NVL72,每GPU的HBM容量仅增约3%,但在SemiAnalysis AgentX负载下每美元吞吐量最高提升30倍。这一差距说明性能提升主要来自全栈协同设计,而非内存扩容。对AI工厂运营者而言,在功耗预算内交付多少满足响应时延的有用token,比单纯比较HBM容量更能反映实际成本和收益。
Q&A
为什么AI推理越来越依赖HBM,导致内存压力增大?
前沿模型参数已达数万亿,KV缓存随长上下文和智能体轨迹膨胀(单次请求可处理高达300万token),RAG又引入更多企业上下文,这些都需要HBM存放,从而加剧了HBM容量与带宽的竞争。
英伟达的“全栈协同设计”具体指什么?
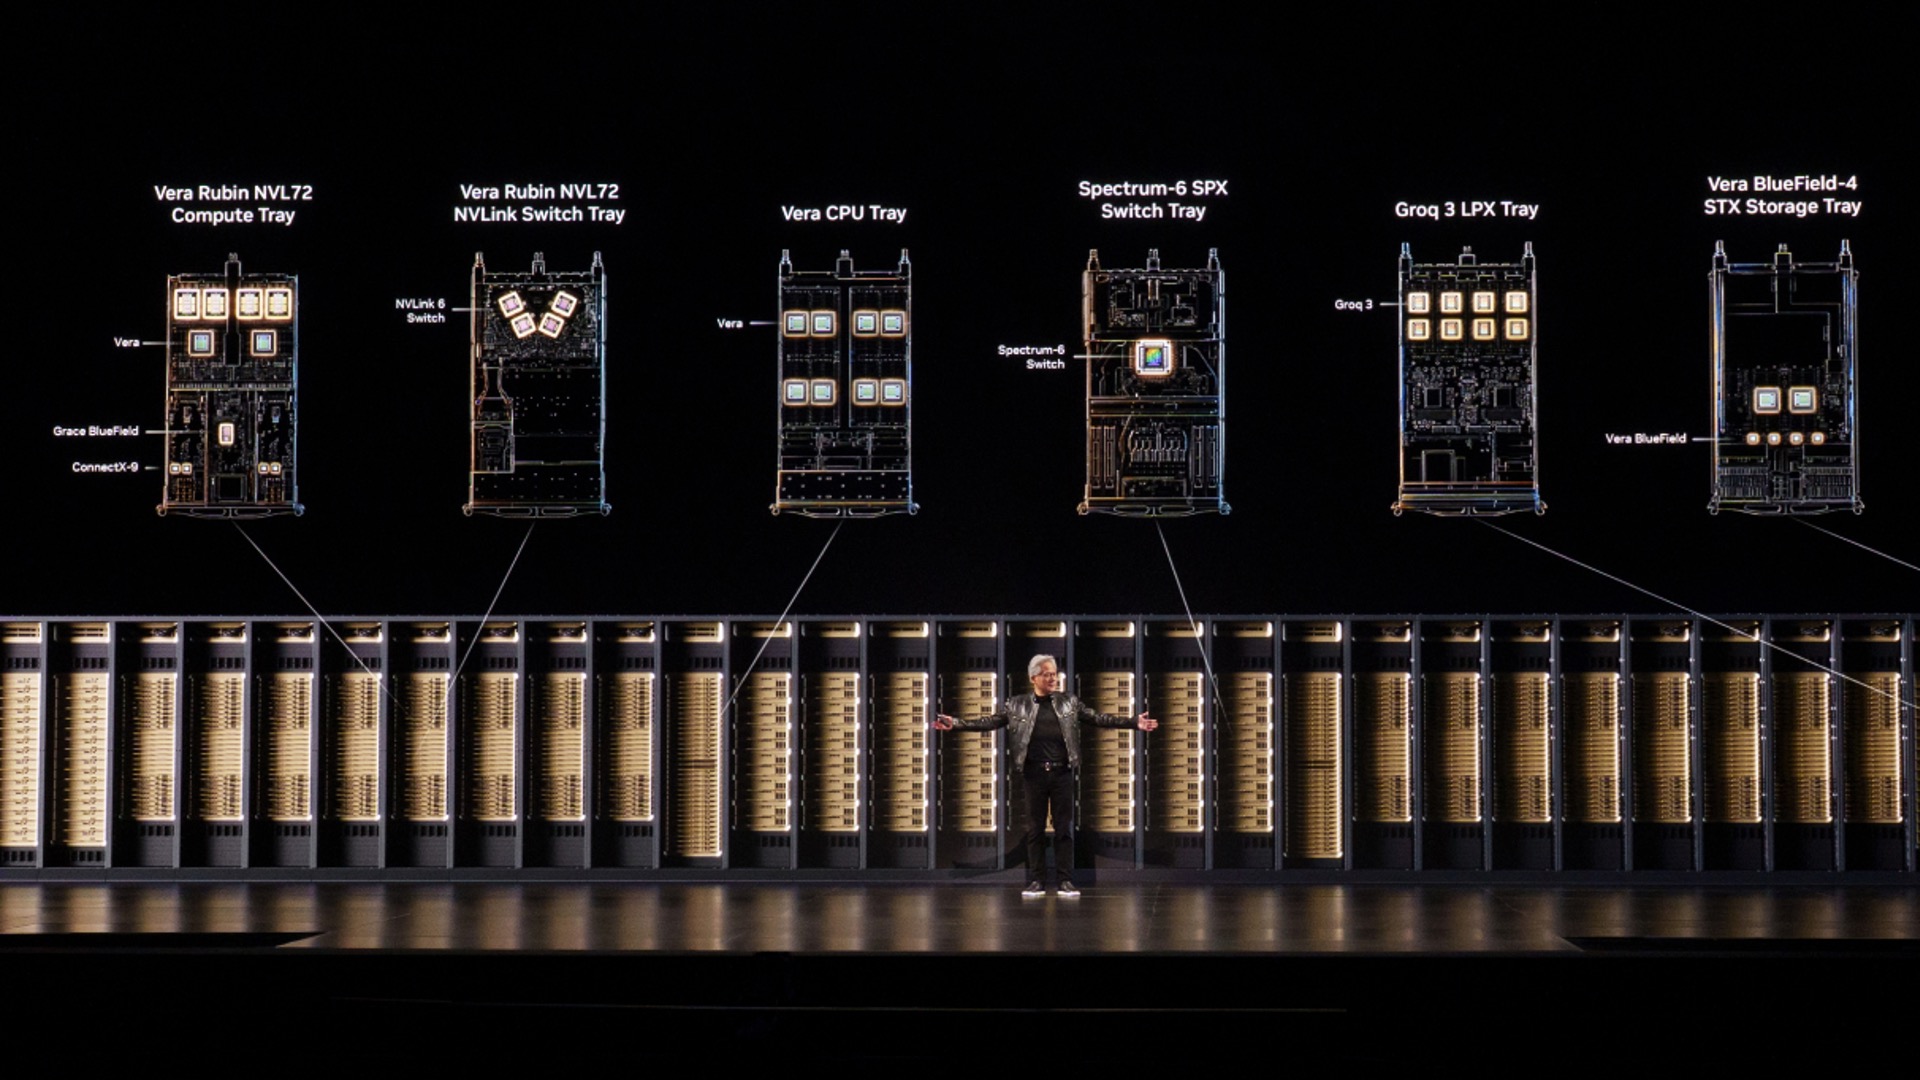
全栈协同设计是指英伟达有意将GPU、CPU、网络、存储和软件一起设计,以便在AI工厂的每一层内存层级上让每个字节完成更多有效工作,而不是简单地在GPU上堆叠更多内存。
什么是“内存墙”,为什么单纯增加HBM容量无法解决问题?
内存墙是指内存带宽无法像计算单元消耗数据那样快地供给数据。HBM容量好比仓库,带宽好比装卸码头;码头容量有限时,增加仓库面积也无法加快进出速度,反而增加成本和功耗,因此额外容量无法有效利用。
英伟达如何压缩模型权重和KV缓存来节省HBM?
采用NVFP4格式压缩模型权重和KV缓存,相比FP8占用更少空间;同时模型权重可分布式存放在NVL72系统最多72块GPU上,每块GPU只承担一小部分,从而为KV缓存和并发用户留出更多HBM。
不活跃的上下文数据会被卸载到哪里?如何管理?
不活跃的上下文由NVIDIA Dynamo推理软件卸载到NVIDIA CMX上下文内存存储层,该层每比特成本远低于HBM且跨服务器共享;需要时再返回GPU。Dynamo的KV缓存复用功能将GPU内存、CPU内存和存储中的KV缓存作为系统级资源统一管理。
RAG索引如何避免占用宝贵的HBM?
NVIDIA Nemotron Retriever模型生成更小且检索更准确的嵌入,cuVS库支持在CPU和存储上构建和提供索引,使知识库不占用HBM,只有模型需要的段落才进入上下文。
全栈协同设计带来了怎样的性能提升?
在SemiAnalysis AgentX的DeepSeek V4 Pro工作负载上,GB300 NVL72每美元吞吐量比H200平台最高提升10倍(每GPU HBM容量约翻倍);Vera Rubin NVL72在每用户125 token/秒时,每美元吞吐量比GB300 NVL72最高提升30倍,而每GPU HBM容量仅增约3%。
