小红花·文摘
  • 首页
  • AI Tokens🪙
  • 排行榜🏆
  • 直播
  • FAQ
沉浸式翻译 immersive translate
Dify.AI
让每一字节发挥更强性能:全栈协同设计如何破解AI内存难题

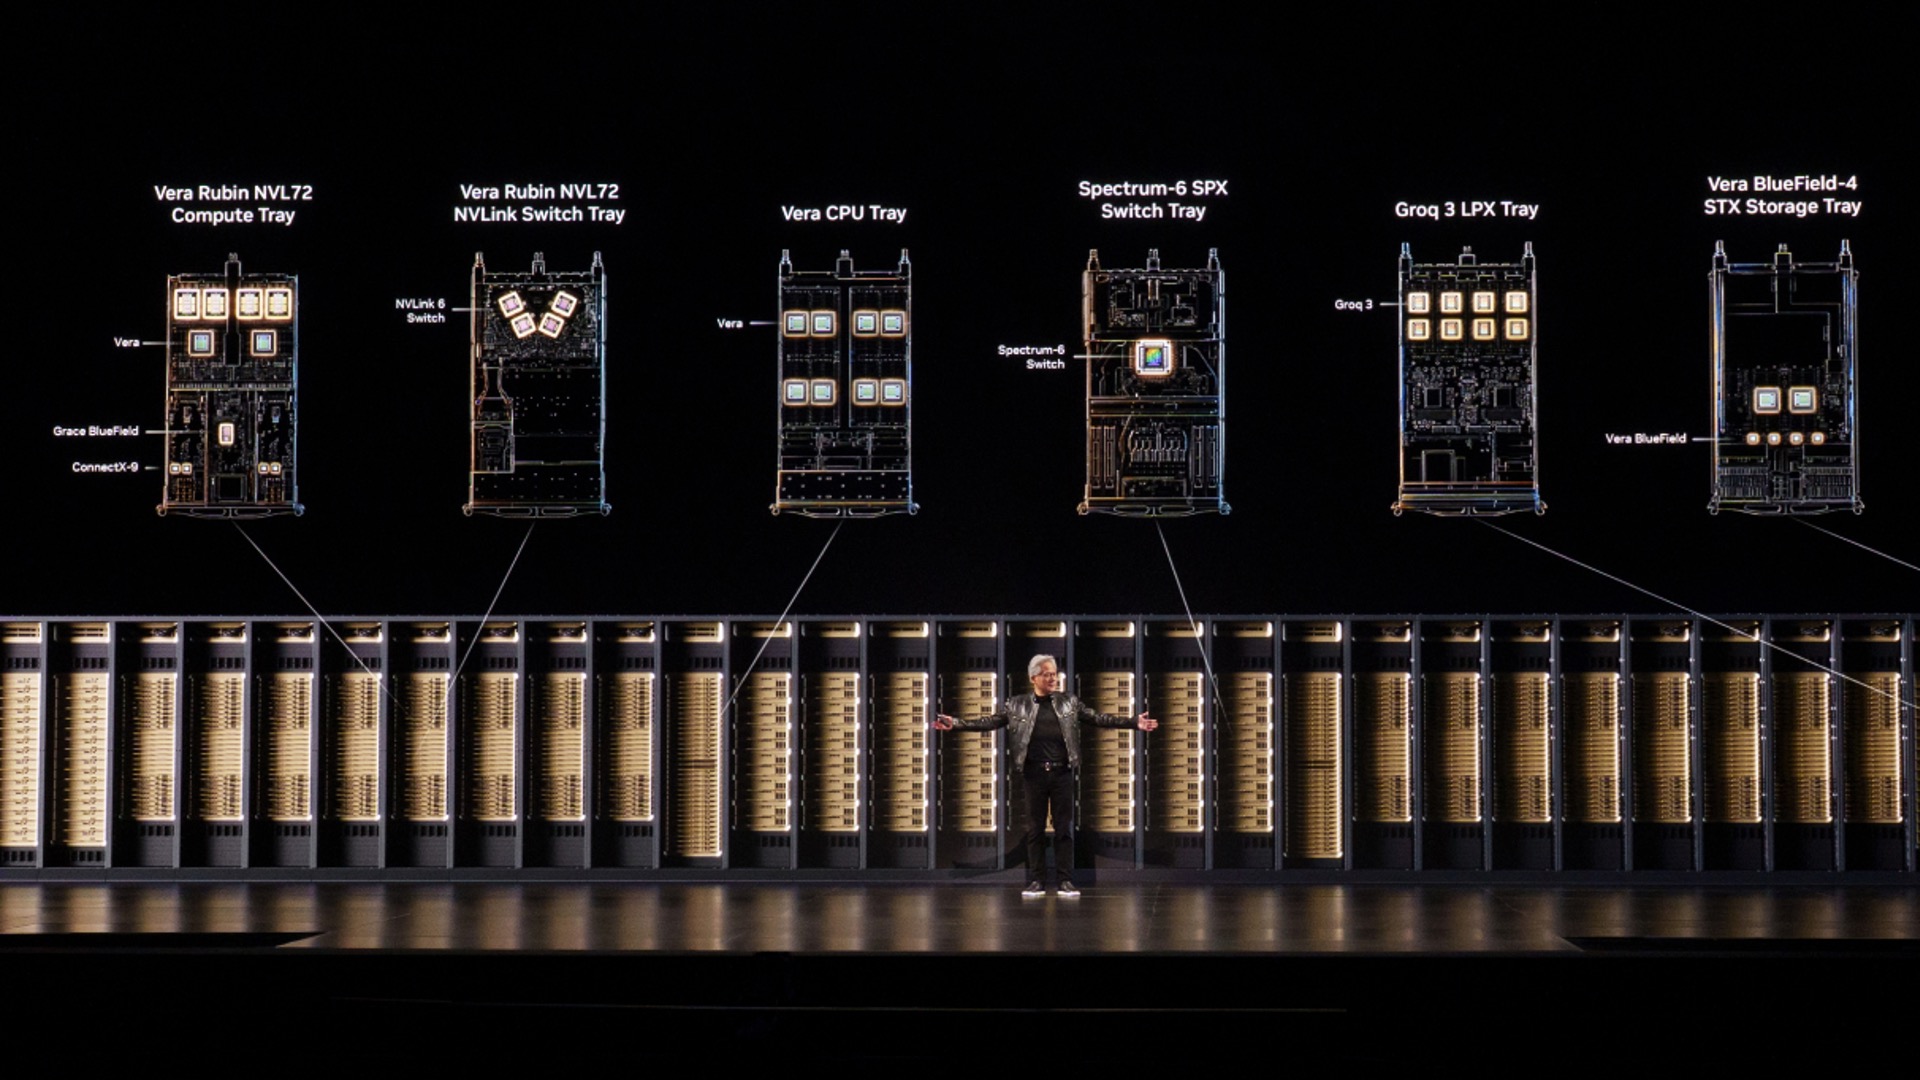
英伟达提出“全栈协同设计”以应对AI内存压力:模型参数、KV缓存和RAG数据激增使HBM容量与带宽成为瓶颈。其方案包括用NVFP4压缩权重与KV缓存、在NVL72内分布式存放权重、借助Vera CPU和Dynamo软件将闲置上下文卸载至CMX存储层,并让RAG索引留在HBM之外,从而提升每字节内存的有效产出。结果显示,Vera Rubin NVL72每美元吞吐量较GB300 NVL72最高提升30倍,而每GPU的HBM容量仅增约3%。

让每一字节发挥更强性能:全栈协同设计如何破解AI内存难题

NVIDIA Blog NVIDIA Blog · 2026-11-05T16:00:00Z
  • <<
  • <
  • 1 (current)
  • >
  • >>
👤 个人中心
在公众号发送验证码完成验证
登录验证
在本设备完成一次验证即可继续使用

完成下面两步后,将自动完成登录并继续当前操作。

1 关注公众号
小红花技术领袖公众号二维码
小红花技术领袖
如果当前 App 无法识别二维码,请在微信搜索并关注该公众号
2 发送验证码
在公众号对话中发送下面 4 位验证码
小红花技术领袖俱乐部
小红花·文摘:汇聚分发优质内容
小红花技术领袖俱乐部
Copyright © 2021-
粤ICP备2022094092号-1
公众号 小红花技术领袖俱乐部公众号二维码
视频号 小红花技术领袖俱乐部视频号二维码