作者冯若航以一人公司维护开源数据库发行版Pigsty,并借助AI Agent接手MinIO社区分支Silo等多个项目,证明一人可完成百人级软件工程。他提出“AI工程管理学”:人只负责判断、品味与验收,执行交给并行Agent,依靠订阅制低价算力、文档驱动设计、对抗式编码与饱和测试。企业提效仅约两成,原因在于沟通成本与激励结构;个人应积累数据、环境与声誉,信任仍需时间建立。
仓颉生态包含五个可嵌入数据库(KV、文档、缓存、时序、图),它们共用 badger-cj 这一 LSM 存储基础,其余四个只负责数据模型。核心观点是:在 KV 之上构建数据库,差异主要体现在 key 的排列方式——storm 将表、字段、值编入 key 以实现二级索引;sunku 用类型前缀兼容 Redis 五种类型;tsdb 用定长补零使字节序等同于时间序;holt 将谓词编入 key 实现邻接索引。可嵌入的代价是单写者和无 SQL,但换来零网络、零部署。
文章认为AI工作平台将取代传统企业软件:前端统一为万能Harness,后端直连数据库,中间层应用退化为薄封装。业务复杂度不会消失,而是下沉数据库、上浮为规则或结晶为插件。数据库仍是企业级核心,垂直Agent壁垒薄弱。后软件时代商业模式只剩咨询,卖的是判断力与确定性兜底。
该页面为Percona博客的文章列表,仅列出三篇文章标题:glibc变更对PostgreSQL集群的破坏、使用DBTrail与Percona Server实现MySQL快速HTAP报表、在Percona Operator中执行PostgreSQL大版本升级,无实质正文内容。
ClickHouse收购Xata并推出托管PostgreSQL服务,与Databricks收购Neon、Snowflake收购Crunchy Data一样,反映分析平台巨头争相收购PostgreSQL公司。作者认为PostgreSQL已成为数据库默认选项,竞争转向发行版与人才,类似Linux生态;PG内核属社区无法被收购,但托管服务商正迅速减少。作者主张做“元发行版”,专注扩展仓库与开源监控底座,保持生态开放。
文章指出,PostgreSQL已主导数据库领域,Databricks收购Neon、Snowflake收购Crunchy Data、ClickHouse收购Xata等收购潮随之兴起。作者认为数据库格局已定,Postgres如Linux般成为默认选择,AI代理时代的赢家将是PostgreSQL与SQLite。由于内核归社区所有、无法被收购,竞争转向发行版与人才,下一阶段将是“发行版之战”。
Sentry团队借助可访问自身追踪数据的编码代理,发现并修复了若干后端小问题,合计每周减少数亿次查询。Android SDK 8.51.0起,Android 15+设备的性能分析改由Perfetto通过ProfilingManager API驱动,无需额外配置。SDK v11引入软导航Web Vitals,使用户访问的每个页面都拥有独立的LCP、CLS和INP指标。
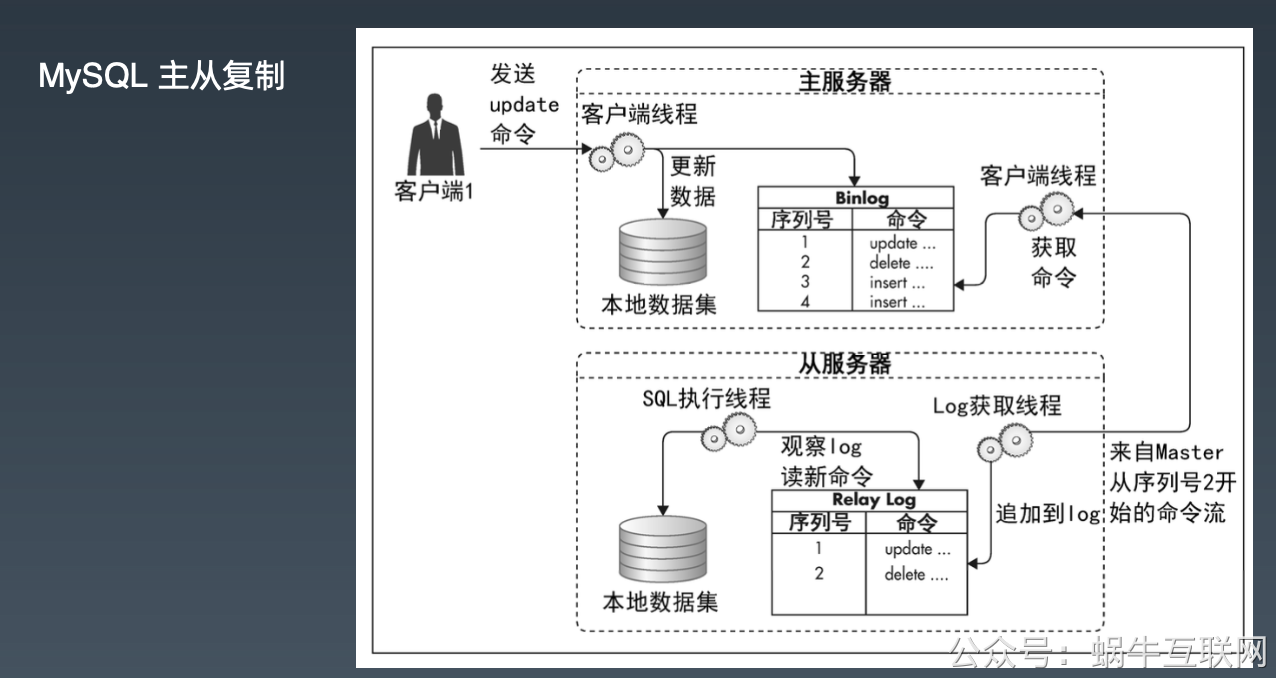
文章介绍分布式数据库架构:MySQL主从/主主复制可分摊读负载、提高可用性,但不增加写并发与存储能力,主主复制不能并发写,修改表结构易导致同步延迟。数据分片需额外代码,跨分片查询和事务难以实现。CAP原理指网络分区下一致性与可用性只能二选一。文中还涉及Cobar中间件、扩容部署、最终一致性冲突处理、HBase与Zookeeper,以及ACID与BASE的对比。
文章介绍Google推出的AlloyDB Express:保留AlloyDB完整内核与AI能力,但移除高可用、备份等生产容灾功能,实现2秒建库、闲置15分钟算力归零、规格封顶,并支持一键原地升级为标准版。作者认为它填补了本地Docker与重型生产数据库之间的空白,适合大企业用于分支隔离、CI测试、AI试错和Agent沙盒,兼顾降本与合规。
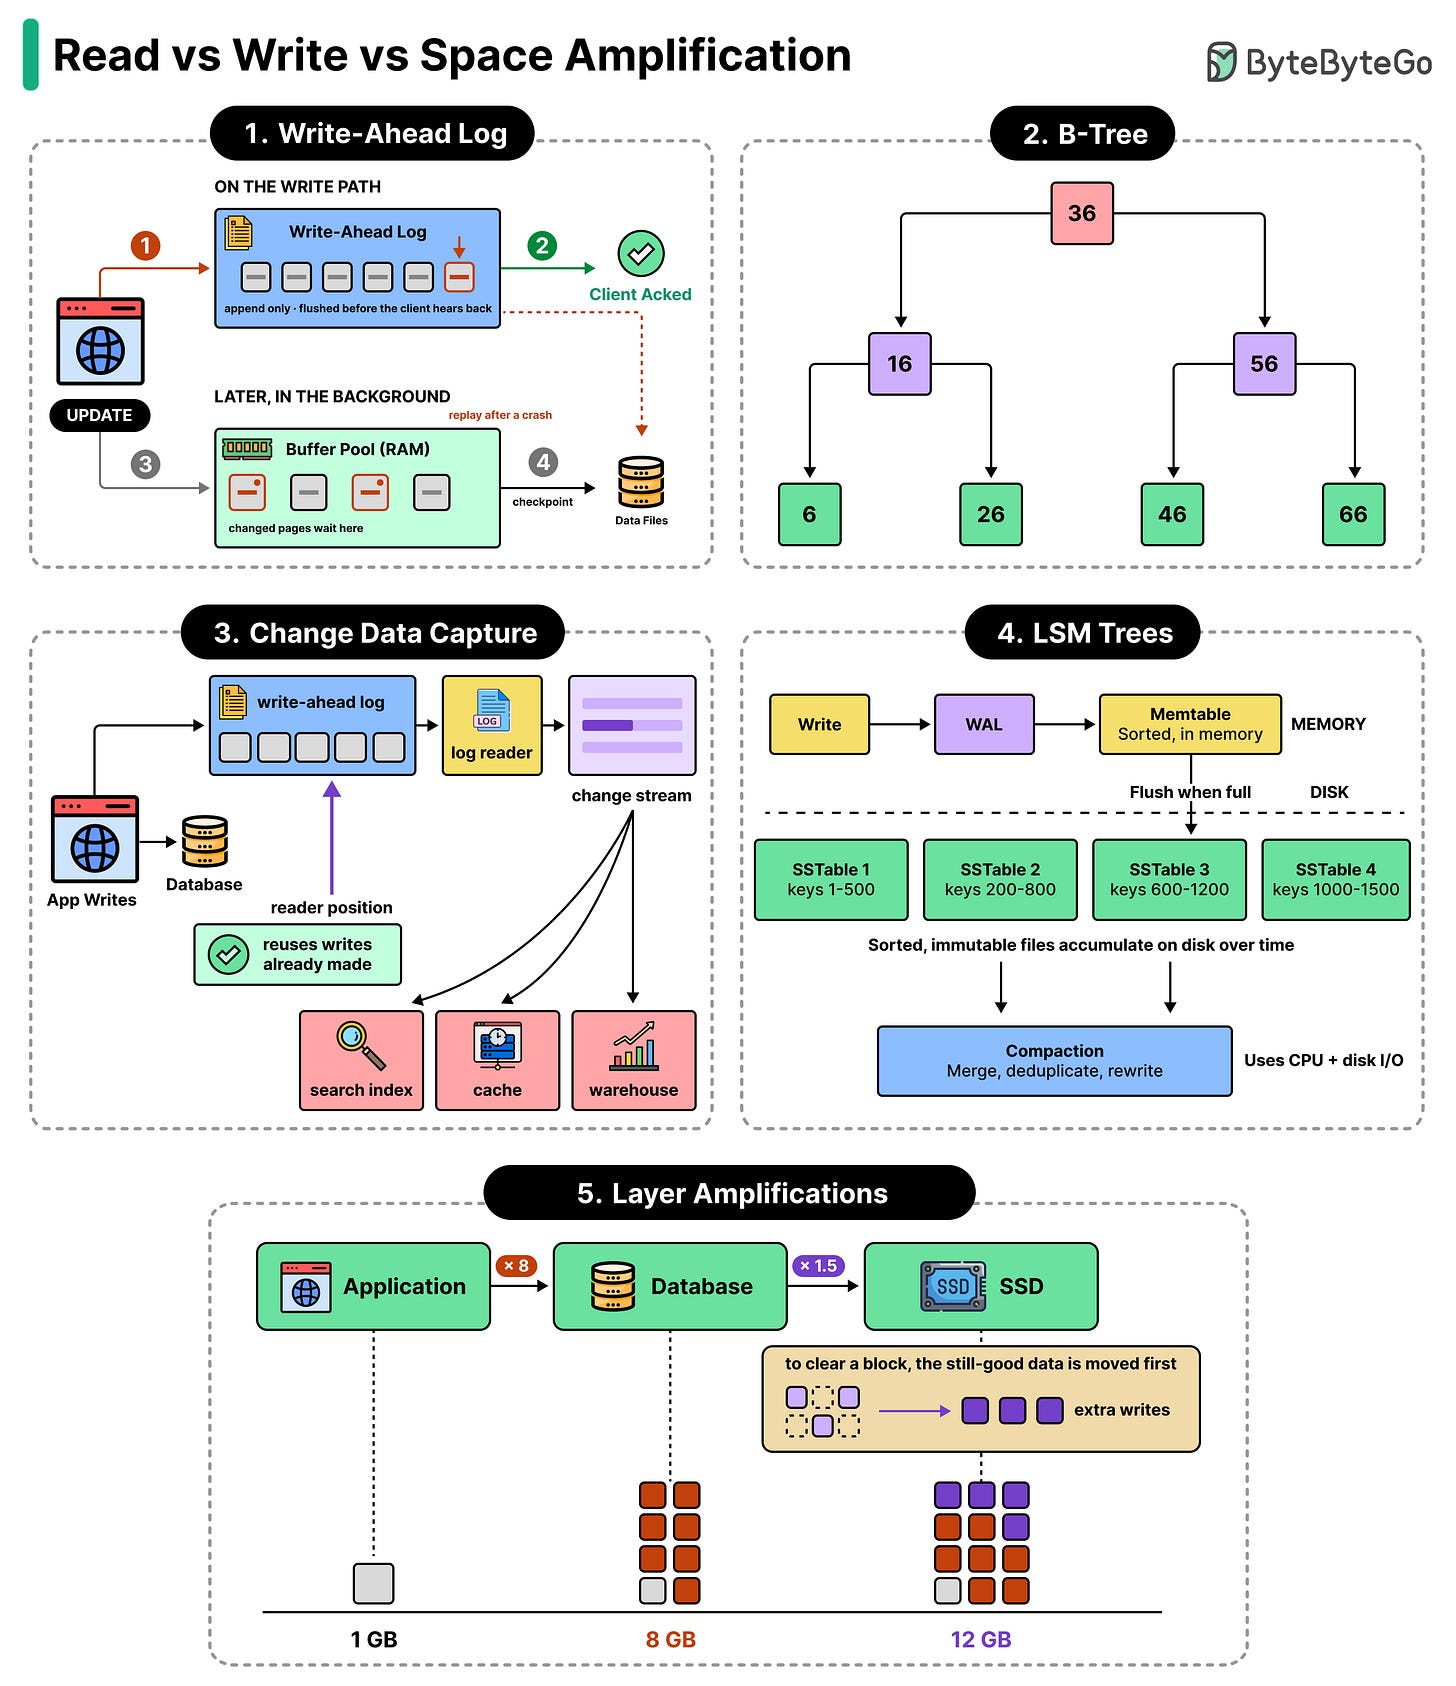
文章讨论数据库请求背后的隐藏开销:存储系统除处理用户请求外,还需额外工作以快速查找数据、支持崩溃恢复和并发事务,由此产生读放大、写放大和空间放大。文章比较B树与LSM树在放大上的差异,并分析索引、过滤器、压缩和缓存对这些开销的影响。
DataGrip 2026.3 发布,默认集成 JetBrains Air,可在聊天中通过 AI 代理运行 SQL 并查看数据。新增数据库输出窗口,优化工具窗口栏与快捷键,支持跨数据源查询,引入基于 DuckDB 的 Workspace 数据源并完整支持 DuckDB。数据编辑器新增在标签页打开结果、查看原始 SQL、固定列、自动调整列宽及管理列弹窗。改进事务控制,新增 MariaDB 序列和包支持,并支持 PostgreSQL 19。
TimescaleDB 推出面向读取路径优化的自适应整数压缩(AIC)。传统 Delta 编码适用于时间序列整数,但实际表常含状态码、外键和交错来源的小批量数据,查询前需先解压。AIC 按数据块选择编码,且仅从解压速度快的编码中挑选,以兼顾压缩率与读取性能。
本文介绍用 Node.js 连接 MongoDB 的步骤:安装 Node.js 和 MongoDB 驱动,创建 Atlas 免费集群并加载示例数据,获取连接字符串;再用 MongoClient 连接集群,编写 main() 函数列出数据库名称,最后运行脚本查看结果。
文章介绍 MySQL 分库分表与读写分离。分表用于分散单表数据,分库用于分散实例负载;可通过客户端或代理中间件路由,按范围或哈希分片。迁移宜采用双写加历史回填,按版本号防止覆盖,校验后切换。扩容宜预建逻辑分片,仅迁移物理位置。全局 ID 可用号段、UUID 或雪花算法。读写分离将写请求送主库、读请求送从库,需应对复制延迟,关键读走主库或等待 GTID。
freeCodeCamp 发布 1.5 小时免费课程,讲解向量数据库原理与实战:从向量、余弦相似度和欧氏距离等数学基础讲起,介绍分词与嵌入模型,演示用 Gemini 生成嵌入并用 PCA 可视化;随后讲解向量数据库的存储、索引与查询,以及 IVF 和 HNSW 如何避免暴力搜索;最后用 ChromaDB 实现语义搜索项目。
JetBrains第三次DataGrip及数据库工具用户体验调查共有1420人参与,受访者多为资深开发者,PostgreSQL使用最广。整体满意度为84.7%,略低于前两届,主要原因是仅使用内置工具的用户增多且其满意度较低。性能与易用性评分偏低,模式内省和功能可发现性最受关注。61%的受访者使用AI功能,但AI满意度仅41.6%,准确性、模式理解和成本是主要改进方向。
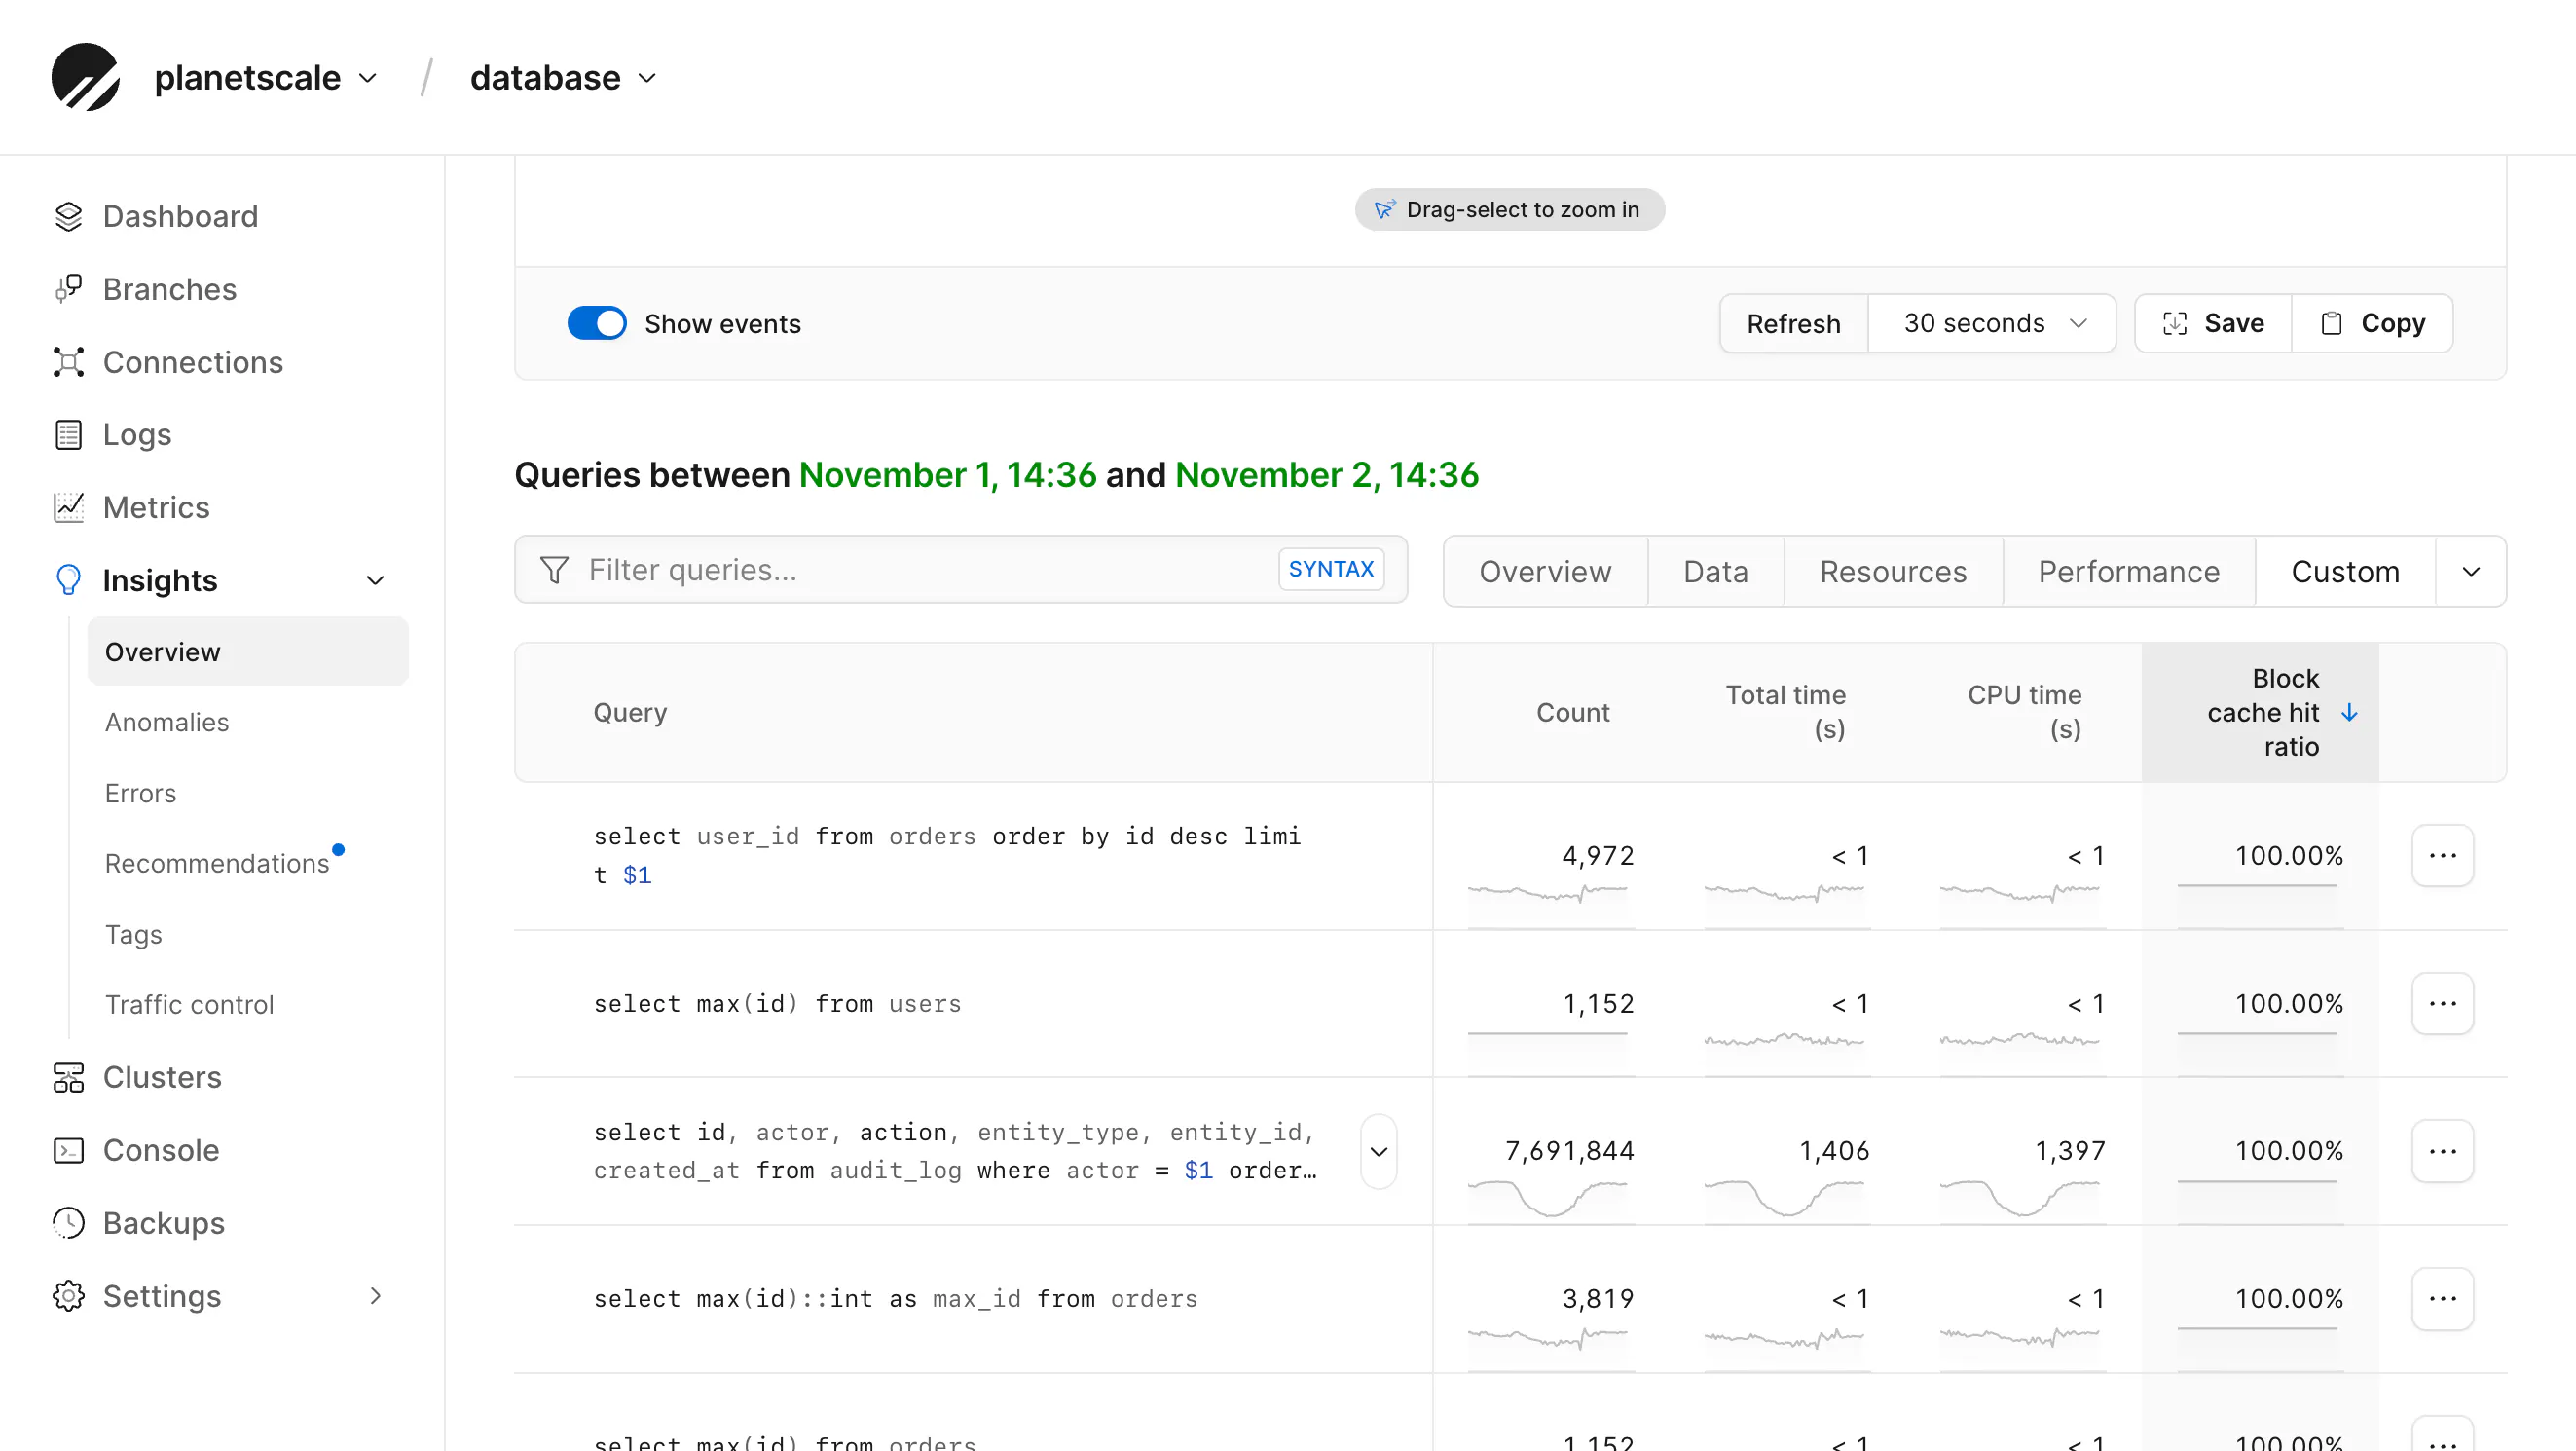
云数据库通常采用网络附加存储(如AWS EBS),存储与计算分离,每次读写都需经过网络,带来隐藏延迟;SSD普及后网络延迟成为主要瓶颈。PlanetScale Metal改用本地NVMe磁盘,消除存储与计算间的网络跳转,并通过主库加至少两个跨可用区副本、提交需副本确认来保证持久性。本地磁盘无IOPS上限且成本更低,适合缓存未命中多或受IOPS限制的工作负载;若读数据能放入内存,网络存储仍够用。
Snorkel AI 借助 Databricks 的 Lakebase(无服务器 Postgres)解决 CI 测试需要真实数据的问题。Lakebase 支持写时复制分支,创建分支仅需秒级且不复制数据。Snorkel 通过 DMS 将生产 Aurora 数据持续同步到主分支,每个 PR 自动创建独立分支运行测试,合并后删除并设 TTL 兜底。分支存储仅随改动增长,计算空闲时缩容,成本较低。该模式也适用于 AI 代理:每个任务一个分支,可安全读写、审查或丢弃改动。
MoteDB 是纯 Rust 编写的嵌入式多模态数据库,面向具身智能,支持向量、全文、时序、空间索引及 SQL 与 ACID 事务。v0.16.0 经 28 轮系统排查修复 42 个缺陷,重点解决静默错误,包括向量列合并后数据损坏、未知列被静默忽略、中文全文检索恒空、同义写法结果不一致等。四层 API 端到端验证通过,性能无回归,并公开已知限制。
P99 CONF 2026 的五场演讲探讨了数据库存储中的权衡:LSM 树在读写放大之间取舍,并适配对象存储;ScyllaDB 的 Logstor 以更大的内存索引换取单次磁盘读取;Valkey 用无锁队列提升 I/O 线程吞吐并改进分片迁移;turbopuffer 用分层聚类与量化压缩支撑千亿级向量检索;TigerBeetle 自建对象存储客户端以提升性能。核心结论是:优化一处瓶颈往往会带来新的成本。
完成下面两步后,将自动完成登录并继续当前操作。