ImageFacade 是 .NET 图像处理抽象库,统一 SkiaSharp、OpenCvSharp、ImageSharp 和纯托管软后端,切换后端只需改一行代码。后端不支持的功能直接抛异常,避免隐式回退。纯托管后端零原生依赖、支持 NativeAOT、输出确定,编解码性能接近或超过 C 库。但项目仅创建 4 天、单作者、API 未冻结,适合原型和内部工具,生产使用建议观望。
文章介绍Spring源码分析入门:Spring使用Gradle构建,依赖存储方式类似pom;建议基于源码加注释分析,IDE反编译效果差别不大。内容涵盖初始化应用上下文、注解与XML路径配置方式、类扫描解析;指出对象不一定是Spring bean,bean必受生命周期管理;GenericBeanDefinition是bean描述对象,扫描到的类置入map;对比FactoryBean与普通Bean,FactoryBean为空壳仅作转发;并提及@PostConstruct在实例化后执行、@lookup解决循环依赖等阅读技巧。
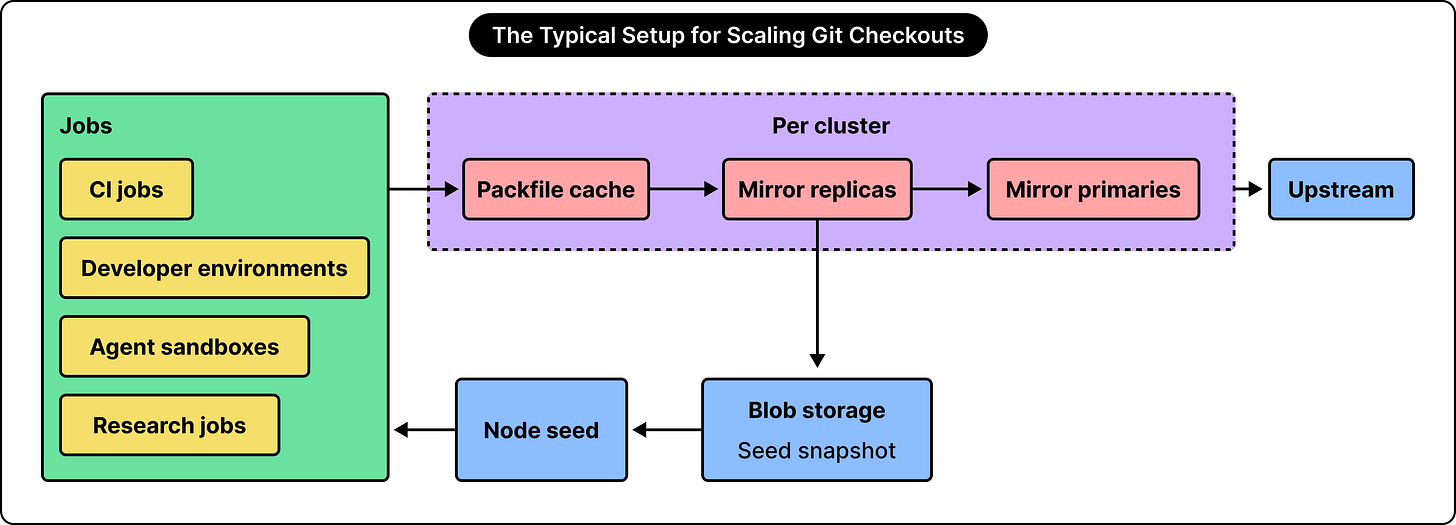
Anthropic因AI生成代码激增导致Git基础设施不堪重负,遂自研源码控制系统Scion。Scion采用客户端-服务器架构,由服务器集中处理历史查询、差异计算与提交,客户端仅缓存所需对象。变更以changeset记录,元数据存于Spanner,文件内容存于云存储。系统利用内容寻址实现不可变对象与多级共享缓存,大幅减少重复传输与计算,支撑每日数万次合并与数千万次检出。
SmartHaus 是一个基于 .NET 10 的开源智能家居项目,约 3.6 万行代码,可接入 KNX 总线、热泵、光伏、摄像头等真实设备。其核心设计是设备事件输入、AI 命令输出:SmartHaus 将住宅封装为 69 个 MCP 工具,大模型代理交由外部运行时负责,便于替换。亮点包括 Redis 领导选举、报文去重、写操作 dryRun 校验、百叶窗行程跟踪,以及面向模型的工具描述与报错指引。项目仍属早期 PoC,需要真实硬件,组地址命名遵循自有规范。
文章剖析 OpenShell v0.1.5 的 supervisor 源码,指出其安全设计核心是一份“不信任清单”:不信任对端连接(单向 TLS 加 JWT 三重校验)、不信任进程自报身份(靠内核 /proc 账本倒查)、不信任加密流量(TLS 终结并严格解析 HTTP)、不信任沙箱内凭证(占位符内容指纹与三层 fail-closed)、不信任恢复者(SIGSTOP 冻结、仅原实例可解冻)。整体贯彻能验证绝不相信、用结构隔离、默认失败即关闭的原则。
前面几篇讲的都是"系统怎么运转",这篇讲"能力怎么长出来"。 Octop 里给 Agent 加本事有三条路:技能、知识库、插件。三者的代码量差不多(3,337 / 2,325 / 4,089 行),但重量级差了三个数量级——最轻的那个只要往目录里放个 Markdown 文件就生效了,最重的那个是进程内加载的 Python 代码。 这个分层不是随便划的,它直接决定了"你想加的东西该放哪"。
第 1 篇画链路的时候,画到这一行就收住了: async for ev in project_stream(agent_manager, agent_id, request, ...): yield ev 当时我说「project_stream 是这里的分界线:往里是 harness 的地盘,往外是 Octop 的地盘」。这篇把它拆开。 顺带把...
第 5 篇写 _start_agent 的时候,第 ⑦ 步我写的是「_post_start_agent:注入 gateway 工具、清洗 MCP 工具名、同步技能」,一句就过去了。 其实那一步里藏着整个项目我最喜欢的一部分:9 个中间件。 它们合计不到 900 行,每个都很小,但每一个都对应一个具体的、真实发生过的问题。
读源码有个顺序问题:先读哪块? 我原来的顺序是先读运行时(第 5 篇),结果一路都在猜 repos 是什么。这篇回头补地基。 infra/db/ 8,854 行,是后端第五大模块。但读完发现它的结构比预想的清楚——难的不是设计,是兼容。
第 1 篇写启动链的时候,有个分叉我没敢展开: if should_defer_control_plane_db(config, self.paths): self._started = True self._emit_wizard_password(user_count=0) return OctopServer.start() 跑到这里就 return...
前几篇一直在往上走:进程怎么起、Agent 怎么活、谁能碰谁的数据。这篇横向切一刀,读 infra/gateway/——13,857 行,第二大模块,负责所有消息的进出口。 打开 ws_channel.py 的第一行,我笑了: """Virtual IM channel that delivers Dashboard chat over WebSocket.""" Dashboard...
前面读了启动链路和 Agent 运行时,这篇读隔离。 之所以单独拎出来,是因为"多用户"这三个字在自托管项目里最容易含混:有的项目是"多用户登录",有的是"多租户隔离",两者差着十万八千里。 看 README 看不出来,只能读代码。 读完之后我的判断是:Octop 属于前者,而且它自己知道。
上一篇只摊了地图,这篇开始钻。按重要性,第一个要读的是 infra/agents/manager.py——4187 行,是整个后端最大的单个文件。 我原以为它会很复杂,读完发现职责其实很清楚,就四件事:启动、注册、执行、回收。复杂的是每一件事背后的并发问题。
上一篇把 Octop 装起来跑通了,这一篇换个方向:不碰功能,只读代码。 我读源码有个习惯,第一篇绝对不抠实现。先干三件事——它到底自己写了什么、代码重量压在哪、一次启动按什么顺序把东西搭起来。这三件事不清楚,后面看任何一个模块都会飘。
Pi Agent 1.0 通过 MCP 工具按需发现、Codemode 脚本编排和提示词压缩来降低上下文开销:MCP 工具默认不预先声明,模型可用 searchTools 或 tool_search 按需加载;脚本在 QuickJS 沙箱中调用工具,仅将筛选后的结果返回模型;提示词合并重复说明并复用工具 schema,官方称约减少 40%。同时修复了 OAuth 权限合并、多账号隔离和会话恢复工具丢失问题。
Java SPI是JVM层面的服务注册发现机制。使用时需在META-INF/services目录下创建以接口全限定名命名的文件,写入实现类名,客户端通过ServiceLoader加载。JDBC、Dubbo等框架广泛使用。其设计依赖接口而非实现,灵活可插拔。
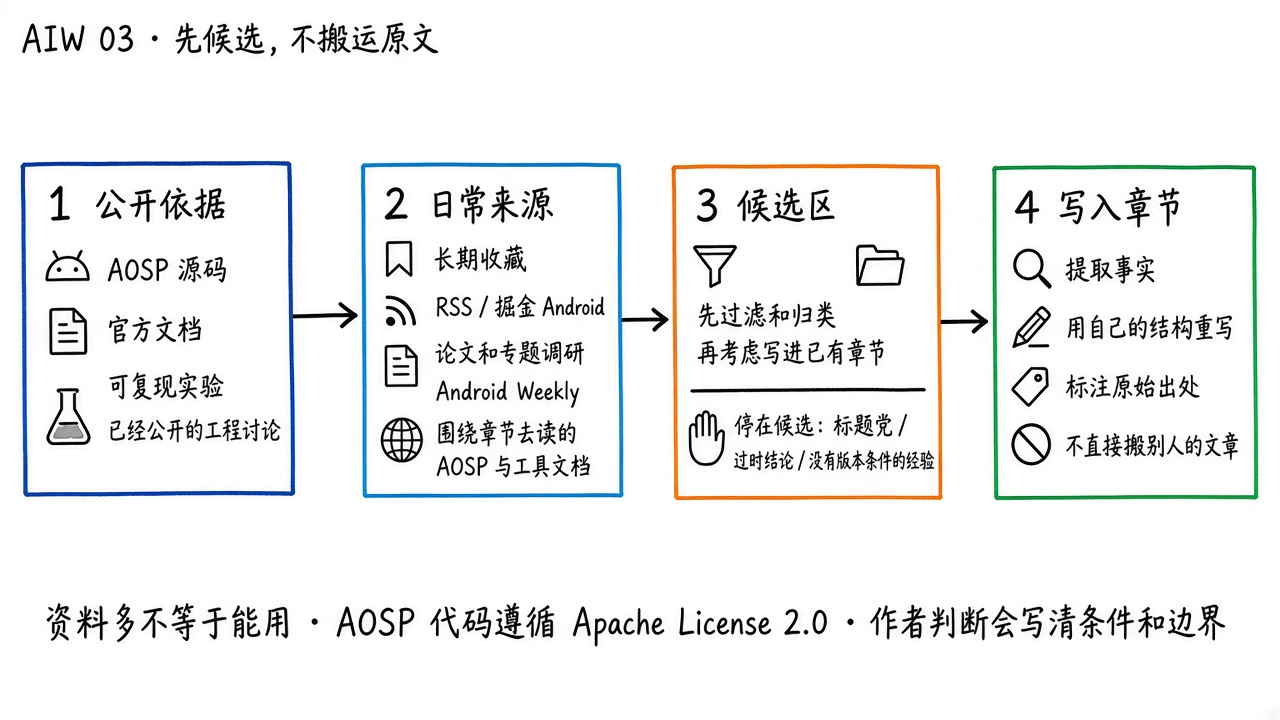
《Android 技术内幕》(AIW)是一本针对 Android 17 系统机制的开源书,共五部分二十六章,涵盖运行机制、性能优化、分析工具、厂商差异与应用实践。每章围绕机制为何存在、如何运行、如何观测及适用条件展开,面向应用、系统与性能工程师。仓库提供正文、目录与每周 EPUB,目前仍为 alpha 版本,欢迎提交 issue 纠错。
本系列从源码角度解析 KubeRay 与 Volcano。先介绍 Ray、Kubernetes、KubeRay 与 Volcano 的职责与架构;KubeRay 部分涵盖组件分工、Reconcile 协调、并发管理、Operator 重启恢复与高可用;Volcano 部分涵盖 Job、PodGroup、Queue 架构、Gang 调度、队列资源竞争与抢占,以及 KubeRay 接入和生命周期协作;最后总结 Operator 设计。
本文解析 Pi Agent 源码:先介绍调试环境搭建(安装依赖、下载模型目录、配置密钥、VS Code 断点),再重点讲解双层主循环——内层处理工具调用与 steering,外层处理 follow-up;通过 StreamFn 依赖注入解耦 Agent Core 与模型供应商,流式事件经归并更新状态,工具调用先校验后执行,结果回填上下文以触发下一轮请求。
本文介绍 .NET 的 FirstChanceException 机制:异常抛出瞬间即触发,即使被 catch 吞掉也能感知。以开源项目 OpenClaw.NET 为例,其工具执行、MCP 调用、记忆召回、LLM 重试等失败均被降级为字符串或警告,导致 Agent 变笨却无日志。挂上该事件可观测被吞异常,但只能记录不能拦截,需防递归与性能开销。
完成下面两步后,将自动完成登录并继续当前操作。