该文研究语言模型对齐的理论极限,推导固定KL预算下最大期望奖励增益的闭式解,发现其由Jeffreys散度而非√KL决定,并提出仅凭基座模型样本预测增益的实用估计。在代理奖励下,奖励误差越大、KL惩罚越小,奖励黑客越严重,奖励集成可缓解。实验显示best-of-N接近理论极限,PPO与GRPO明显次优。
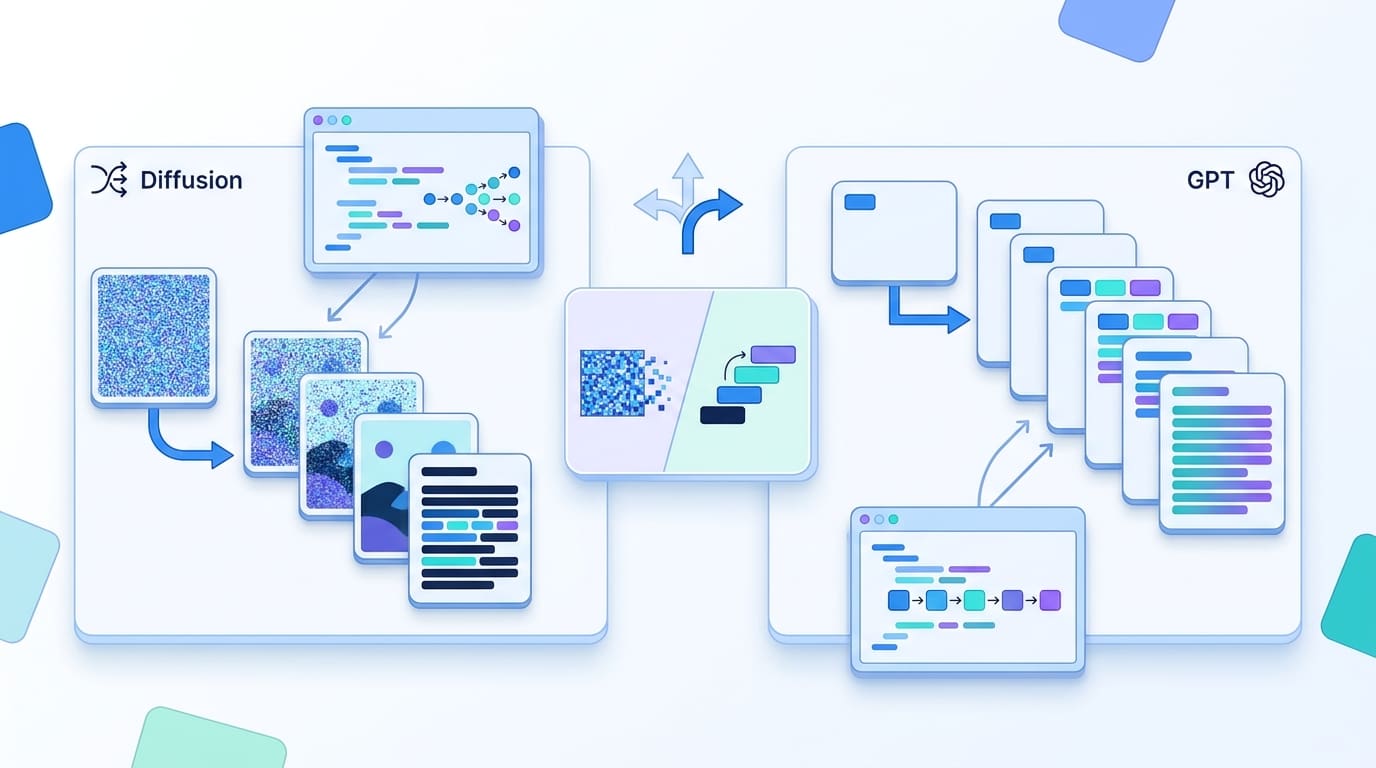
扩散语言模型通过迭代去噪、逐步填补被遮蔽的词元生成文本,而非像GPT那样逐词生成;它采用双向注意力,可并行预测多个位置,推理更快,适合填空和编辑,但仍面临词元依赖、采样预算、输出长度和KV缓存等挑战。作者认为扩散并非取代GPT,而是另一种计算分配方式,混合方法或更适合实际部署。
本地语言模型指权重下载到自有硬件运行、无需联网或账号的模型,优势是隐私、无按量费用、可离线、行为稳定。文章强调“最佳”取决于任务而非榜单:MMLU测知识、HumanEval测编程、MT-Bench测对话。推荐七款模型:Phi-4-mini适合低配硬件;Gemma 4 E2B/E4B擅长写作与多模态;Qwen2.5-7B及Coder版强于编程和多语言;Qwen3.5-9B适合智能体工具调用,也是通用首选;Mistral 7B写作清晰;Llama 3.1 8B微调生态最大;nomic-embed-text用于本地RAG检索。均可用Ollama一键下载。
Apple 论文从零预训练 140M 至 1.3B 参数的循环语言模型,实测发现 halting head 按平均迭代数报告的省算力被系统性高估:预测均值 3.7 次迭代,实际运行 7.6 至 7.9 次,几乎不省算力。改用逐步打分后 token 约停 3 次,但 32 序列批次需等最慢 token,实付 4.4 至 4.7 次,领先从 0.0246 塌缩至 0.003 BPB。论文建议改报预测均值、实跑步数、批次实付三个数。
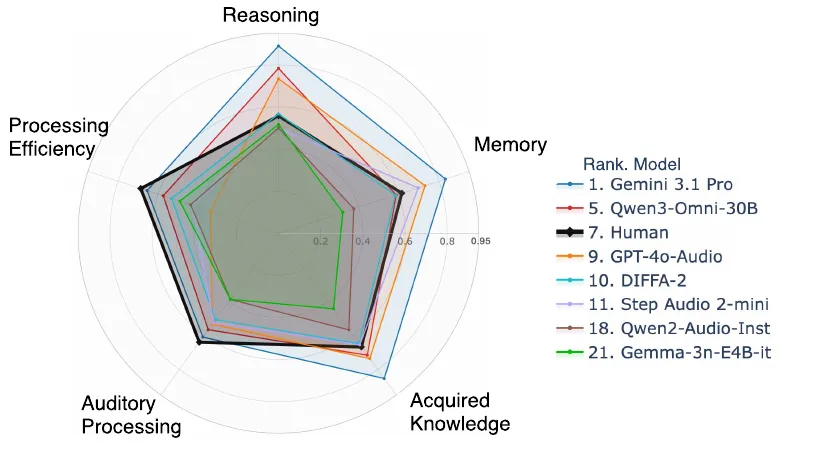
RAIL借鉴CHC认知框架,将音频评测重构为听觉处理、推理、记忆、知识、处理效率五类能力、32项细分任务,构建5306条样本。评估26款音频大模型发现:模型善用语义线索但精细声学感知弱;语音记忆强而非语音记忆普遍不足60%;多步顺序推理易出错;推理预算利用效率差异明显。研究主张按能力维度定位短板,推动音频模型在感知、记忆与效率上改进。
2026年,Mistral、IBM、Intuit、Adobe、Vendr等六家公司围绕“用语言模型从非结构化文档抽取结构化字段”获得专利授权,技术路线趋于一致:先用规则、版式或分类器定位,仅将命中片段输入模型,再进行字段级校验。Mistral与Vendr授权速度异常快,表明权利要求空间已清晰。这提示工程界:整页输入模型的方式已落后,先定位后抽取成为共识,工具层竞争激烈。
2026年2至8月,Mistral、IBM、Intuit、Adobe、Vendr等六家公司围绕“用语言模型从非结构化文档抽取结构化字段”获得授权专利,技术路线高度一致:先用规则、版式或分类器定位,仅将命中片段送入模型,再做字段级校验,而非整页输入。Intuit、IBM、Vendr分别侧重邻域文本、提示词定位和校验流程。Mistral的入局表明模型厂商正布局流程层。先定位后抽取已成工程共识,工具层竞争激烈,授权速度可作为跟踪信号。
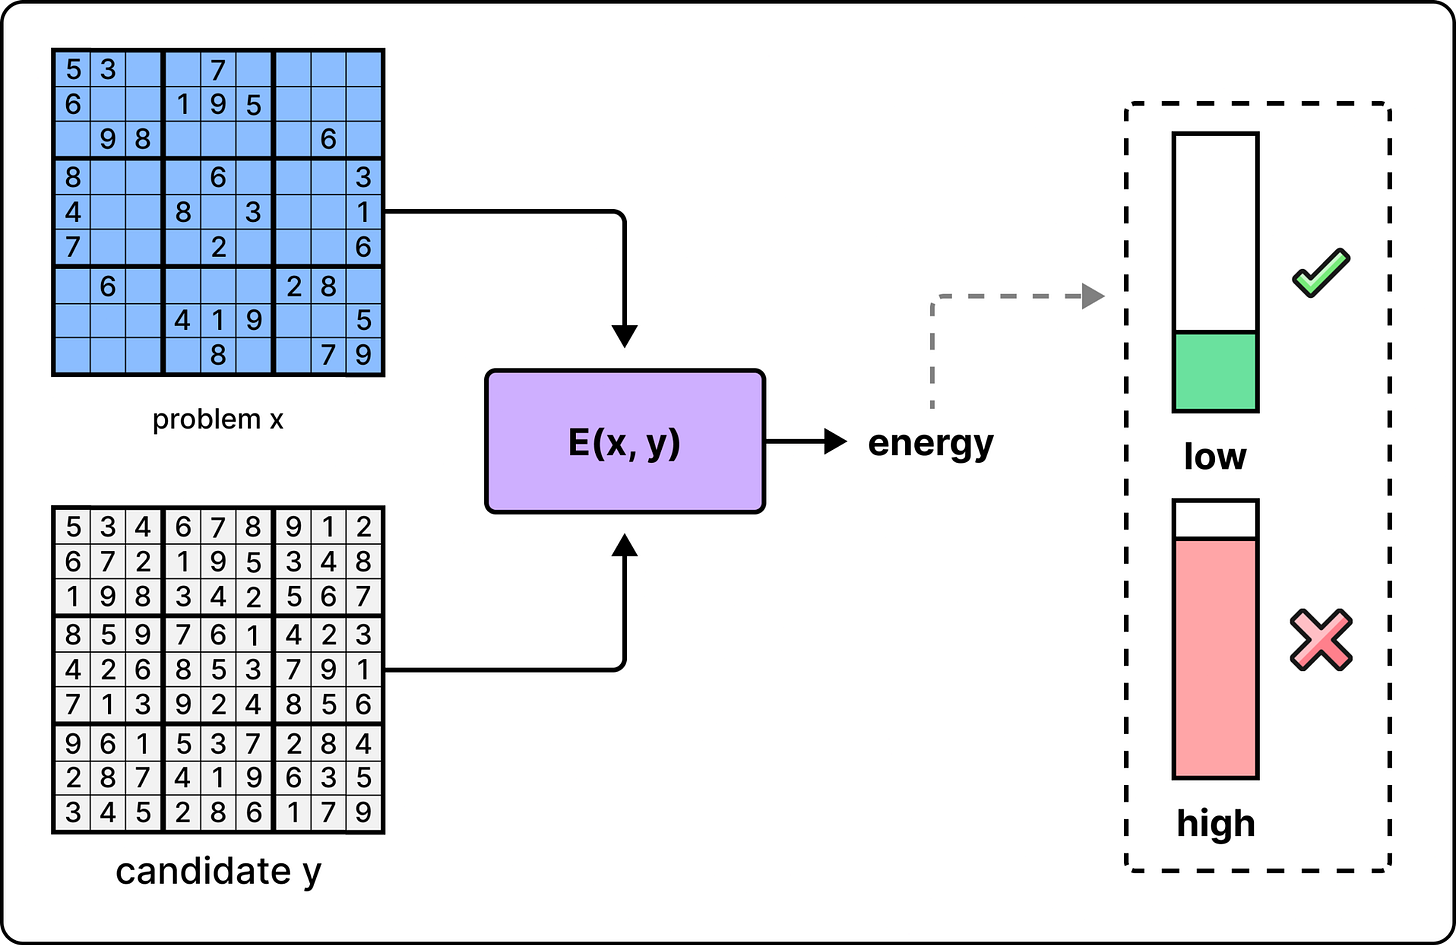
大语言模型在数独等约束满足问题上表现不佳,因其从左到右逐词生成且输出离散,难以同时满足多重约束。Logical Intelligence提出能量基推理模型(EBRM),如Kona,用连续隐空间推理,通过能量函数评估候选答案并沿梯度下降搜索,模型仅数千万参数,速度快、成本低。EBRM适合规则明确、可验证的任务,语言模型则负责判断与表达,二者分工互补。
论文提出SELFCOMPACT方法,让语言模型自主决定上下文压缩的时机与方式:模型可调用压缩工具总结累积内容,并依据轻量规则判断触发时机(子任务完成或轨迹收敛)与抑制时机(推导中或卡住)。在六个基准、七个模型上,该方法以更低token成本达到或超过固定间隔摘要,数学任务最高提升18.1分,智能搜索提升5–9分,成本降低30–70%。
freeCodeCamp发布教程,讲解如何在普通CPU上本地构建、预训练并微调一个2500万参数的语言模型。课程涵盖现代LLM架构(混合注意力、专家混合、绑定嵌入、多模态输入)、从零预训练学习Python语法,以及通过强化学习后训练,让模型以单元测试通过率为奖励,成功率从0%提升至多数通过。
Ollama 简化了本地语言模型运行,但需确保模型与上下文能装入内存。`ollama ps` 可查看模型占用及 GPU/CPU 分配,低于 100% GPU 表示部分已转 CPU,生成变慢。macOS 桌面应用需通过 `launchctl setenv` 设置环境变量,否则配置无效。传入 JSON schema 可约束结构化输出,而 "json" 仅保证合法 JSON。速查表还涵盖磁盘管理、API 端点、Modelfile 及环境变量。
研究测试语言模型通过自然语言传递树状表达式时的信息损耗:一模型生成应用题,另一模型提取表达式,以符号等价判定。结果显示通道有损且不对称,角色互换后准确率差达60.4个百分点;至少73.6%的失败源于生成端,难度取决于树结构;约3600条微调样本即可提升所有开源模型。
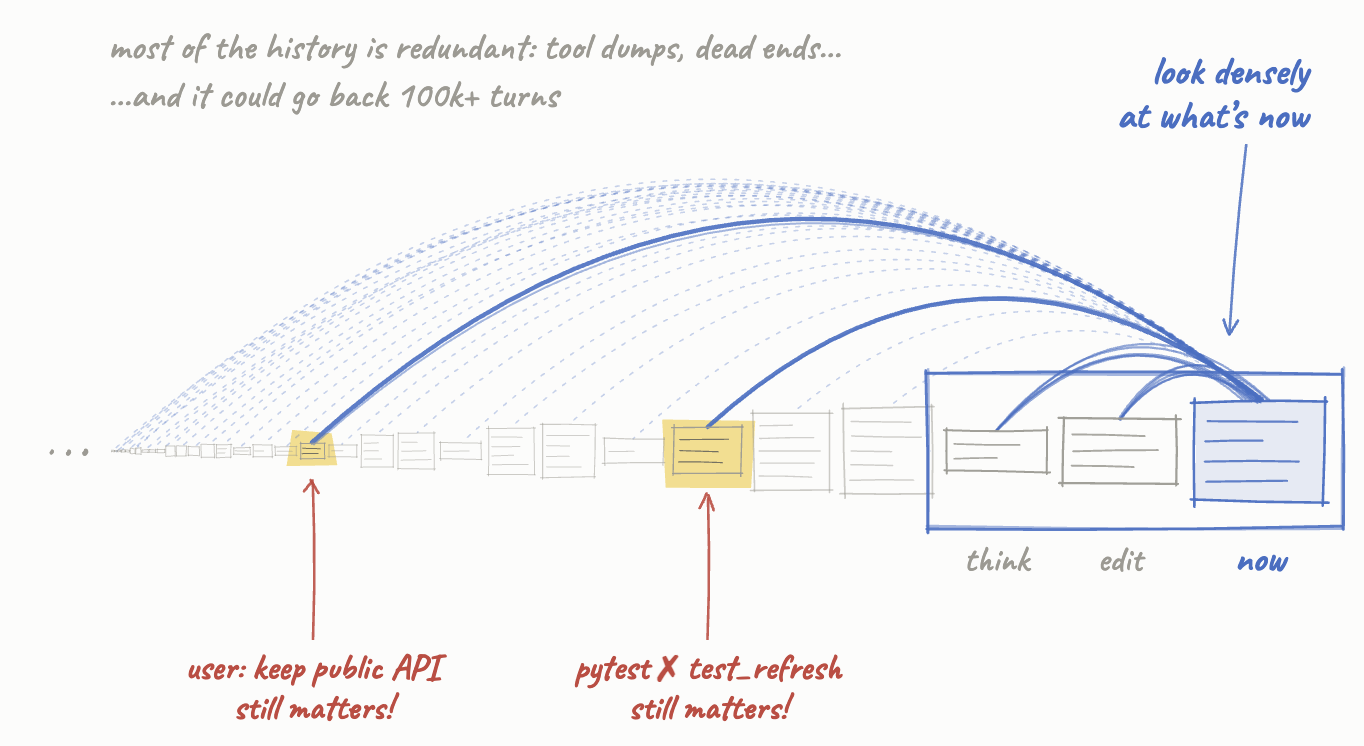
本文主张跳出仅修改harness适配模型的思路,探索改变语言模型的输入输出形态。作者认为decoder-only Transformer并非处理智能体轨迹的终极形态,可结合循环模型与Transformer,分别处理历史与当前观测,实现自动压缩与局部密集注意力。Jev等新形态证明替代权衡空间存在,需配套新目标函数。如今蒸馏与开放环境使这类研究更可行。
悉尼大学教授戈弗雷-史密斯以章鱼为例,提出意识的最低门槛是主观视角与大脑弥散性电振荡。大语言模型两条均不达标:无身体、无需求、无自组织脑波,只是重组人类语料的地图。智能不等于意识,AI是拥有超强能力却无任何意识的全新存在类别。
Nathan Barry用gzip做文本续写实验,结果不通顺,但说明预测下一个token与压缩本质相通。作者提醒:gzip不能替代LLM,其能力仅来自局部统计,缺乏推理泛化。工程启发是:许多任务未必需要大模型,可先用压缩率、编辑距离等轻量方法检测异常,再按需升级,避免过度依赖GPU和外部API。
针对扩散语言模型强化学习中去噪步骤同等对待和似然估计偏差问题,提出DACA-GRPO方法,引入去噪进度分数和分层掩码似然两种机制,在三种GRPO基础上于数学推理、代码生成等七项基准测试中取得提升,最高分别提升5.6、7.4、36.3和5.9个百分点。
谷歌与全球研究者和社区合作,将AI应用于疾病防治、自然灾害预测、教育普及和经济机会拓展。AI已从理论研究走向实际应用,能提前预警野火、气旋和洪水,并构建理解全球语言的模型,让更多人共享AI机遇。
语言模型生成的三维场景并非真正的游戏,仅含少量交互元素。目前它们无法创作出具备完整玩法、机制与挑战性的优质游戏,仅能构建基础环境。
Cohere发布文档解析模型Parse(parse-v5.0),为2.3B参数视觉语言模型,可将PDF、PPT等转为带HTML表格和边界框的Markdown。API定价每千页1.5美元,Model Vault月费2500美元起。ParseBench得分79.2为自报子集分数,未含图表和视觉定位维度。专用容量月处理超167万页才划算。
MIT研究人员开发出CrysVCD框架,在材料生成前通过语言模型约束化学价规则,提升生成材料的稳定性,使约70%的生成材料达到高稳定性,并支持特定性能(如高导热、高介电常数)。该方法比事后筛选高效一个数量级,节省计算成本,有望推动半导体和数据中心等领域的材料创新。
完成下面两步后,将自动完成登录并继续当前操作。