COSMA基于通信下界设计并行矩阵乘法。针对计算量增大后数据搬运成为瓶颈、有限内存限制数据复用的问题,利用三维计算空间与红蓝卵石模型推导近最优分块策略:优先保留方形输出块、流式读取输入,并权衡二维与三维划分。实验表明,相比ScaLAPACK等最高加速12.8倍,达到平台峰值性能的88%。
该文章介绍一款在线竖式乘法计算器工具,用户可输入两个乘数,工具会直观展示完整的竖式列式和逐步计算过程,并提供快速示例按钮(如123×45、999×999等)方便测试,同时页面还列出其他相关数学工具链接。
2026年7月,数学与AI论坛在云南玉溪举行,专家探讨AI在数学中的能力边界。AI大模型数学能力跃升,可获奥数满分,但存在可解释性“黑箱”问题。周向宇院士认为数学家不会被取代,应专注创造性工作,AI作助手。北电数智推动算力建设及医疗、制造领域落地。
Furiosa提出了一种新型AI芯片设计,采用Tensor Contraction Processor(TCP),放弃传统的矩阵乘法,直接执行张量收缩。这一设计旨在简化计算过程,减少数据转换和内存管理的开销,提高AI计算效率,标志着AI芯片设计的范式转变。
文章探讨了AI基础设施中的向量、神经网络和深度学习的核心概念。向量将词语转化为数字以计算相似度,点积运算用于衡量向量对齐程度。神经网络通过多层结构重塑输入,激活函数影响学习效果,损失函数定义错误,训练通过梯度下降优化模型参数。文章指出当前模型在处理上下文时的局限性,强调Transformer架构的重要性。
在《v5的诞生》第12集中,开发者发现数据可视化图表存在错误,技能数据被错误标记。经过调查,问题源于数据继承关系。团队决定优化仪表板,增加切片功能,而不编写新代码。同时,他们决定不构建新的深度观察室,因为基础设施即将更新。最终,通过删除一个云连接的功能,增强了系统的安全性和可靠性。
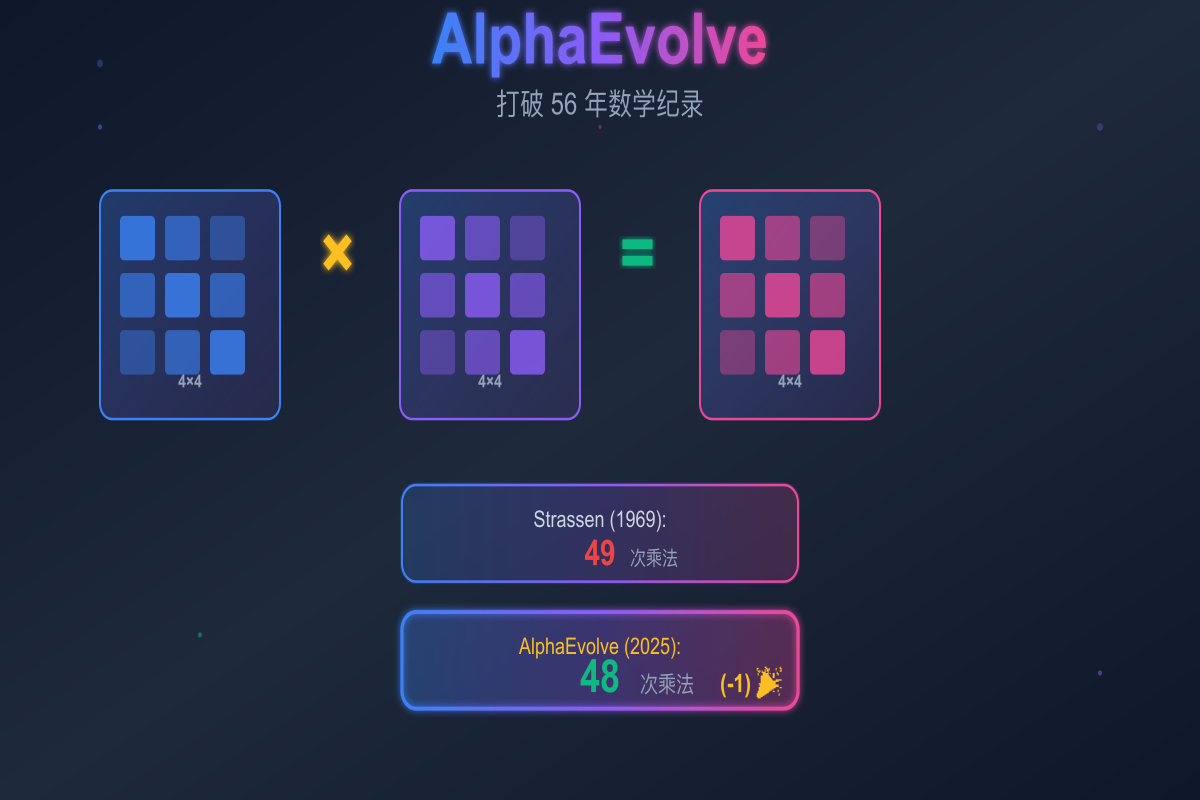
2025年,Google DeepMind的AlphaEvolve以48次标量乘法打破了1969年Strassen的矩阵乘法纪录。它不仅优化了矩阵运算,还解决了67个数学问题,展示了AI在数学领域的原创性和自我改进能力,预示着AI驱动的科学新时代的到来。
本文介绍了在NVIDIA Blackwell上优化矩阵乘法内核的过程,重点在于集群启动控制(CLC)优化。通过使用持久内核和调度器,消除了共享内存和障碍初始化的开销,性能提升15%,达到1772 TFLOPs,超越当前的SOTA。此外,探讨了通过块交换提高L2缓存命中率,从而实现更高效的调度和性能。
本文探讨了在NVIDIA Blackwell GPU上通过2SM技术和流水线优化矩阵乘法性能,达到360.2 TFLOPs,接近85%的最先进水平。采用多播和2xSM MMA优化共享内存,减少数据冗余,并通过流水线技术提升计算与内存传输的重叠,最终实现1429 TFLOPs,达到81%的目标。
本文探讨了Nvidia Blackwell GPU架构下的矩阵乘法优化,采用共享内存和循环分块技术,性能提升超过50倍。通过利用Tensor Memory和新指令集tcgen05.mma,进一步提高计算效率。尽管取得显著进展,但仍未达到cuBLAS的性能水平,后续将继续优化。
本系列博客将展示如何在Nvidia Blackwell GPU上编写高性能矩阵乘法内核,力求达到或超越cuBLAS的性能。第一部分介绍矩阵乘法的重要性及其在大型语言模型中的应用,并用Mojo语言实现简单的矩阵乘法。后续部分将逐步优化内核性能,利用Blackwell的新硬件指令。
乘法和除法指令使用较少,效率低。CMP指令用于比较操作数并设置标志位。乘法分为无符号和有符号,影响CF和OF标志位。除法也分为无符号和有符号,商和余数由隐含和显式操作数决定。逻辑运算指令包括AND、OR、NOT、XOR等,影响标志位。移位指令分为算术、逻辑和循环移位,影响CF和OF标志位。
机器之心数据服务现已上线,提供高效、稳定的数据获取服务,简化数据爬取流程。
香港中文大学提出的新算法RXTX,通过结合机器学习与组合优化,优化矩阵乘法,节省5%-10%的能源和时间,尤其在大规模矩阵运算中表现优越。
谷歌DeepMind与陶哲轩等科学家合作推出AlphaEvolve,提升了矩阵乘法、芯片设计和AI训练的效率,并能解决300年前的几何难题,展现出广泛的应用潜力。
本文介绍了在Triton中实现矩阵乘法的方法,并进行了L2缓存优化。通过矩阵分块和利用快速的SRAM,减少对慢速DRAM的访问,从而显著提高性能。同时,优化L2缓存的使用,确保相邻线程共享数据,进一步提升计算效率。文中还提供了完整的Triton代码示例,以帮助读者理解实现过程。
本研究解决了为大语言模型提供高效计算和能源消耗的特殊硬件架构的需求。我们详细评估了Tenstorrent Grayskull e75 RISC-V加速器在降精度线性代数核心上的性能,并与包括英特尔Sapphire Rapids处理器和两款NVIDIA GPU (V100和A100)在内的先进架构进行了比较。尽管NVIDIA...
我开发了一个简单的计算器,支持乘法和平方根等功能。期待未来的新项目。
该程序用于小学算术测试,包括加法、减法和乘法,适合注意力训练。它可移植,不依赖系统注册表,所有设置保存在INI文件中,支持多种运算类型和范围,测试后提供详细结果。完全免费,无广告或间谍软件。
DeepSeek发布了开源矩阵乘法库DeepGEMM,专为英伟达Hopper GPU设计,支持FP8格式,提升AI训练效率。核心代码仅300行,简单易用,适用于多种AI架构,性能优于专家优化库。开发者可在GitHub获取代码。
完成下面两步后,将自动完成登录并继续当前操作。