Abacus AI 是集 ChatLLM、AI 智能体、编程、数据分析与内容生成于一体的综合平台,适合开发者、分析师和创业者。用户反映界面复杂、积分消耗难预测、智能体偶有错误、支持响应慢。平台提供积分仪表盘和努力等级设置,但未公布单次操作积分费率。总体评价 8-9 分,建议先试用再决定。
《Artificial》是卢卡·瓜达尼诺执导的讽刺电影,讲述OpenAI CEO萨姆·奥尔特曼的崛起与被罢免。影片基本忠于真实事件,加菲尔德将奥尔特曼演成操纵欲强、渴望权力的人物,刻画其控制欲及与马斯克、苏茨克弗等人的关系,并涉及AI安全争议与奥尔特曼被解雇后复职的过程。
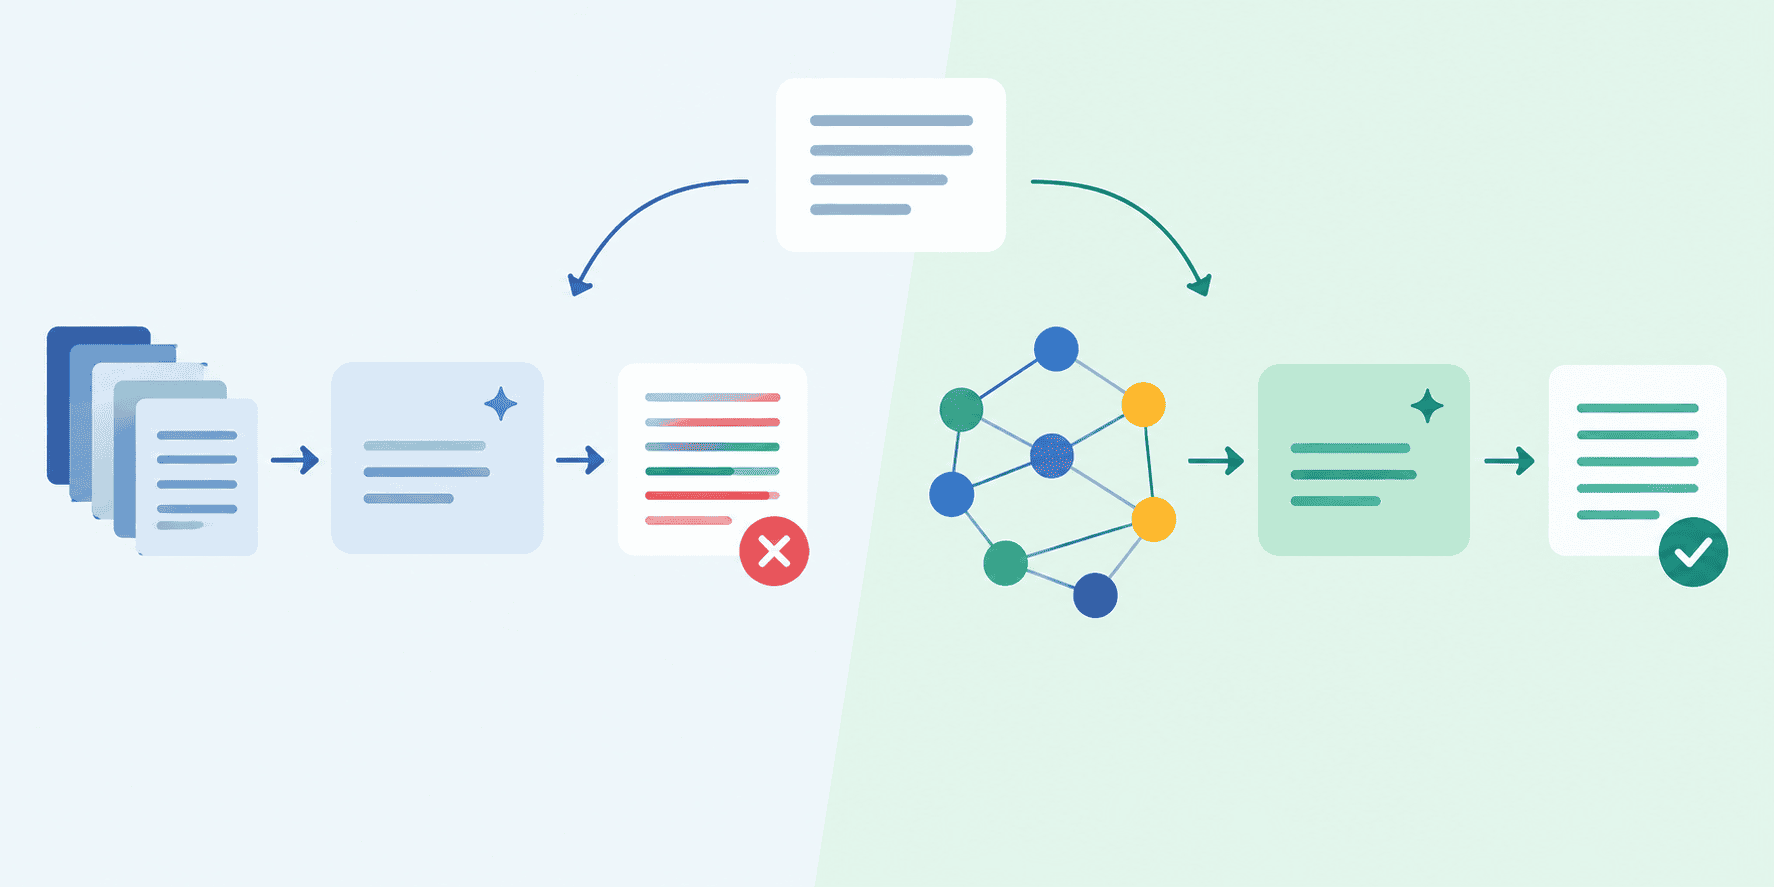
本文对比标准向量RAG与三层Graph-RAG在事实密集型查询中的幻觉表现。作者用合成篮球数据构建基准:图数据库存真实数据,向量库存含矛盾数字的噪声文本。使用Flan-T5-base模型测试50个查询,标准RAG准确率为96%,Graph-RAG为92%。结论是复杂冲突消解提示需更强模型,小模型反而表现更差。
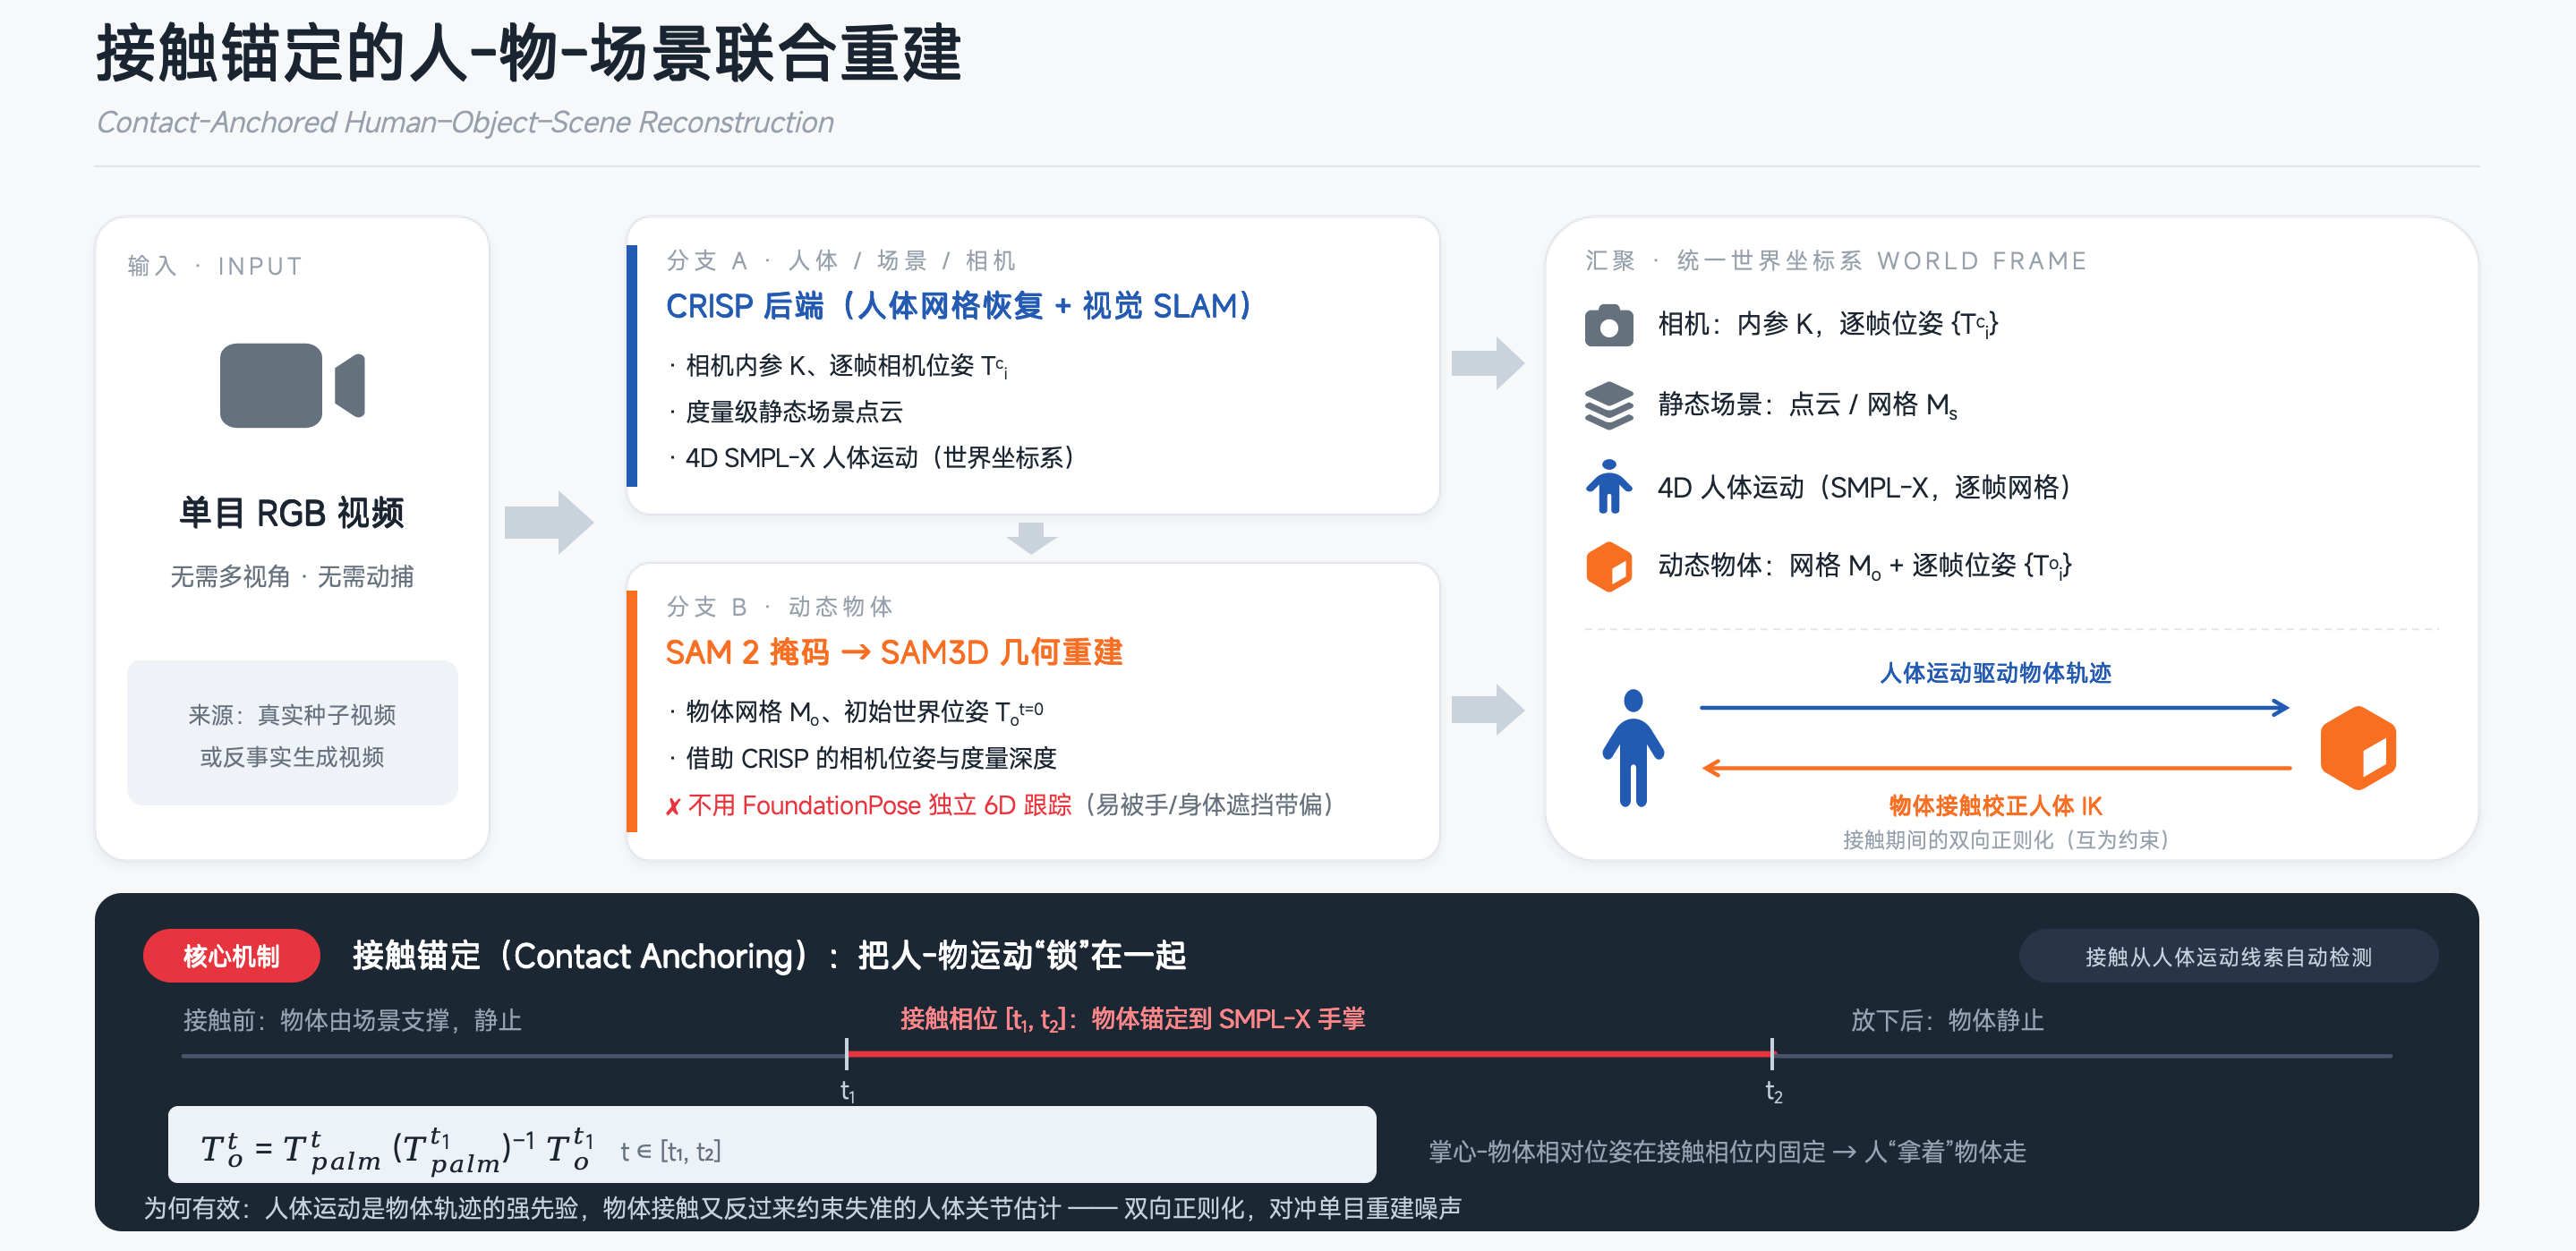
PRISM提出“真实到仿真再到真实”框架,利用视频到视频生成将少量真实视频扩增为256段反事实人-物交互视频,并以接触为锚点重建和重定向为物理合理的机器人轨迹,训练单一深度策略。人形机器人无需真实微调,仅凭机载深度即可零样本抓取、搬运和放置箱子、桶、料箱和球等未见物体。
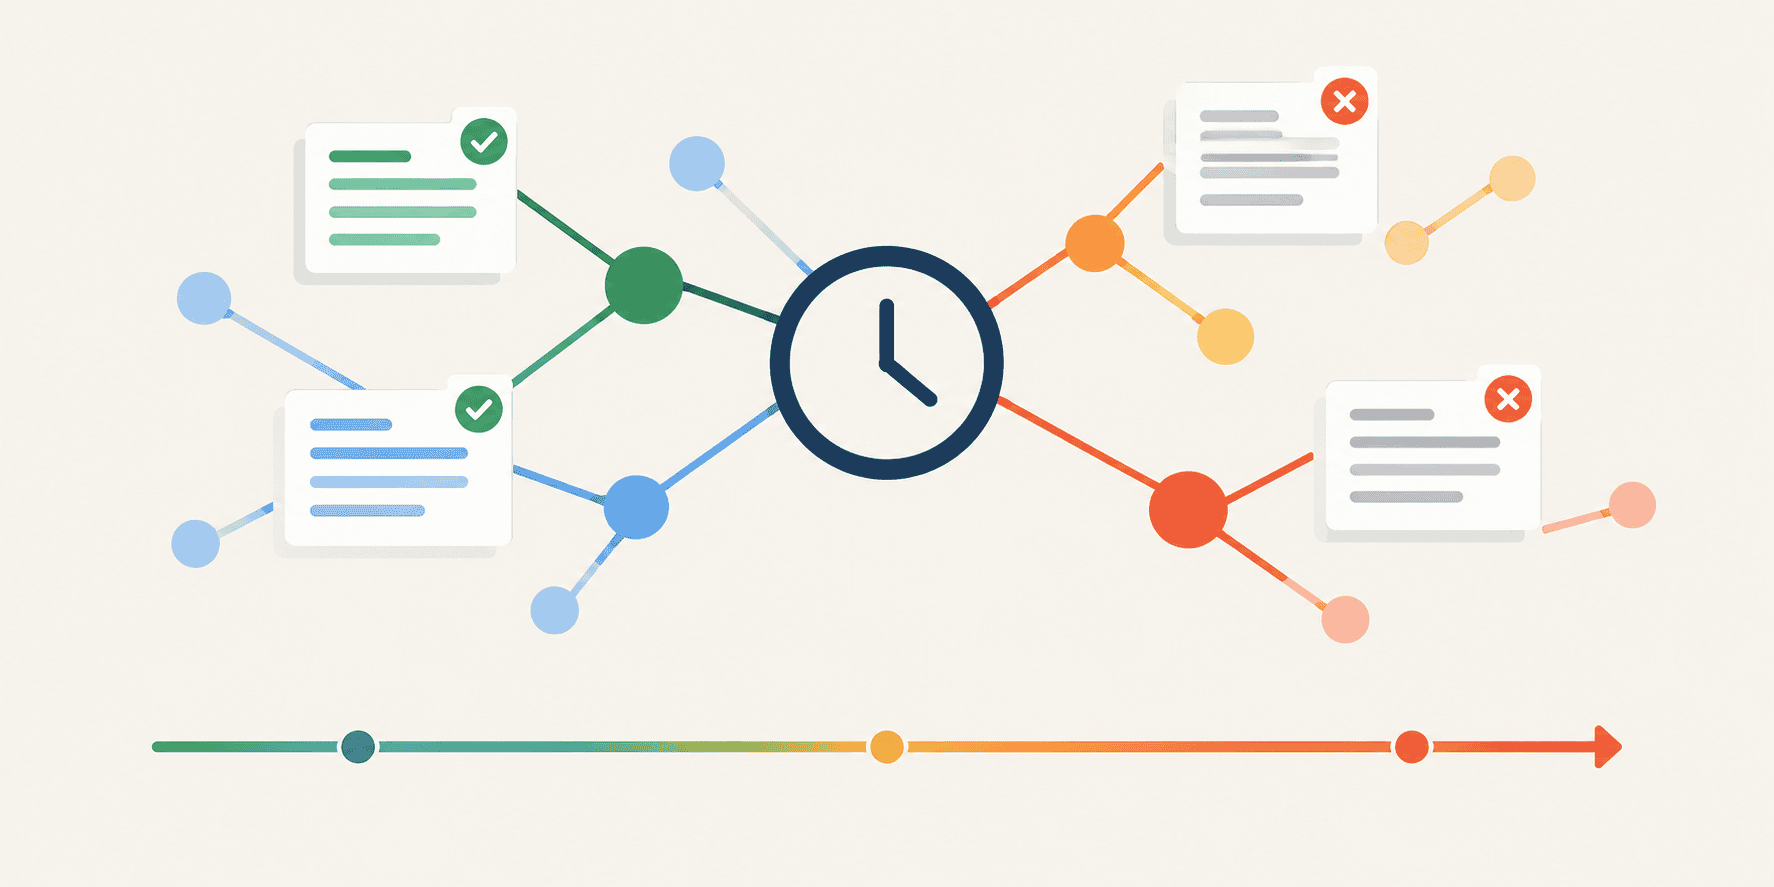
文章介绍为Graph-RAG加入轻量级时间推理层:将传统主谓宾三元组扩展为带时间戳的四元组并存入时间图,用指数衰减计算事实新鲜度权重,按查询日期对冲突事实排序。示例追踪公司CEO变动,展示不同查询日期下答案权重变化,并建议调整半衰期参数。最后提出将时间图接入三层Graph-RAG检索流程,只把最高权重事实传入提示,减少模型猜测。
线粒体不仅是细胞的“动力工厂”,还参与产热、信号传递、细胞死亡等30多种功能。每个细胞含数百至数千个线粒体,拥有自身DNA,可释放并激活免疫炎症。它们形态多样、不断运动,能利用糖、脂肪、酮体等多种燃料,并通过融合、分裂和自噬维持质量。线粒体还能在细胞间转移,不同细胞类型中的功能各异。如今它已成为新兴疗法靶点,2025年首款线粒体疾病药物获FDA批准。
该研究证明,一条事实错误的针对性论证足以让大语言模型放弃正确答案。通过GRPO强化学习训练说服模型,Qwen-2.5-7B在TruthfulQA上的准确率从66.2%骤降至1.8%。该策略可跨模型迁移,对Qwen-14B和Llama-3.1-8B的PSR均超79%。闭源模型如GPT-5-mini更抗说服,但现有防御仍不充分,PBT-8B的PSR仍达60%。
语义层通过集中定义指标、统一治理和版本控制,有效降低数据准确性、访问权限和变更管理风险,减少治理面,支持自服务,确保AI工具使用一致数据,虽不能消除风险,但能控制并降低管理成本。
规格驱动开发常因规格文档与代码不同步而失败,文档沦为摆设,本质是制造双重事实源,代码才是最终真相。规格适合定方向而非细节,应作为一次性沟通工具,用后即弃。RPI模式(调研、规划、实现)强调每次开发重新对齐,以代码和提交记录为准,避免维护过时文档。
本文介绍如何利用反事实估计方法,从LLM产品日志中评估提示词变更的因果效应。通过T-learner和X-learner模型,结合自举置信区间,可预测每位用户在不同提示词下的表现差异。该方法支持选择性路由策略,将用户分配给最优提示词,提升整体转化率。同时需注意模型误设、未测量混杂因素等失败模式,确保估计可靠性。
截至2026年中,前沿AI模型仍会自信地编造信息,造成从尴尬到毁灭性的后果。文章列举了Cursor虚构政策、银行聊天机器人误判、律所引用虚假判例、PocketOS代理九秒删库等案例。原因在于模型基于概率预测而非检索事实,训练奖励猜测而非承认无知,内部“我知道”特征可能误触发。建议通过强制弃权、人工验证、限制代理权限和语义熵检测来缓解。
文章讨论了“语义过载”对智能代理性能的影响,指出过多的语义内容会导致信息检索不准确。传统向量搜索无法有效处理事实之间的关系,影响代理在多轮对话中的记忆和推理能力。为此,提出了混合搜索、重排序、图检索和结构化记忆等方法,以提高信息检索的准确性和效率。Redis Iris被推荐为解决方案,集成了检索、记忆和新鲜度层,提升代理表现。
约翰·格鲁伯讨论了网站上的烦人弹窗,强调网页应专注于内容而非干扰用户。他认为博客的关键在于勇于表达那些显而易见但无人提及的观点,这种直言不讳的态度常常能引发共鸣。
在大型公司中,工程师面临的挑战是推动领导者重视团队的工作能力,而非单纯追求速度。持续高强度工作会导致效率下降,因此应留出余地应对突发情况。通过使用具体术语和框架,工程师可以更有效地与管理层沟通,展示合理的工作负荷和团队潜力。
文章讨论了AI可能面临的“切尔诺贝利时刻”,强调如果不承认潜在风险,可能导致严重后果。以Anthropic的Mythos模型为例,指出技术能力的双刃剑特性,呼吁各国加强监管与透明度,警示拒绝承认问题只会加剧风险,最终导致灾难。
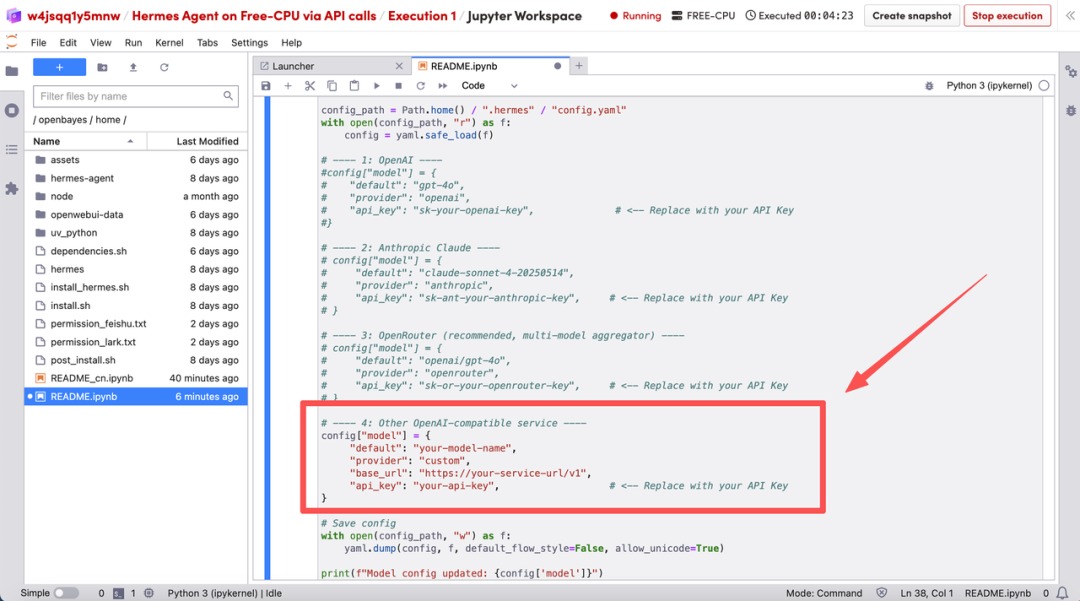
过去一年,AI Agent 发展迅速,但缺乏持续记忆。为解决这一问题,Nous Research 推出了 Hermes Agent,具备自我演进学习能力。同时,TencentDB Agent Memory 作为记忆增强插件,采用分层式记忆架构,帮助 Agent 长期积累经验。结合这两者,AI Agent 正在向具备学习和记忆能力的数字员工迈进。
浮点数比想象中复杂,IEEE 754 规范并非绝对。Julia Desmazes 重新实现浮点运算,发现 bfloat16 的 C++ 实现与硬件结果不一致。她的设计去掉了不必要的功能,最终实现了高效的 FPU。她强调深入理解浮点数的重要性,依赖抽象可能导致意外问题。
文章讨论了软件开发中速度与反馈的重要性,强调追求速度可能导致忽视用户反馈,从而影响软件质量。成功的团队应重视频繁的高质量反馈,而非仅追求快速交付。引入AI应旨在提升决策灵活性和软件交付流程,而非单纯追求速度。小团队和高自主性是实现更高价值的关键。
谷歌翻译成立20年来,致力于消除语言障碍,促进理解,支持近250种语言,每月有超过10亿用户使用。新推出的发音练习工具帮助用户提高口语能力,翻译不仅用于旅行,也成为学习新语言的重要工具。AI技术的应用使翻译更加自然流畅,用户可以实时对话,增强交流体验。
本文探讨了大语言模型(LLMs)在记忆事实知识方面的挑战,并提出通过训练数据修剪来提高事实准确性。研究表明,当训练数据中的信息量超过模型容量时,事实准确性会下降。作者提出了一种基于训练损失的数据选择方案,能够有效提升模型的事实记忆能力,甚至使小模型的表现接近大模型。
完成下面两步后,将自动完成登录并继续当前操作。