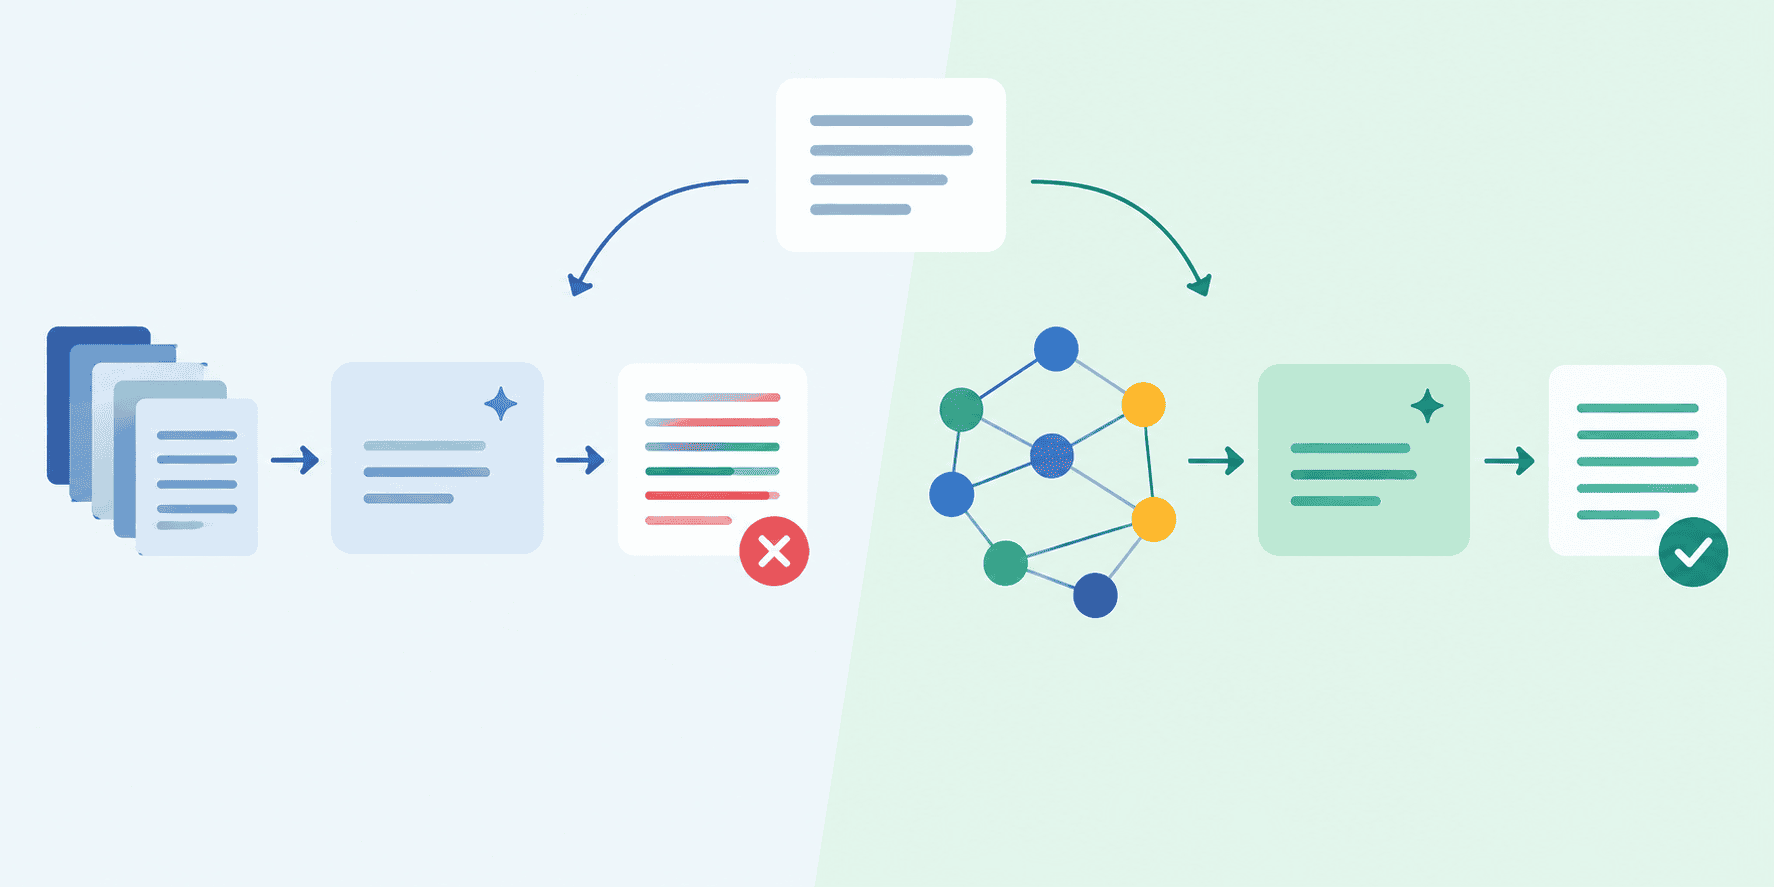

评估Graph-RAG与标准RAG:面向事实密集型查询的幻觉基准测试
内容提要
本文对比标准向量RAG与三层Graph-RAG在事实密集型查询中的幻觉表现。作者用合成篮球数据构建基准:图数据库存真实数据,向量库存含矛盾数字的噪声文本。使用Flan-T5-base模型测试50个查询,标准RAG准确率为96%,Graph-RAG为92%。结论是复杂冲突消解提示需更强模型,小模型反而表现更差。
延伸解读
小模型难以驾驭复杂提示
实验使用仅2.5亿参数的Flan-T5-base模型,在标准RAG的简单阅读理解任务中表现良好,但面对Graph-RAG要求优先使用图事实的复杂冲突消解提示时,准确率反而下降。这表明小模型在遵循多步指令和冲突消解上能力不足,提示复杂度需与模型容量匹配。
基准设计的启示
该基准通过合成篮球数据,在图数据库中存储真实值,在向量数据库中注入含矛盾数字的噪声文本,模拟了现实RAG系统常遇到的上下文污染。这种设计能有效测试系统在事实密集型查询中的抗干扰能力,但合成数据与真实场景的差距仍需注意。
生产环境选型建议
若采用Graph-RAG等需要复杂规则提示的架构,应搭配更大规模的推理模型(如Llama 3或GPT-4),否则可能因模型能力不足导致性能下降。标准向量RAG在简单查询上可能更高效,但面对冲突数据时需评估是否引入图结构及相应模型升级。
Q&A
Graph-RAG和标准RAG在事实密集型查询上的准确率对比结果是什么?
在50个查询的基准测试中,标准向量RAG准确率为96%,3-Tiered Graph-RAG准确率为92%。
这个基准测试是如何构建数据集的?
作者合成了50名篮球运动员的数据:图数据库存储真实的赛季场均得分,向量数据库存储包含矛盾数字(如半场得分、生涯平均)的噪声文本。
为什么Graph-RAG在这个测试中表现不如标准RAG?
因为Graph-RAG使用了复杂的冲突消解提示,而测试用的Flan-T5-base模型较小(250M参数),难以遵循复杂指令,导致准确率下降。
这个基准测试使用了哪些工具和模型?
使用了ChromaDB作为向量数据库,Hugging Face的transformers库加载google/flan-t5-base模型,并自定义了SimpleQuadStore作为图数据库。
标准RAG和Graph-RAG的检索函数在实现上有什么不同?
标准RAG从向量库检索前3个相似文本块,拼接后让模型回答;Graph-RAG优先从图数据库获取事实,并将向量库结果作为后备,提示中强制模型使用图事实。
这个实验对生产环境中的RAG系统设计有什么启示?
提示复杂度和模型能力必须匹配。复杂的冲突消解提示需要更大的推理模型(如Llama 3或GPT-4),在轻量本地模型上强行使用可能反而降低性能。
