第二部分:将评估作为部署门禁——以及如何识别其漂移
内容提要
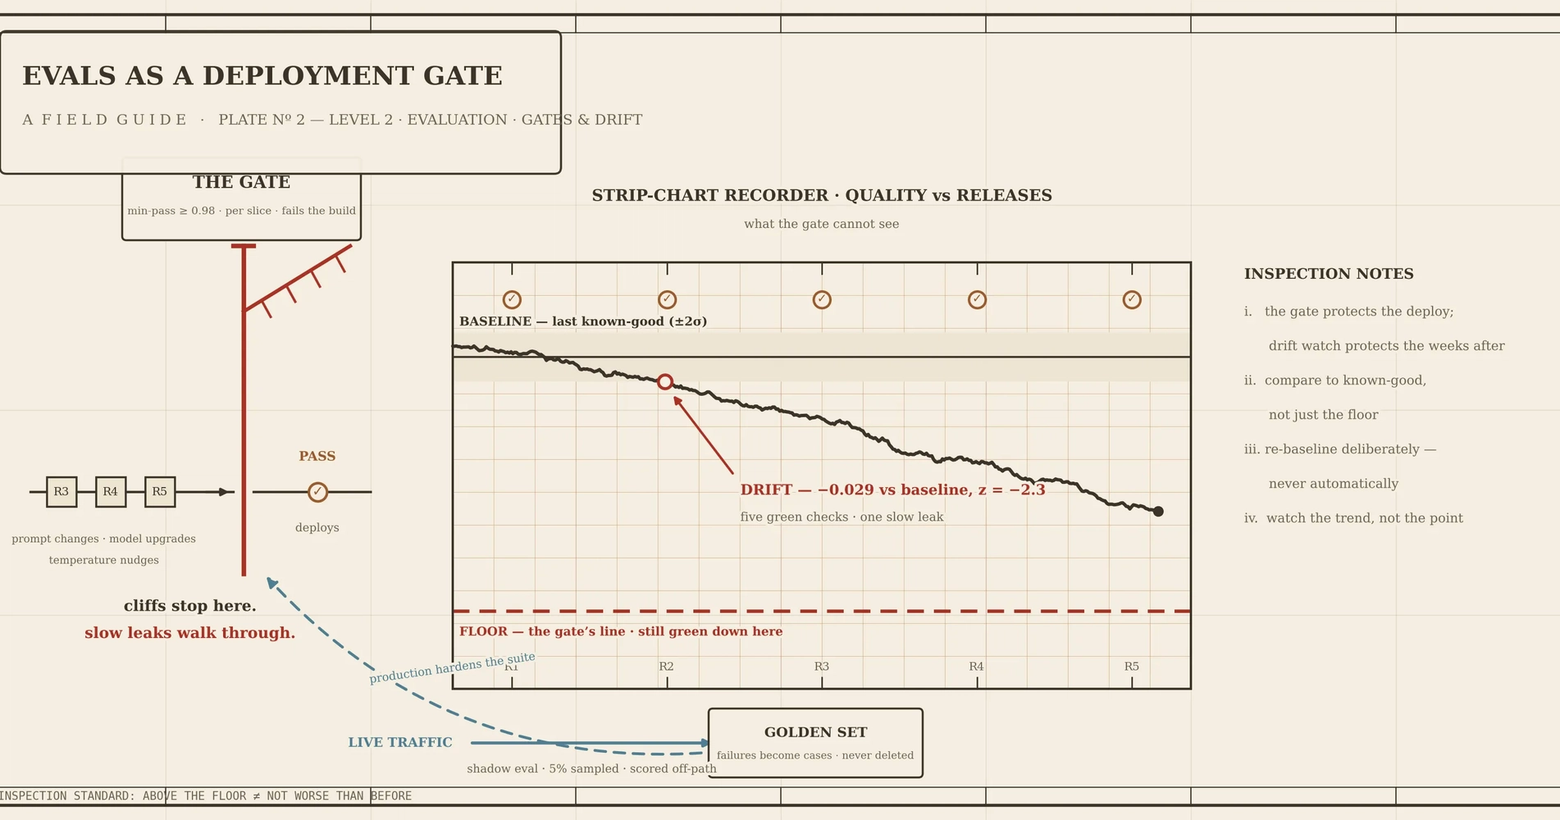
主张将LLM评估作为CI部署门禁,用版本化黄金用例、显式评分器和按切片路由在构建时拦截回归。门禁只能发现骤降,无法捕捉缓慢漂移,因此需对照已知良好基线做显著性检验,并对线上流量抽样做影子评估,监控人工覆盖率和置信度趋势,将失败案例回补进黄金集。
延伸解读
门禁与漂移检测:两种不同的防护机制
文章强调,部署门禁和漂移检测解决的是不同时间尺度的问题。门禁在部署时刻拦截骤降,而漂移检测在部署后的数周内捕捉缓慢退化。两者需要不同的工具:门禁依赖版本化的黄金用例和显式评分器,漂移检测则依赖与已知良好基线的显著性比较。只做门禁会漏掉慢速泄漏,只做漂移检测则无法在部署前阻止明显回归。
基线比较中的常见统计错误
文章指出,许多团队在比较当前指标与基线时,错误地只用基线的标准差除以基线样本量的平方根,而忽略了当前运行自身的样本量和方差。这会导致在样本量较小时(如50条线上决策对比2400条基线)将纯噪声误判为漂移。正确的做法是使用两比例z检验(针对比率指标)或均值差的标准误(针对连续指标),并同时考虑两次运行的样本量。
影子评估:用生产流量持续加固黄金集
黄金集是有限且人工策划的,而生产流量是无限且充满意外的。影子评估对线上真实输入进行抽样(如5%),在旁路对实际决策评分,并跟踪通过率趋势。失败案例会被加入审查队列,成为新的黄金用例。文章建议使用决策ID的确定性哈希而非随机数进行抽样,以保证可复现性并避免测试不稳定。
早期预警信号与应对原则
文章列出几个需要关注趋势而非单点的预警信号:人工覆盖率上升、置信度分布偏移、评判模型分歧率上升、弃权率上升。当信号触发时,不应自动回滚,而应确认其真实性(显著且约2σ)、定位到具体切片或能力、查找原因(模型更新、提示变更或输入偏移),然后通过正常变更流程修复,并在验证后重新建立基线。
Q&A
如何将LLM评估设置为CI部署门禁?
将评估作为CI门禁,需要版本化黄金用例、显式评分器和按切片路由。在CI中运行评估命令,当通过率或关键指标低于阈值时失败构建,从而在部署前拦截回归。
为什么评估门禁无法捕捉缓慢漂移?
门禁只能发现骤降(如通过率突然低于阈值),而缓慢漂移是每次发布小幅下降,每步都太小无法触发门禁,导致质量逐渐恶化。
如何检测LLM系统的缓慢漂移?
需要对照已知良好基线做显著性检验,并对线上流量抽样做影子评估,监控人工覆盖率和置信度趋势,将失败案例回补进黄金集。
什么是影子评估?如何实施?
影子评估是对线上流量抽样(如5%),用规则或评判模型对实际决策进行评分,并跟踪通过率。使用确定性哈希采样,失败案例加入审查队列作为新黄金用例。
如何设置基线并进行显著性检验?
捕获上次已知良好发布的指标作为基线,每次运行与基线比较。使用双比例z检验或均值差标准误,结合最小效应量和约2σ判断是否显著漂移。
评估中常见的反模式有哪些?
常见反模式包括:评估只在笔记本中运行、断言模型置信度而非正确性、删除已修复的bug用例、使用单一全局通过率、仅基于下限门禁、在评估路径中使用随机采样、自动重新基线化、只看点不看趋势。
