第三部分:让智能体知道自己不知道:置信层
内容提要
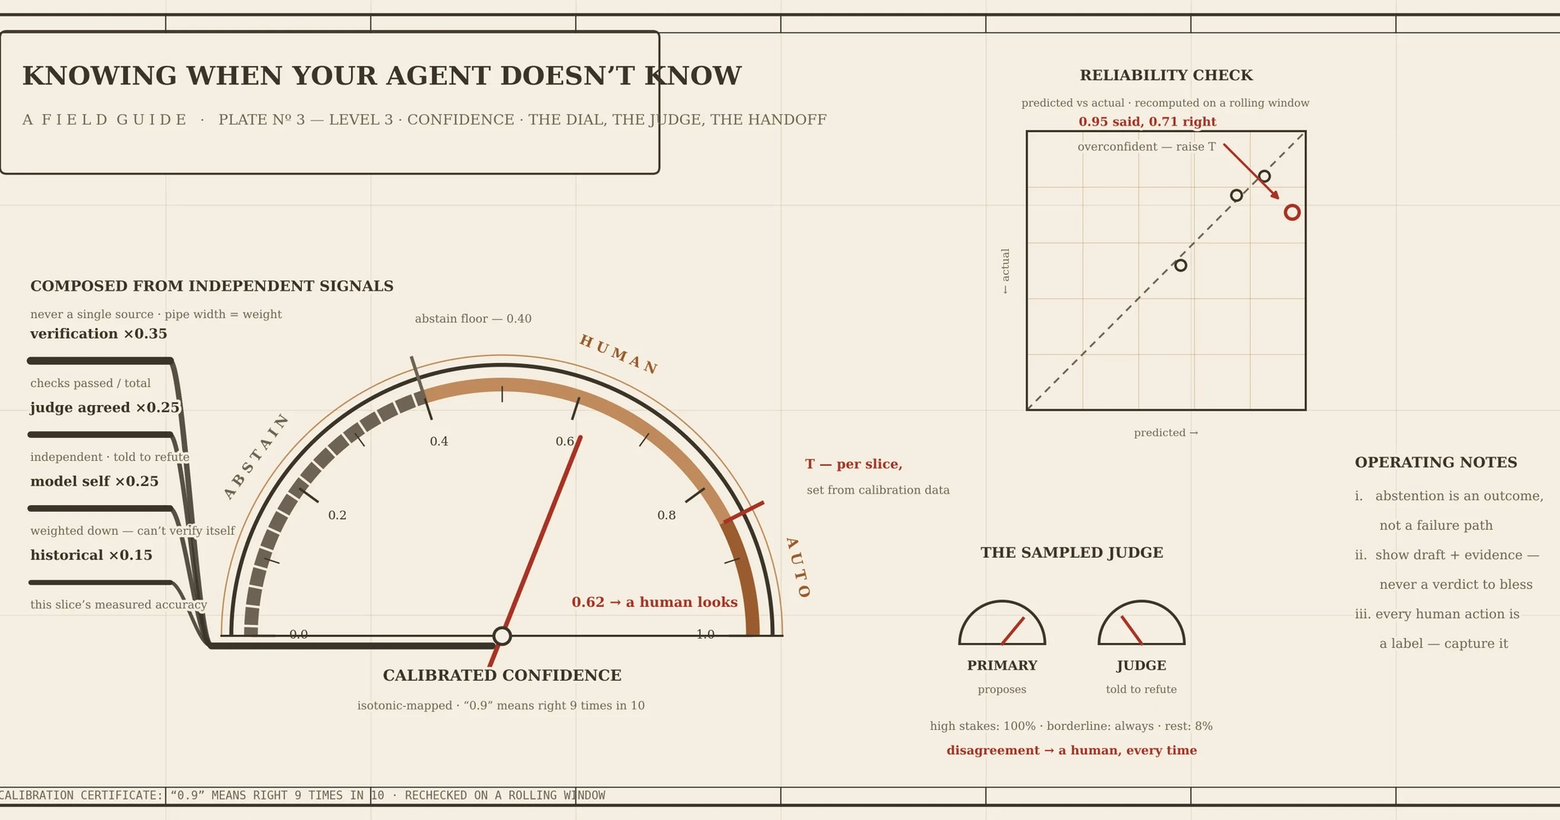
本文介绍LLM生产系统成熟度模型的第三级——置信层,核心是让系统识别自身的不确定状态。置信分需由模型自评、验证、评审、历史准确率等独立信号合成,并经过校准,使0.9的置信分真正对应90%的正确率。高风险决策由独立评审模型进行对抗式复核,出现分歧时转交人工处理。人工交接需展示草稿、推理过程与路由原因,并记录每次操作作为反馈信号,动态调整阈值,从而实现安全自动化。
延伸解读
置信分为何不能只信模型自评
文章强调,模型自报的置信度往往过度自信,不能直接作为自动化依据。生产级置信分需由模型自评、确定性验证、独立评审和历史准确率等信号合成,且模型自评权重最低。这样,即使模型“自信地犯错”,也会被验证失败或评审分歧拉低分数,避免单一信号成为单点故障。
校准:让0.9真正代表90%正确率
加权求和得到的分数并非天然校准。文章建议按预测置信度分桶,统计每桶实际准确率,若高置信桶实际准确率远低于预测值,说明阈值过松。需用等渗回归等方法将原始分映射为经验正确率,并定期滚动重算,因为校准会随模型和输入漂移。
独立评审模型:对抗式复核高风险决策
对于高风险或不可逆决策,文章主张引入独立评审模型,用不同模型家族和“找错误”的提示词进行对抗式复核。评审按风险采样,不必全量,以控制成本。当评审有把握地反对时,决策必须转人工;评审同意与否作为信号反馈到置信分中。
人工交接:展示草稿、推理与路由原因
人工交接若只给“批准/拒绝”按钮,容易导致橡皮图章式审批。好的交接应展示可编辑草稿、推理过程、证据和路由原因,让人类能快速判断。每次人工操作都应记录为反馈信号,用于调整阈值或发现系统性问题,形成闭环。
Q&A
为什么不能直接用模型自报的置信度来决定是否自动执行?
模型自报的置信度通常校准很差,模型经常在错误时也表现得很自信。因此生产系统需要从多个独立信号合成置信分,而不是直接采用模型自己的说法。
如何判断一个置信分是否校准良好?
通过可靠性图检查:将决策按预测置信度分桶,测量每个桶的实际准确率。如果0.9-1.0桶的实际准确率只有0.71,说明过度自信,需要重新校准或提高阈值。校准良好的话,0.9的置信分应大致对应90%的正确率。
在什么情况下应该让独立评审模型介入判断?
对于最高影响或不可逆的决策,100%由评审模型判断;对于置信度接近阈值的边界决策,总是判断;其余决策随机抽样5-10%作为持续质量探针。
人工交接界面应该展示哪些信息才能避免橡皮图章式审批?
应展示可编辑的草稿、推理过程、证据片段、路由原因(如置信度低于阈值)、风险等级和替代方案。这样人类可以基于依据做出真实判断,而不是盲目点击批准。
如何利用人工审核的反馈来动态调整自动化阈值?
记录每次人工操作作为信号:如果某切片人类几乎一致批准,可降低该切片的阈值以增加自动化;如果频繁覆盖,则提高阈值或转为纯人工;如果同一字段被多次编辑,说明智能体在该处系统性错误,需修复提示或逻辑。
为什么说弃权(abstain)是置信层中值得鼓励的一等公民?
弃权是系统正确认识到自身能力边界,比总是回答更值得信任。设置弃权下限(如0.40)可以让太不确定的输入自动转交人工,这是防御未知未知的最佳方式。不应将弃权视为错误路径,而应测量并鼓励。
