谷歌发布世界模型Genie 4,支持实时交互模拟并原生生成音效。该模型融合Gemini系列能力,由Gemini Omni保障真实感,其他模型维持模拟连贯性。用户可通过自然语言实时操控场景,如移动镜头、改变天气或添加角色,并同步生成环境音、音乐和对话。该技术被视为迈向AGI的重要一步,可用于机器人训练及影视、游戏等领域。目前已向少量测试者开放,后续将登陆Google AI Ultra等平台。
本文测试手机端脚注交互:点击句末数字跳至文末说明,点击返回图标回到原引用段落并短暂高亮。测试涵盖普通脚注、同一说明多处引用时的返回、列表与引用块中的脚注及普通链接锚点,并建议将示例复制到评论区检验评论脚注能否各自对应。
“江山时序”是一款免费开源的宣纸设色中国历史交互地图,浏览器打开即用。它以谭其骧《中国历史地图集》和哈佛CHGIS数据为参考,用原生JS开发,支持拖动2400年时间轴、点击古城查看18朝沿革、搜索百余位历史人物,帮助直观了解历代疆域变迁与古地名今址。作者表示因视觉干扰和移动端误触问题,暂不为事件人名添加链接。
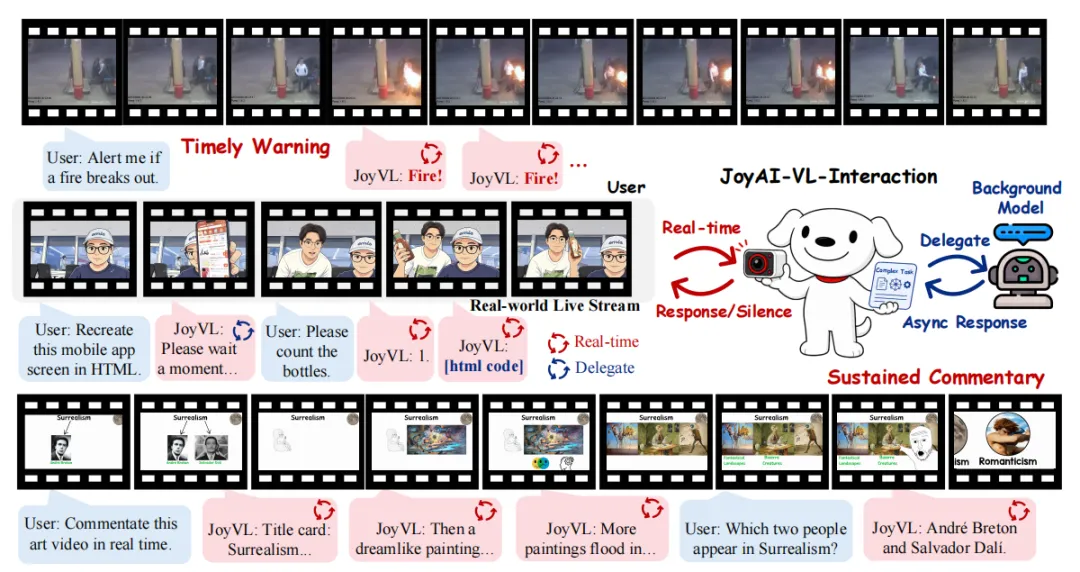
京东探索研究院提出8B规模视觉驱动交互模型JoyAI-VL-Interaction,可持续接收视频流并每秒自主决定回应、沉默或委派后台任务。模型通过时间对齐数据、加权监督微调与强化学习训练交互时机,结合AdaCodec编码、双循环架构和分层记忆支持长时交互。在六类58个案例中,其人类偏好胜率对豆包和Gemini分别为77.6%和87.9%。
iRTE2026实时智能大会聚焦对话式AI从“会答”转向“持续参与真实交流”,核心挑战包括模型能力与业务结果对齐、实时对话底层技术底座,以及技术落地终端硬件的现实考验。声网提出五级对话能力框架,并展示多模型协作、实时推理云及对话式AI引擎等基础设施,推动语音识别、推理、传输与终端响应全链路协同。
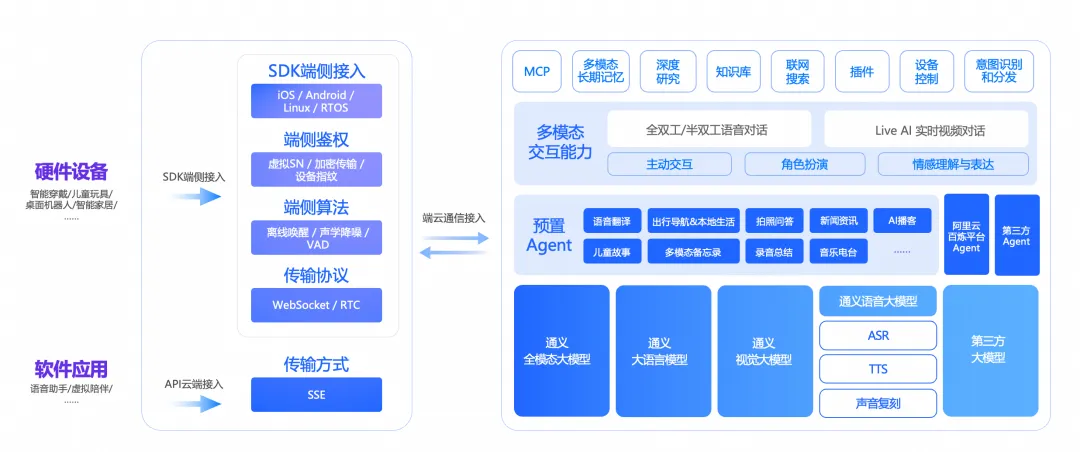
阿里云百炼多模态实时交互套件升级至Qwen-Audio-3.1,面向AI眼镜、学习机、汽车、机器人等硬件提供级联式语音交互方案。ASR支持30种语言、16种中文方言及热词识别,首字响应约160毫秒;TTS支持跨语言同音色与情绪语速调节,Elo评分全球第一。套件端到端延迟最低1秒,一套SDK适配30多个硬件平台,TTS降价约70%、ASR降价95%,并提供设备管理与运营能力。
iRTE2026实时智能大会将于10月23日至24日在北京悠唐皇冠假日酒店举行,全议程已公布,限免报名中。大会汇聚多模态模型、Voice Agent、实时音视频、AI Infra、AI硬件及应用场景一线从业者,探讨实时智能在模型、工程技术、基础设施与商业落地方面的关键变化。
文章讨论微信“按住说话”交互:按住设计是改进,但松开即发送值得商榷。作者主张先转文字到输入框,让用户确认再发送,以避免口误或识别错误引发歧义,并建议增加偏好设置;同时批评滑动编辑按钮设计令人不安。
OpenAI发布GPT-6与Intelligent UI,将AI从聊天回答转向可查看、修改、确认和执行的界面化任务流。模型仅生成结构化建议,校验、权限与提交由界面负责。开发者应重视Schema、状态机、审计与权限,而非只调模型。
OpenAI为ChatGPT推出智能界面,回答不再限于文字,可自动生成图表、按钮、表单和交互工具,例如点击自行车示意图查看零件、调整聚餐采购量或使用计算器。该功能即日起向付费用户推送,明天起扩展至免费用户。付费档使用GPT-6 Sol,免费和Go版使用GPT-6 Luna。
“格物间·宇宙与天文专题”是一个免费天文交互演示平台,无需注册登录。平台包含10个演示,分为四组,从1米尺度放大到可观测宇宙,支持拖动、缩放和真实速度播放,内容涵盖宇宙尺度、光速光年、引力时空弯曲等,适合亲子互动和教学投屏。
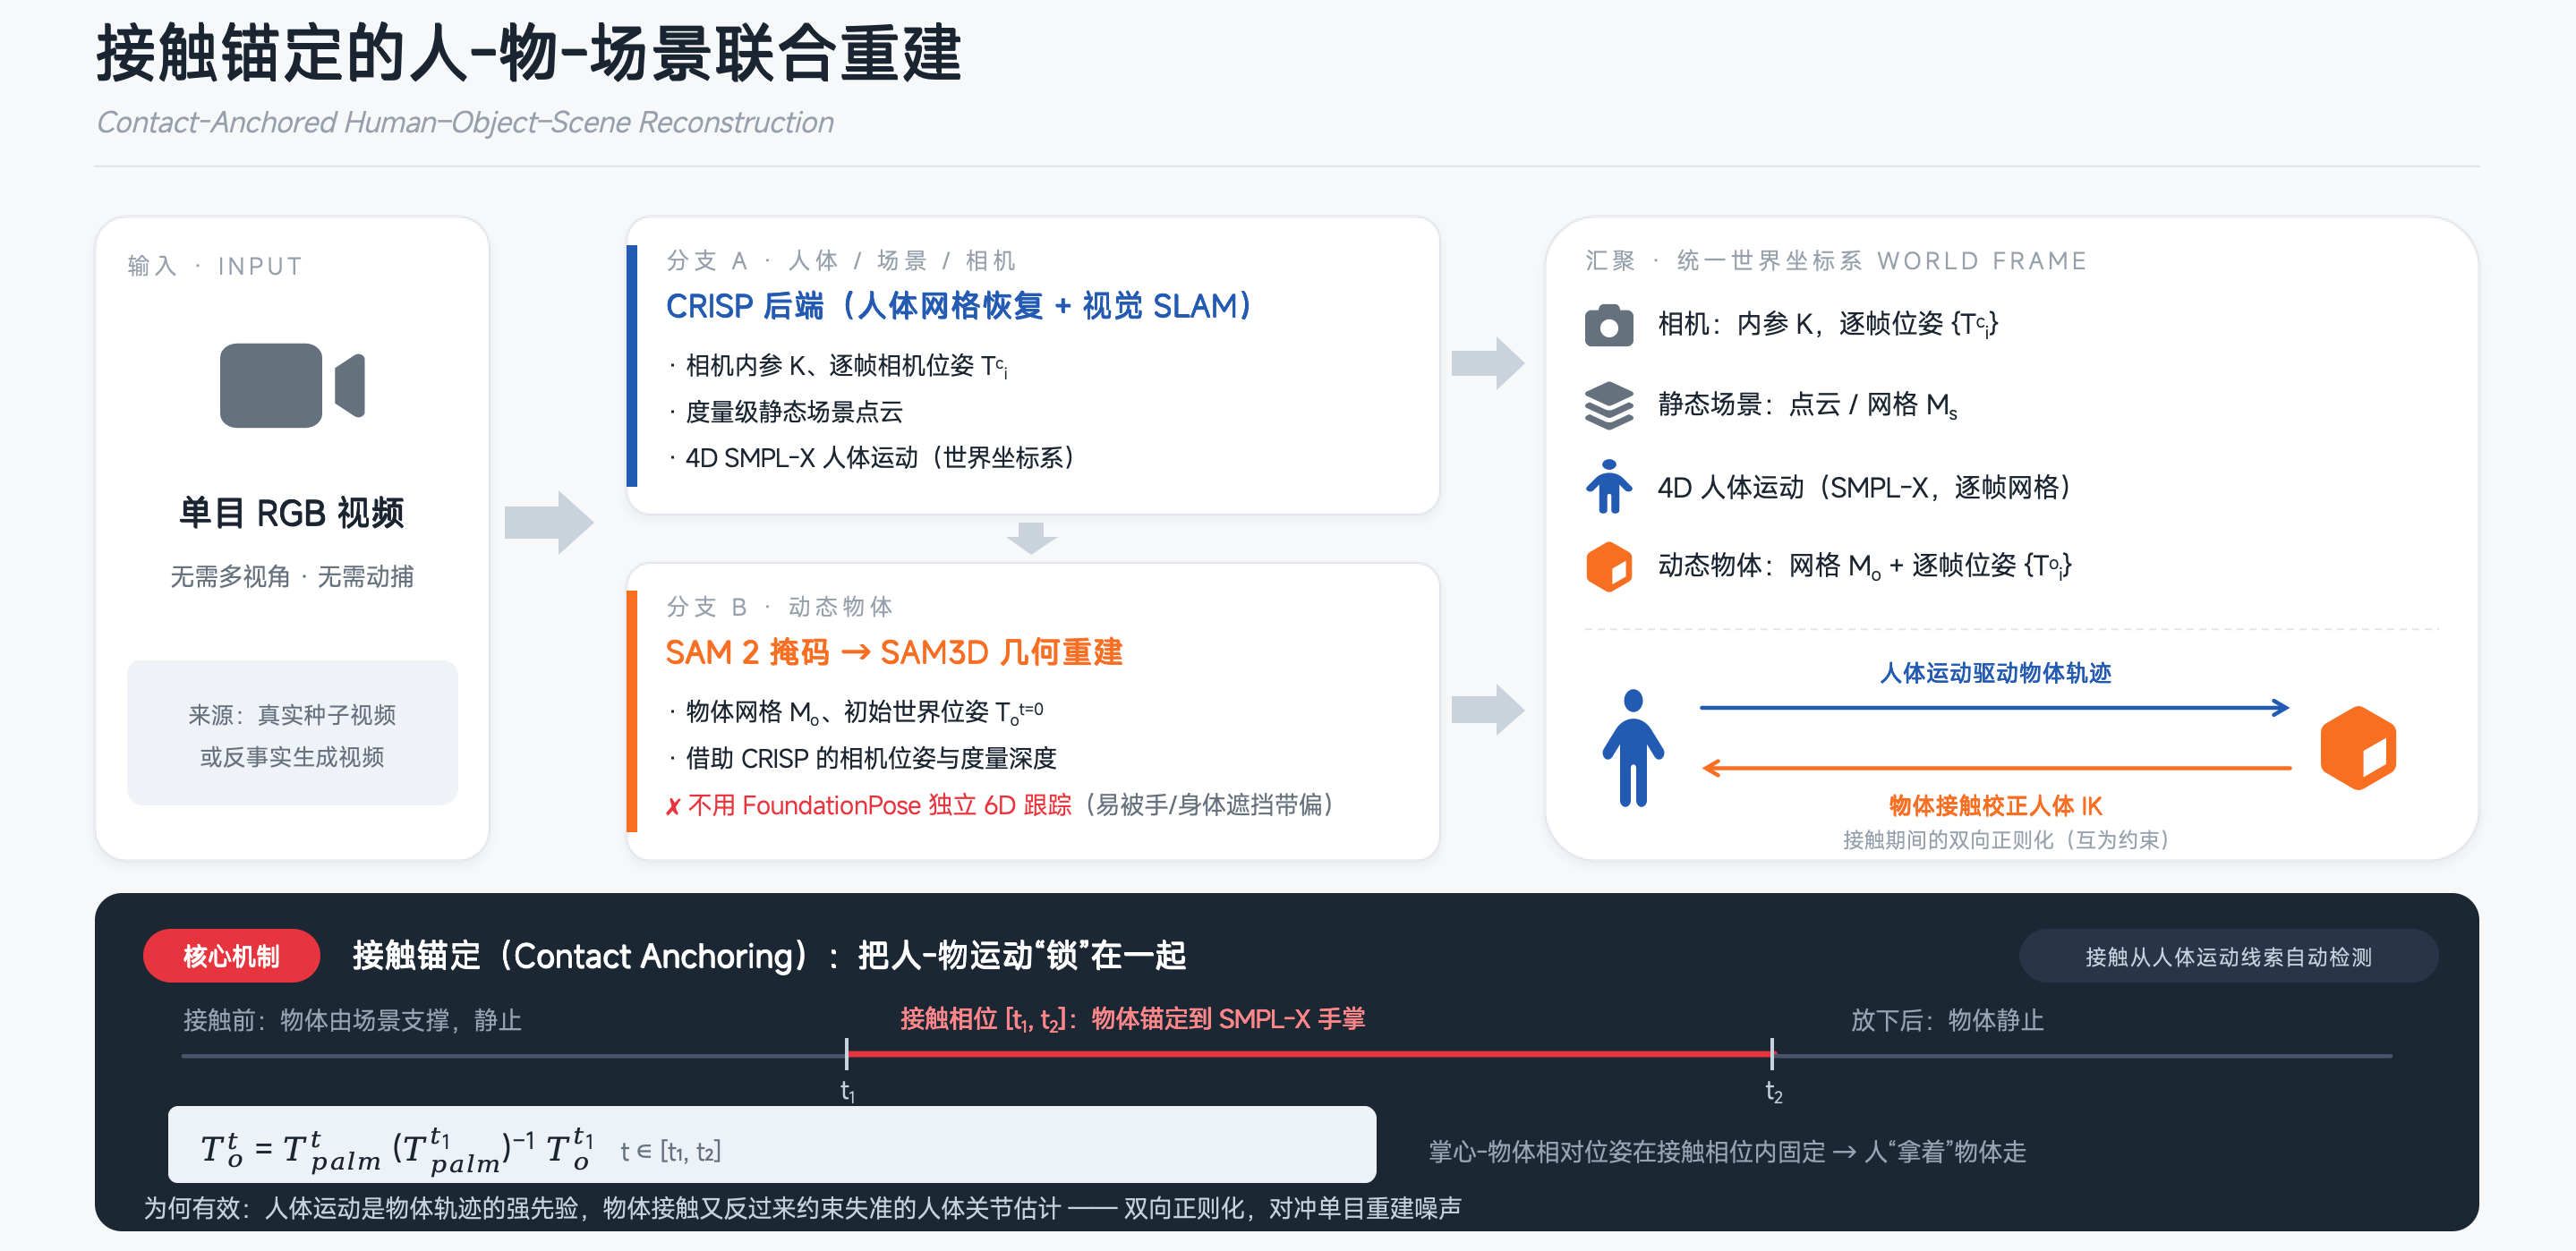
PRISM提出“真实到仿真再到真实”框架,利用视频到视频生成将少量真实视频扩增为256段反事实人-物交互视频,并以接触为锚点重建和重定向为物理合理的机器人轨迹,训练单一深度策略。人形机器人无需真实微调,仅凭机载深度即可零样本抓取、搬运和放置箱子、桶、料箱和球等未见物体。
Omarchy截图工具将支持任意位置和程序的长截图。进入滚动截屏后,程序自动探测与截取区域交叉的窗口供选择;点击按钮自动滚动,点空白处进入编辑模式,可缩放,操作如手机长截图般简单自然。
文章以iPhone Duo为例分析苹果折叠屏交互设计,认为其回归“人”本身,提出情境先行、过程可控、空间连贯等元原则;Duo以“书”为隐喻,将Dock与工具栏移至侧边,并利用铰链角度驱动动画与反馈,使开合过程成为可感知的交互。
本期Rust资讯:Topcoat 0.9发布,强化全栈Rust Web框架的服务端交互,新增WebSocket推送UI更新及Toasty ORM;matklad用生成式测试在旧版regex中发现匹配bug;csveee实现单次遍历高速并行CSV解析,多核近200GB/s;介绍Clippy维护者Alejandra González。
这个月早些时候,由小智游戏开发的RPG游戏《未眠野》正式公布了首支PV。截止到目前,这支PV的播放量已经超过1300万,伴随着这份热度一同出现的,还有围绕玩法的争议,不少玩家觉得它有点“像塞尔达”。这种联想不难理解,这支PV里展示了不少围绕物理规则展开的玩法,像是挥动旗帜产生气流,推动木船前行,时停物体后通过击打积蓄动能、借助石块冲击力将敌人直接击飞,以及把各种金属构件组合成载具等等。这类玩...
dabit3/jev-experiments 汇集20多个实验,探索 TypeSafe Jev 低延迟决策模型(70-500毫秒,远快于LLM)的应用,覆盖客服辅助、智能收件箱、自然语言命令、代码检查、提交防护、紧急调度、聊天审核、群体模拟等场景,展示语义判断降至毫秒级后,软件交互从“提交后等待”变为“实时辅助”。
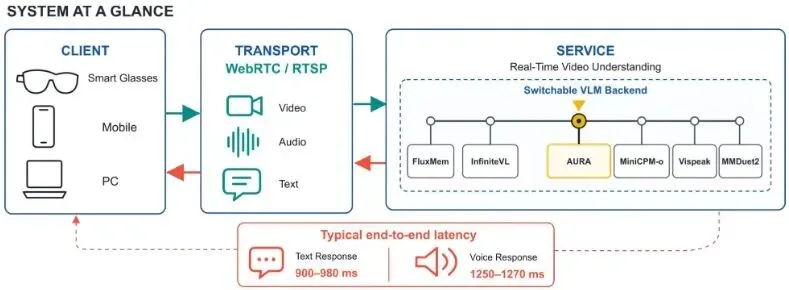
本文提出一套低延迟边云系统,集成六种流式视频VLM后端,共享ASR/TTS与统一编排,支持实时语音交互。实验显示,在合适后端与WebRTC传输下,首句VLM文本延迟约0.9–1.0秒,首段TTS音频约1.3–1.5秒。研究表明实时视频理解是分层系统问题,VLM到TTS交接尤为关键,低首token延迟并不保证快速语音响应。
大晓机器人联合南洋理工大学等发布HSImul3R,这是首个面向稀疏视角、可仿真的人–场景交互重建框架,已被ECCV 2026接收。该框架提出物理闭环双向优化,将重力、接触与交互稳定性纳入标准,并构建HSIBench。其交互稳定率显著高于HSfM,穿模率从69.51%降至22.90%,还实现动作迁移至Unitree G1,打通视频到真实机器人执行链路。
语言模型生成的三维场景并非真正的游戏,仅含少量交互元素。目前它们无法创作出具备完整玩法、机制与挑战性的优质游戏,仅能构建基础环境。
完成下面两步后,将自动完成登录并继续当前操作。