

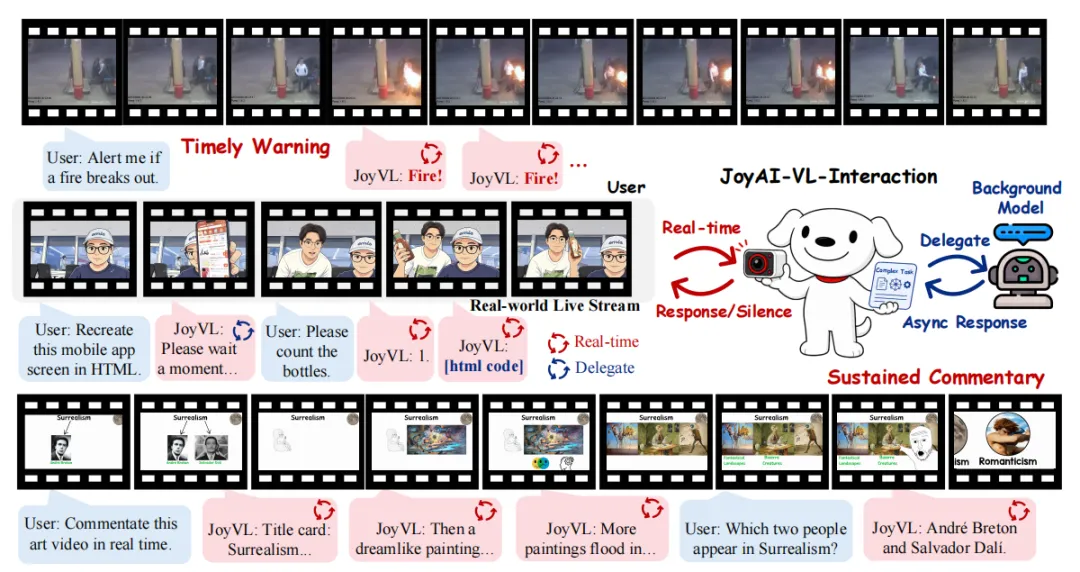

JoyAI-VL-Interaction:实时视觉-语言交互智能
内容提要
京东探索研究院提出8B规模视觉驱动交互模型JoyAI-VL-Interaction,可持续接收视频流并每秒自主决定回应、沉默或委派后台任务。模型通过时间对齐数据、加权监督微调与强化学习训练交互时机,结合AdaCodec编码、双循环架构和分层记忆支持长时交互。在六类58个案例中,其人类偏好胜率对豆包和Gemini分别为77.6%和87.9%。
延伸解读
交互时机成为独立训练目标
文章指出,传统视觉语言模型采用轮次式交互,难以持续跟踪事件并主动判断何时发言。JoyAI-VL-Interaction将回应、沉默与委派纳入每秒决策,并通过时间对齐数据、加权监督微调和强化学习专门训练交互时机。这提示读者,在实时视频场景中,模型“何时说”与“说什么”同样重要,沉默也被视为正确完成任务的一部分。
系统设计支撑长时实时交互
为应对持续视频流的计算开销,模型采用AdaCodec减少时间冗余,完整帧256个视觉token,预测帧仅16个。系统通过实时循环与异步循环分别处理即时交互和后台委派,并利用分层记忆压缩历史信息。这些设计说明,实时交互不仅依赖模型能力,还需要编码、记忆和调度等系统级协同,才能支持长时间稳定运行。
人类偏好胜率需结合场景理解
在六类58个案例中,JoyAI-VL-Interaction对豆包和Gemini的人类偏好胜率分别为77.6%和87.9%,监控告警场景对两者均达100%。但文章明确,这些数字反映综合质量与时机后的偏好比例,并非通用视频理解或事件检测准确率。直播解说对豆包胜率仅55.6%,说明开放式任务仍受知识、表达风格等因素影响,读者不宜将胜率简单外推为全面优势。
开放与局限并存
文章称该工作是首个同时开放模型权重、交互数据、训练方案及完整可部署系统的视觉驱动交互模型,为可复现研究提供基础。同时作者指出,模型规模较小,通用能力与复杂输入稳健性仍有提升空间;交互数据规模与质量尚未充分优化,直播解说偶现幻觉;评估仅覆盖六类场景58个案例,仍需更广泛验证。读者应关注这些限制对实际部署的影响。
Q&A
JoyAI-VL-Interaction 是什么?它主要解决什么问题?
JoyAI-VL-Interaction 是京东探索研究院提出的 8B 规模视觉驱动交互模型与系统。它主要解决传统轮次式视觉语言模型难以持续跟踪视频事件并主动判断何时回应的问题,使模型能够持续接收视频流,并在每秒决策中选择回应、保持沉默或将复杂任务委派给后台模型。
JoyAI-VL-Interaction 如何训练模型判断何时该说话、何时该沉默?
模型通过时间对齐数据(超过 400 万条流式交互片段)进行训练,数据标注了回答内容及应出现的时刻。监督微调采用按 token 角色加权的交叉熵损失,提高回应标记权重、降低重复沉默权重,以平衡沉默与回应信号;随后使用 GRPO 强化学习,奖励正确且时机合适的回答、必要沉默与合理委派,惩罚无依据发言、时机错误或始终回答的行为。
AdaCodec 在系统中起什么作用?它如何减少视觉 token 开销?
AdaCodec 借鉴预测编码思想,在视觉信息进入语言模型前减少时间冗余。它将视频组织为图像组:参考帧保留完整 RGB 表征(256 个视觉 token),可预测的中间帧通过运动向量与预测残差表示,由 P 帧分词器生成紧凑 token(仅 16 个)。当预测代价升高或达到长度上限时刷新参考帧,从而在减少 token 的同时保留时序变化信息。
系统的实时交互架构包含哪些核心组件?如何支持长时间视频交互?
系统围绕实时循环与异步循环两个并发循环组织:实时循环持续接收视频流并每秒决策是否回应;异步循环处理委派的后台任务,通过委派桥接模块连接。同时采用分层记忆(短期保存原始视觉 token、中期转为文本摘要、长期进一步压缩)和对话记忆,结合 vLLM 的 KV Cache 复用,以较小上下文开销支持长时间交互。
JoyAI-VL-Interaction 在人类评估中的表现如何?与豆包和 Gemini 相比胜率是多少?
在六类真实场景、58 个案例的人类评估中,JoyAI-VL-Interaction 相较豆包视频通话功能的人类偏好胜率为 77.6%(平局 17.2%,负率 5.2%),相较 Gemini 的胜率为 87.9%(平局 10.3%,负率 1.7%)。评估同时考虑回答质量与时机,胜率表示综合质量与时机后的偏好比例。
JoyAI-VL-Interaction 有哪些局限性?
论文指出当前不足包括:模型规模较小(8B),通用能力与复杂输入下的稳健性仍有提升空间;交互数据的规模、清洗质量和混合比例尚未充分优化,直播解说中偶尔出现幻觉;评估仅覆盖六类场景和 58 个案例,仍需更广泛、更细粒度的验证。此外,评估结论不能认定该模型在通用知识、复杂推理和开放式对话中全面优于对照产品。
