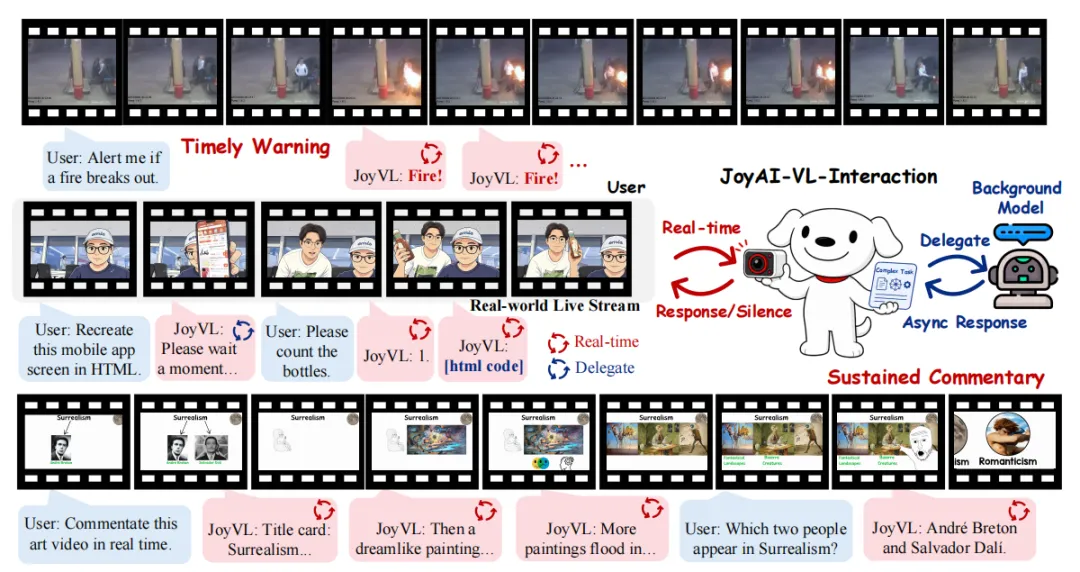
京东探索研究院提出8B规模视觉驱动交互模型JoyAI-VL-Interaction,可持续接收视频流并每秒自主决定回应、沉默或委派后台任务。模型通过时间对齐数据、加权监督微调与强化学习训练交互时机,结合AdaCodec编码、双循环架构和分层记忆支持长时交互。在六类58个案例中,其人类偏好胜率对豆包和Gemini分别为77.6%和87.9%。
完成下面两步后,将自动完成登录并继续当前操作。