bstorm 是仓颉版嵌入式 JSON 文档数据库,通过 @Index 标注建立索引。索引使等值查询提速约 44 倍(2015ms 降至 46ms),但写入性能从 21k/s 降至 11.5k/s,成本主要来自事务提交次数,合并主数据与索引写入可挽回部分损失。范围查询在 LSM 上走索引反而更慢,因此采用流式扫描。建议只为高频等值查询字段建索引,因为成本随索引数量线性叠加,而收益并不叠加。
SpaceX斥资约80亿美元收购800MHz低频段频谱,并在此前以近200亿美元购入EchoStar频谱,还获FCC批准部署1.5万颗新一代星链卫星,意图成为美国第四大移动运营商,挑战AT&T、Verizon和T-Mobile。分析师Walter Piecyk认为,SpaceX需自建地面网络,初期资本开支约100至150亿美元,并依赖漫游协议起步。三大运营商正联手抵制,Verizon因频谱受限和战略失误处境最弱。
以色列初创公司Uvi获750万美元种子轮融资,旨在解决AI代理重复搜集上下文导致成本虚高的问题。其平台通过语义层、知识图谱和推理层,集中管理企业分散在Slack、Jira等系统中的决策记忆,使代理一次获取精准上下文。测试显示,答案成本从0.75至1.41美元降至0.10至0.16美元,最高节省46倍。
本文分享了基于AWS Glue构建DynamoDB批量执行工具Bulk Executor的经验,该工具实现无服务器并行,支持find、delete、count等命令。设计取舍包括:用Spark DataFrame简化命令开发,但因连接器不支持删除且丢失数据类型,部分命令改用直接API调用;用CloudWatch Live Tail实时输出,需解决采样、乱序和延迟问题;通过错误累加器避免重复堆栈;强制启用PITR以便回滚;自建分布式限流器;并用AI辅助测试和代码检查。
PostgreSQL 18 测试表明,将 UUID 主键存为 text 类型代价显著:500 万行数据下,索引体积大 88%,B 树多一层,每次随机查询多读一页;插入更慢,UUIDv4 因随机写入多耗 33 秒和 540MB WAL。原因是 text 占 37 字节,远大于 uuid 的 16 字节。建议使用 uuid 类型。
Eclipse基金会成立“主权AI基金会”,联合17家机构推动供应商中立、开源协作,帮助企业应对AI平台锁定、网络安全与数据控制风险。基金会聚焦数据、模型、基础设施与运营,倡导模块化设计,保留选择与自主权,适用于汽车、制造、电信、公共部门等长周期、高安全需求领域。
PostgreSQL 19 新增 REPACK 命令,整合 VACUUM FULL 与 CLUSTER,其 CONCURRENTLY 模式可在线重写表,无需扩展,托管服务可用。实测比 pg_repack、pg_squeeze 更快、WAL 更少、失败后无残留。但运行期间会阻碍 VACUUM 清理死元组,末尾换表需短暂 ACCESS EXCLUSIVE 锁,更新删除超约 1.05 亿行会内存耗尽失败,旧快照可能读到空表。
Anthropic推出生命科学验证计划(LSVP),经资质审查的团队可获得更宽松的生物学防护。授权分为标准与高风险两级,绑定机构、项目和有效期。策略从逐条拦截转向跨会话离线监控,代价是流量留存30天。目前仅支持企业API,不适用于BAA组织。作者认为分级访问优于一刀切,但需严格验证、有效监控和及时响应。
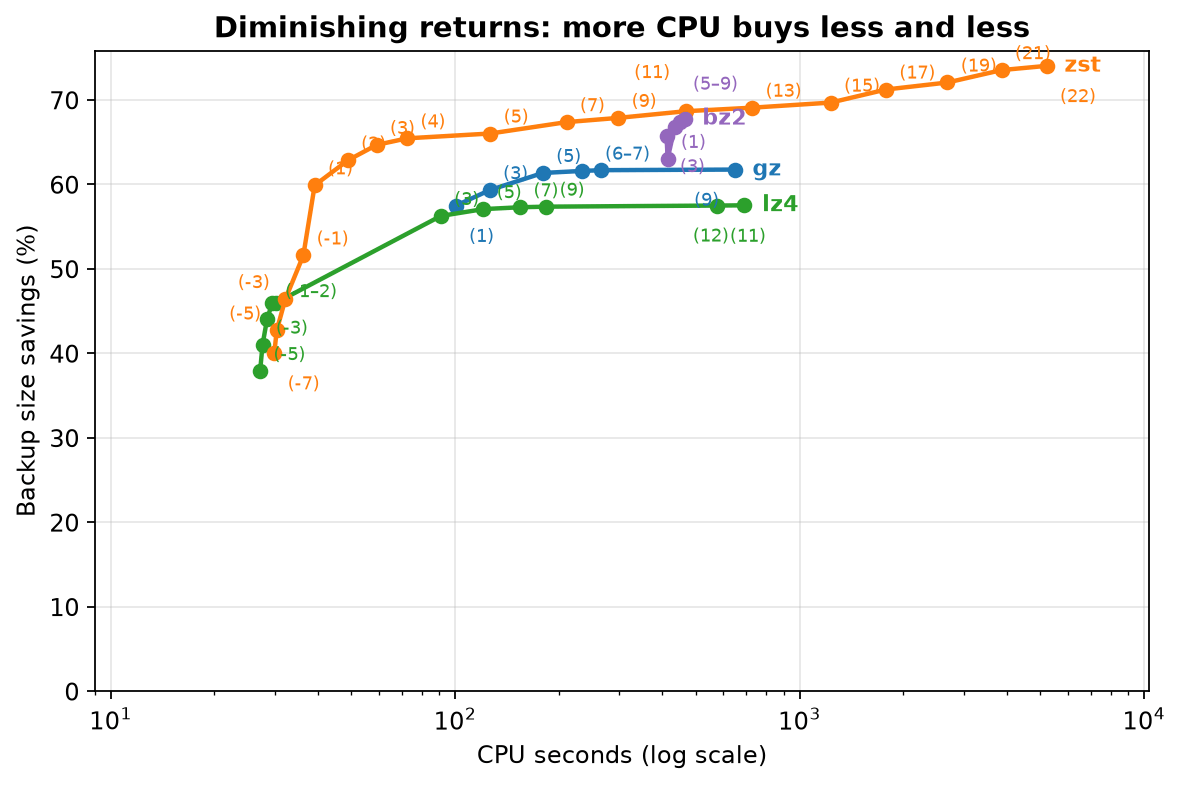
本文通过真实数据比较了pgBackRest各压缩算法与级别,以寻找CPU与备份大小的最佳平衡。结论:Zstandard低级别最优,默认zst(3)处于曲线拐点,节省约65%空间且CPU仅59秒;zst(22)备份最小但CPU高约88倍。LZ4适合快速廉价场景,gzip在5级后收益甚微,bzip2始终不占优。建议选用zst并保持低级别。
轻糖iOS版冷启动3秒必现崩溃,根因是共享层ViewModel的Flow订阅异常未捕获,在Kotlin/Native上触发SIGABRT。修复方案是在每个订阅外层加try/catch,CancellationException需rethrow,异常记日志并写入UiState。沉淀三条军规:订阅必须兜底、取消异常优先处理、异常只进日志和UiState。
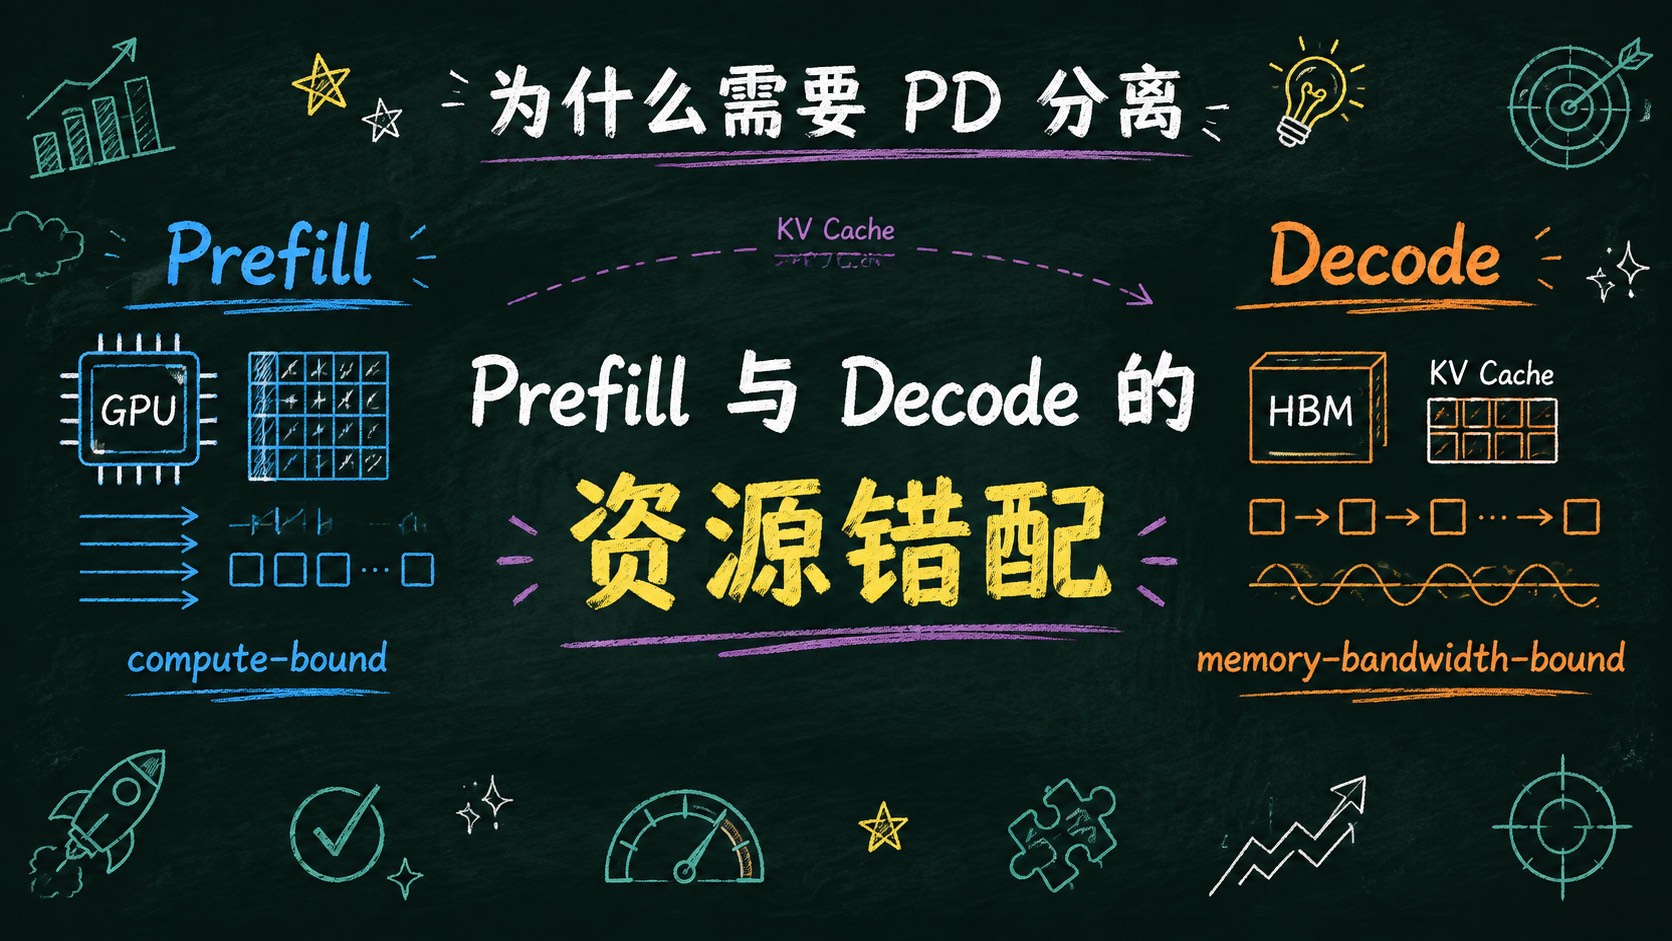
PD分离将LLM推理的Prefill(计算密集)与Decode(显存带宽密集)阶段拆分至独立资源池,以隔离干扰、优化TTFT和ITL,并允许按需配置硬件。它通过KV Cache传输衔接两阶段,但增加调度、网络和资源开销。仅当共置优化(如Chunked Prefill)无法满足SLO或资源需求不对称时,才值得采用。
制造业IIoT产生高频传感器数据,传统数据库难以处理。文章指出五大趋势及数据层解决方案,并举例说明TimescaleDB如何优化PostgreSQL,实现存储减少83%、查询提速979倍,解决工业4.0数据挑战。
在2M行PostgreSQL 17上,覆盖索引比单列索引写入慢28%(INSERT)和25%(UPDATE),但读取快1.26倍。当写入低于每分钟约4300次时,覆盖索引更划算;否则单列索引更优。存储占用112MB对18MB。建议先设置random_page_cost=1.1,默认用单列索引,仅在需要时添加覆盖索引。
该文章介绍了一个名为“Your AI Slop Bores Me”的趣味网站,用户可扮演人类或AI角色互动。一方提交请求,另一方在150秒内以文字或图像回应,模拟聊天机器人。游戏采用积分制,需通过回答他人请求赚取积分,也可等待免费请求。尽管广告较多,但角色扮演的乐趣和创意回应使其成为消遣好选择。
Ceph的ECBackend实现中,整条带写无需读旧数据,而部分写需读改写(RMW),增加延迟。EC修复从k个存活分片重建缺失分片,网络效率优于副本池。EC池空间效率高(4+2为1.5倍),但随机小写延迟高,适合顺序大写场景如RGW。allow_ec_overwrites支持覆盖写,但RMW代价仍在。编码插件有Jerasure、ISA-L等,LRC可降低重建读取。
CephFS将POSIX文件系统构建于RADOS之上,MDS作为可恢复状态机,通过journal持久化元数据。其核心挑战包括:MDS故障恢复、capability机制维持客户端缓存一致性、多active MDS的subtree迁移可能引发thrashing,以及fsync/stat操作的高网络往返成本。相比RBD,CephFS在元数据面(journal、caps、subtree、dirfrag)付出更高代价,快照需客户端协作,性能与一致性权衡复杂。
捷径如同信用卡,提前支取未来,但账单终将偿还且带利息。危险在于误把借来的能力当自身财富。判断捷径需看省掉什么、欠下什么,好的捷径压缩已掌握过程,坏的则用未备能力换早到结果。目标决定路径,若求成为能反复抵达的人,过程即目标。时间须换更有价值之物才算节省,承认抄近路并补课,避免转嫁代价,最终获得判断力:知何可省,何须亲历。
Meta发布AI编程代理Muse Code,价格低于Claude Code,但默认使用贡献者层级,代码可能用于训练。测试显示两者修复bug能力相当,但Claude重构更彻底、代码更干净,Muse虽便宜但需专家审查,省下的成本可能转为审查时间。
价值观是回答“什么值得”的排序,而非列举;清单免费,排序昂贵。它功能是省事,让选项不再计算。未探究会套用社会默认,嫉妒比成就感诚实,环境大于反思。只有付出代价时价值观才被测量,观察时间、金钱、注意力流向可反推真实价值观。
本文比较图数据库四种邻接布局(边表、CSR、指针链、Block内联)的代价模型,分析一次hop与k跳扩张的差异。核心观点:大O相同但常数、局部性、更新代价不同;幂律图超节点主导事故形态;选型需关注k、f、d_max和更新频率四个旋钮,而非品牌之争。
完成下面两步后,将自动完成登录并继续当前操作。