作者修正半年前“杀死代码评审”的观点:逐行评审已过时,但替代方案不应只是AI查diff。评审的核心是建立团队对系统的共同理解,而非找bug;AI能查错却缺乏判断力与问责。新方案分五层:让AI先辩论、记录意图与验收标准、建立“AI劣质模式登记表”、保留团队讨论决策环节,并明确谁拥有不变量。
GitHub更新Copilot代码评审,支持在防火墙后运行构建、测试和脚本,为评论提供证据;Lite档改用多Agent。官方称高严重度问题处理量增47%,但不宜外推。团队应重定义指标,关注可复现率、误报率和修复时长,并限制权限、隔离环境,防止把工具执行误当结论正确。
代码评审是持续集成的重要环节,需人工介入,以避免设计理解偏差、促进知识传播、检查逻辑正确性。实施时应找了解代码的人评审,使用检查清单,并提前约定提交规范,确保评审高效、代码质量可控。
代码评审需要良性社交压力,重点关注修改范围、安全、功能、异常处理、性能、可维护性与可测试性。其最大挑战在于难以发现真问题、容易纠结代码坏味道且难以达成共识。若评审意见无法说服开发者,会损害个人影响力,因此对技术功底和沟通能力要求很高,需持续打磨。
AI时代重估《程序员应该知道的97件事》:技术债因AI加速生成而利息暴涨,删代码、测试、代码评审等规矩升值;IDE手速、刻意练习科目贬值;结对编程、读代码对象换为AI。核心是:AI改写写代码方式,未改写负责方式,人类仍需对代码负责,经验从“手上”升值到“肩上”。
AI时代重估《程序员应该知道的97件事》:技术债利息因AI提速爆炸,删代码成稀缺手艺,测试从美德变记分牌;IDE精通和手写算法贬值,刻意练习转向需求表达;代码评审、结对编程、读代码的对象换成AI,但责任仍在人。核心是AI改写写代码方式,未改写负责方式,经验从手上升值到肩上。
本文介绍Superpowers工具在AI编程中的应用,重点讲解其安装配置及七步开发流程,包括需求澄清、分支隔离、任务拆解、TDD测试、代码评审等步骤,并以Python缓存数据库开发为例,强调严格按流程串行执行,避免AI过度自主操作。
Cloudflare用11个月构建了AI工程栈,分为平台、知识、治理三层:通过代理Worker和AI Gateway实现零信任与降本,用AGENTS.md和Backstage提供上下文,以Codex RFC标准库机器化工程规范。其AI代码评审系统由协调者调度7个专科Agent,按风险分级,四个月拦截1.6万次不合规合并,单次成本仅0.98美元,展示了AI时代软件工程的标准落地与审查执行之道。
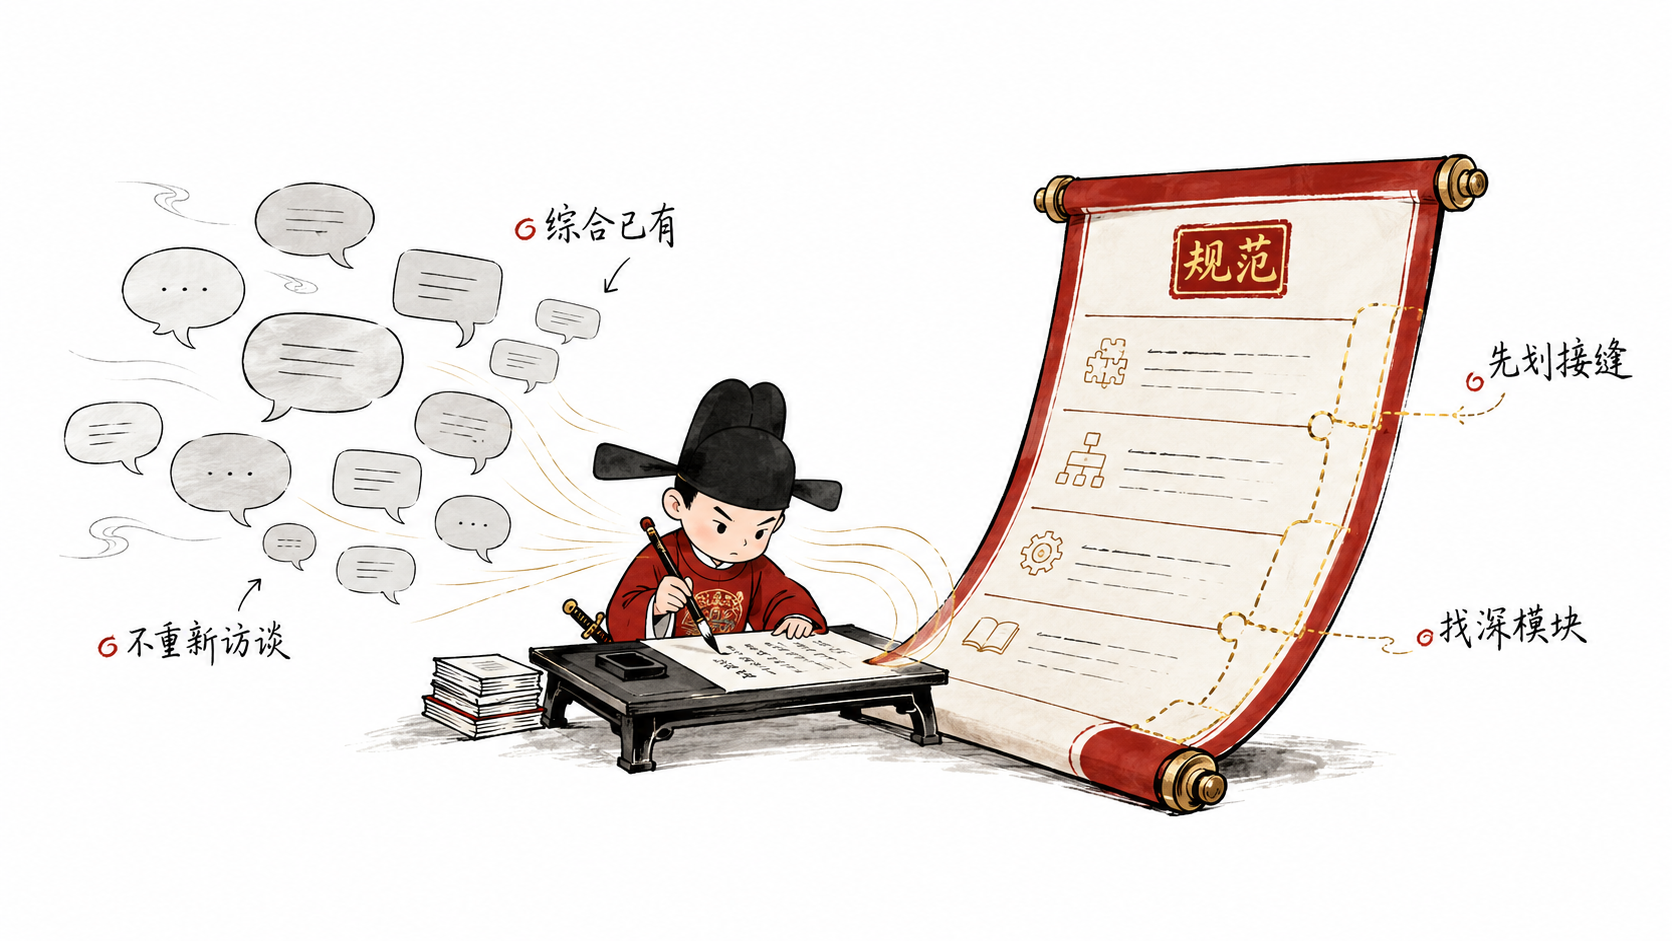
TypeScript 名师 Matt Pocock 开源了一套 Claude Code Skills,以五个命令构成主线:/grill-with-docs 逐个问题拷问想法并沉淀文档,/to-spec 综合成规范,/to-tickets 拆分为可独立演示的垂直切片票据,/implement 按票据进行 TDD 实现,/code-review 从编码标准与规范符合度两条轴并行评审。其核心是将“想清楚”与“写代码”分为两段:前三步只做认知对齐,后两步才动手实现。
AI辅助开发虽然提高了个人代码产出,但团队协作和代码评审效率下降,整体生产力未见提升。开发者需重视团队认知同步和架构决策,避免各自为政。高效团队采用集体编程模式,确保代码一致性和理解。独立开发者应关注文档和自动化测试,以应对AI生成代码的复杂性。真正的效率提升在于优化协作和决策过程,而非单纯增加代码量。
GitHub Copilot CLI 引入了 Rubber Duck 作为评审智能体,能够通过不同模型的视角优化编码过程,发现主智能体的盲点,提升复杂任务的解决率,尤其在多文件和长流程任务中表现突出。用户可在关键节点请求评审,以确保代码质量和测试覆盖,该功能现已在实验模式下开放。
本文介绍了如何优化在 Claude Code 中使用 Opus 4.7 的体验。Opus 4.7 提升了处理模糊性和代码评审的能力,建议用户明确任务描述,减少交互次数,并利用 auto 模式提高效率。默认的 effort 级别设为 xhigh,适合大多数编码任务。自适应思考功能改进,允许模型根据上下文调整思考深度,用户应关注行为变化以更好地利用新模型。
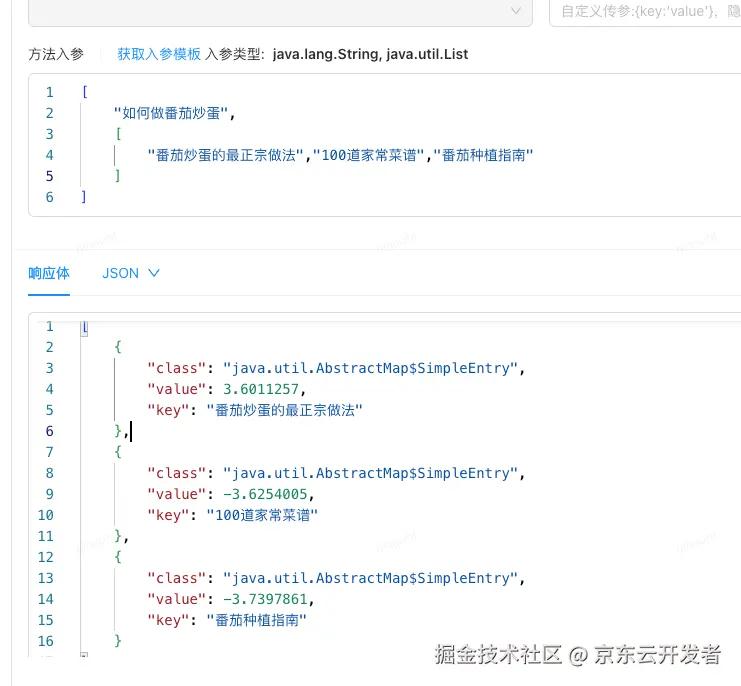
双十一大促期间,代码评审面临效率与质量的挑战。研发组探索双RAG架构,结合知识检索与AI评审,提升代码评审的准确性和效率。通过识别项目类型和智能分块处理,系统能更好地理解代码上下文,预防潜在缺陷,确保系统稳定性。未来将扩展至多模态理解和全域业务知识库,提升评审的全面性与准确性。
双十一大促期间,代码评审面临效率与质量的挑战。传统评审模式效率低,AI工具误报率高。为此,商家导入研发组探索双RAG架构,结合知识检索与AI评审,提升代码评审的准确性和效率。通过识别项目类型和智能分块处理,系统能更好地理解代码上下文,预防潜在缺陷。
大模型是由深度神经网络构建的,参数量达到数十亿,广泛应用于自然语言处理和计算机视觉等领域,具备强大的泛化能力。joycoder工具可用于代码评审和安全检查,帮助生成测试用例,提高测试效率。
在代码评审中,有效沟通至关重要。作者分享了与同事Mallory的冲突经历,强调了提供建设性反馈和避免僵局的技巧。通过拆分变更集、聚焦关键问题和给予真诚赞扬,可以提升代码质量并改善团队关系。良好的沟通有助于团队成员成长,避免不必要的冲突。
新手开发者依赖AI工具快速交付代码,但缺乏深入理解和基础知识。虽然AI使用方便,但可能影响对问题的深刻理解。建议在使用AI时提问、参与讨论、重视代码评审和亲自实践,以保持学习深度。未来的关键在于如何有效利用AI,而非单纯依赖。
作者分享了软件开发的学习历程,强调代码整洁和设计原则的重要性。他通过阅读《代码整洁之道》和《软件设计哲学》等书籍,逐步理解提高代码可读性和降低复杂性的方法。他呼吁开发者关注系统复杂性,倡导在代码评审中加强交流,期望大家能编写整洁、易维护的代码。
本文结合京东和Google的经验,强调代码评审的重要性。代码评审提高代码质量,发现问题,促进知识共享。评审者和开发者需遵循指南,关注设计、可读性和稳定性。小型CL提高效率,减少缺陷。团队应定期改进流程,培养学习文化,利用科技工具提升质量。代码评审是持续改进的过程,需根据实际情况调整。
代码评审存在的问题包括时间消耗大、无档期、一致性缺乏、可能遗漏错误和主观性。人为代码评审的弊端主要源于人力的局限性,如疲劳、无时间、主观偏见和认知局限。利用AI大模型进行代码评审可以提高效率、减少错误、保障一致性、提供即时反馈和促进知识共享。实践步骤包括接入大模型、内置AI Review脚本、搭建CI流水线和配置coding。达成效果包括提升人效、降低成本、缩短需求交付周期和提高过程质量。AI Code Review机制通过自动化评审代码,提升研发效率和代码质量,优化用户体验和提升需求交付速率。
完成下面两步后,将自动完成登录并继续当前操作。